FAPL yöntemi, sinematik video üretiminde MLLM gizli temsillerinin etkin kullanımını hedefler. Dondurulmuş MLLM ile DiT eğitimi ve faktör bazlı öğrenme sinyalleri kullanarak karakter, sahne ve kamera kontrolü sağlar. Üç farklı video üretim görevinde taban çizgilerden daha iyi performans gösterdiği raporlanmıştır.
ID-TAP, test zamanı kişiselleştirme için bilgi yönlü düello bandit çerçevesi sunar. Sinirsel fayda modeli ve Bradley-Terry keşifçisi, büyük persona uzaylarında hızlı uyarlama sağlar. Yedi benchmark'ta on tur bütçede en iyi toplam performansı gösterir.
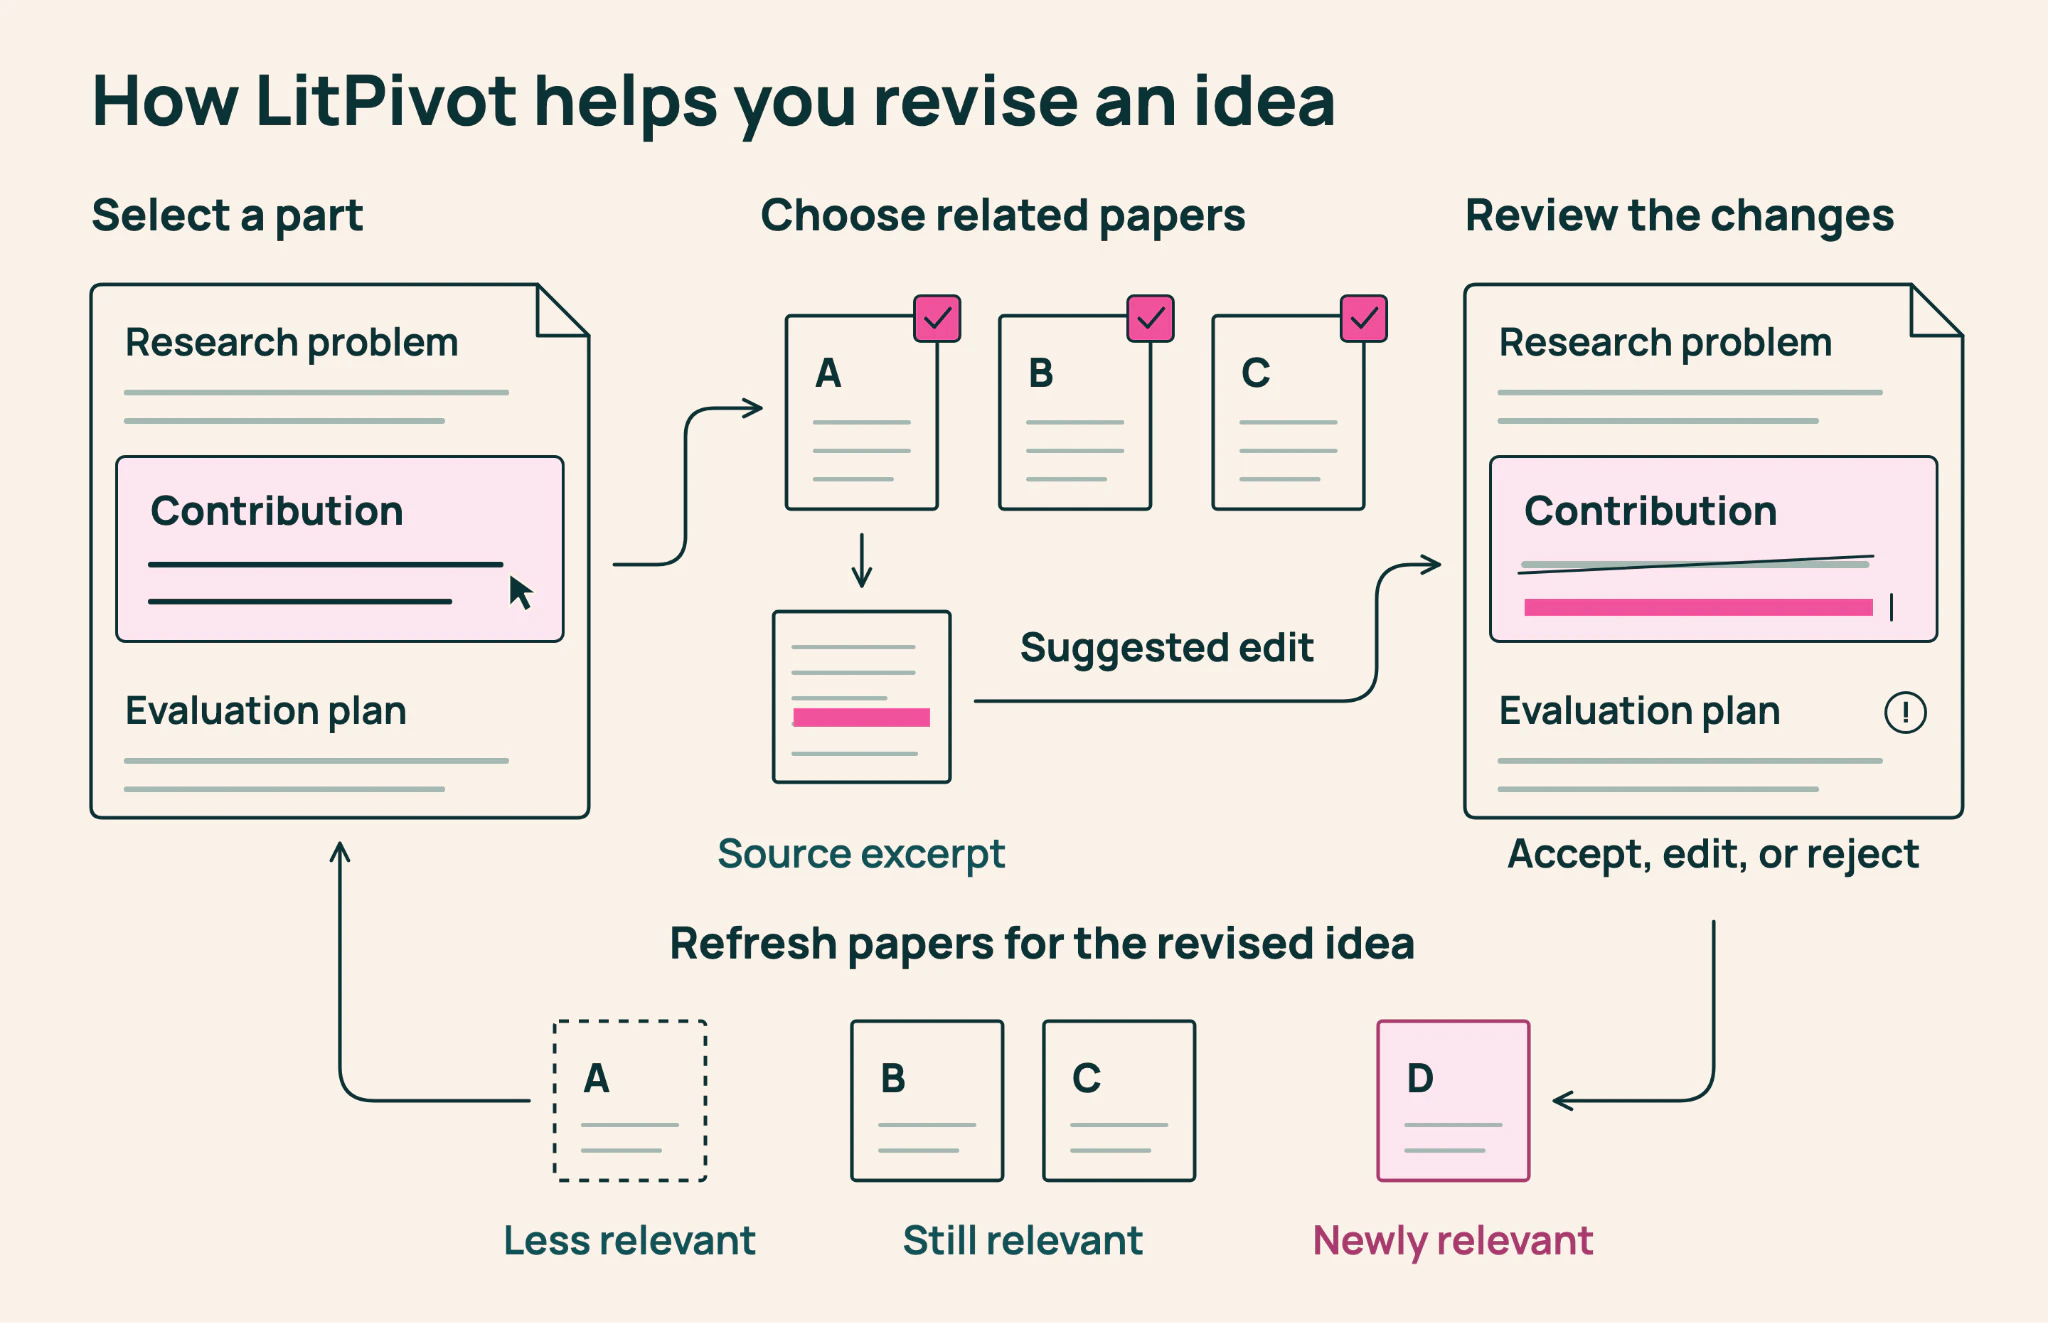
Ai2 ve University of Pennsylvania iş birliğiyle geliştirilen LitPivot, araştırmacıların fikirlerini literatürle dinamik olarak hizalamasına yardımcı olan bir sistemdir. Araştırmacılar, önerilerinin belirli bölümlerini seçerek ilgili makaleleri filtreleyebilir ve desteklenen eleştirilerle revizyon yapabilir. 17 araştırmacılı bir çalışmada, LitPivot ile geliştirilen fikirler, standart araçlara kıyasla literatüre daha iyi dayalı ve daha özgün bulundu. Sistem, UIST 2026'da sunulacak.
HyperDrone, HyperLux ışın izleme motorunu kullanan ve tüketici GPU'larında milyonlarca FPS hızına ulaşan ultra hızlı bir quadrotor simülatörüdür. Araştırma, simülasyonda eğitilen bir politikanın gerçek bir Crazyflie drone'a aktarıldığını göstererek simülasyondan gerçekliğe geçişte önemli bir hızlanma sağlar.
AWS, TorchNeuron aracılığıyla Hugging Face Hub'daki modellerin Trainium donanımında çalışıp çalışmadığını gösteren bir sorgulama aracı yayınladı. Bu araç, modellerin hangi çekirdeklere dağıtıldığını ve çalıştırma betiklerini sunar. Testler, modellerin 4 Trainium2 cihazına sığması ve 32 token üretmesiyle sınırlıdır.
SEAM, düşük kaynaklı metinden sese modellerde sözlük genişletme sorununu çözmek için ses verisi gerektirmeyen bir başlatma yöntemi sunar. Spektral filtre ve sırt regresyonu kullanarak yeni gömme vektörleri oluşturur. Üç dil ve iki mimari üzerinde test edilen yöntem, temel performansları yakalar ve eğitim verisi ihtiyacını dörtte bire düşürür.
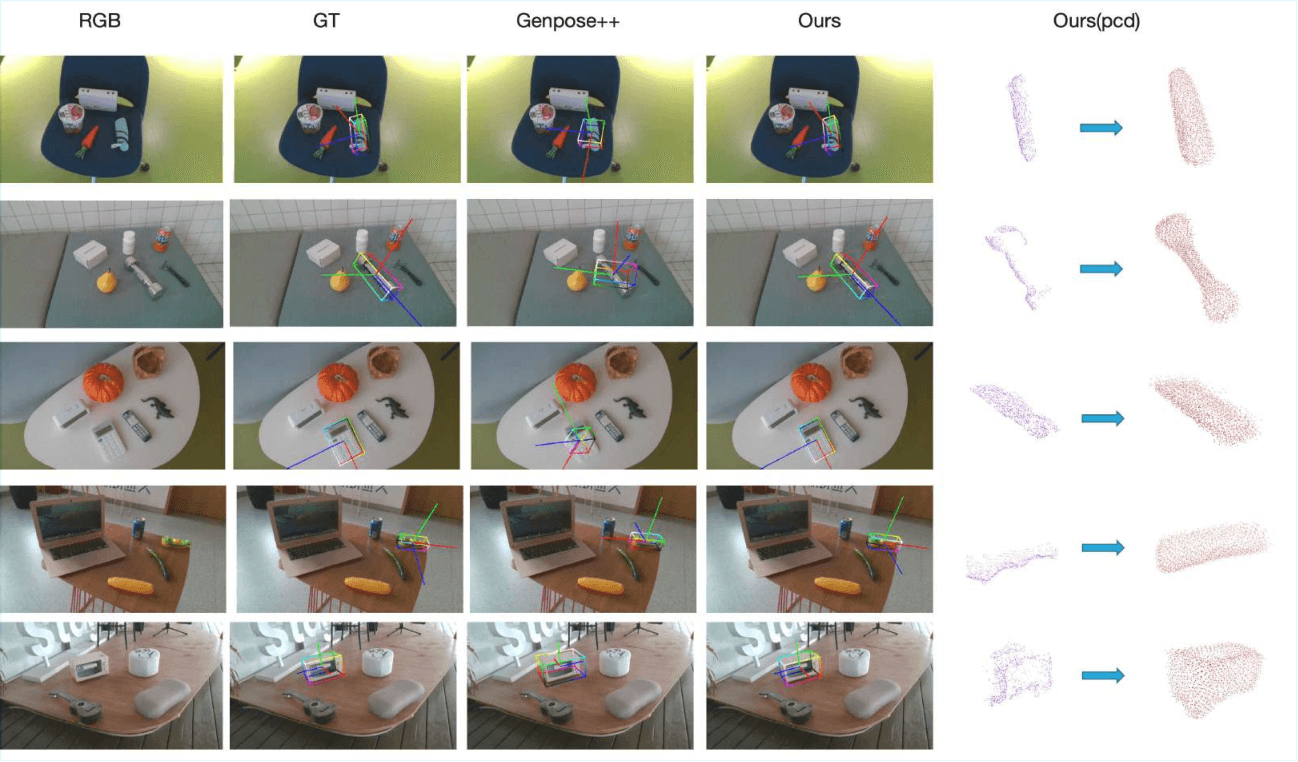
F2G-Pose, RGB-D görüntülerden nesne pozunu CAD modeli olmadan tahmin eden, gerçek zamanlı çalışan yeni bir derin öğrenme çerçevesidir. Yöntem, görsel temel özellikleri nokta bulutlarına aktararak DGCNN ve Mixture-of-Experts Transformer ile geometriyi kodlar. SOPE ve ROPE üzerinde en iyi doğruluğu sağlarken 28 FPS hızında çalışır.
IQuest-Q1, 320B toplam ve 15B aktif parametreye sahip seyrek MoE mimarili bir ajan temel modelidir. Stable SplitNorm, Muon ve muP tekniklerini kullanan üç aşamalı eğitim süreciyle geliştirilmiştir. Model, kodlama ve genel görevlerde yetkinlik gösterir ve topluluk araştırması için açık kaynak olarak yayımlanmıştır.
SplatLab, 3d gaussian splatting alanında otonom bilimsel keşif için tasarlanmış bir sistemdir. Yayınlanmış bir makaleyi yeniden üretir, bir uzantı önerir, mip-nerf 360 ve llff üzerinde eğitir ve ablatasyon yapar. Her raporlanan sayı, loglanmış bir eğitim çalışmasına bağlanır. Sistem, psnr hedefli çalışmalarda yeniden üretilen hedeflerden +0.18 ile +3.78 db daha iyi sonuçlar elde eder.
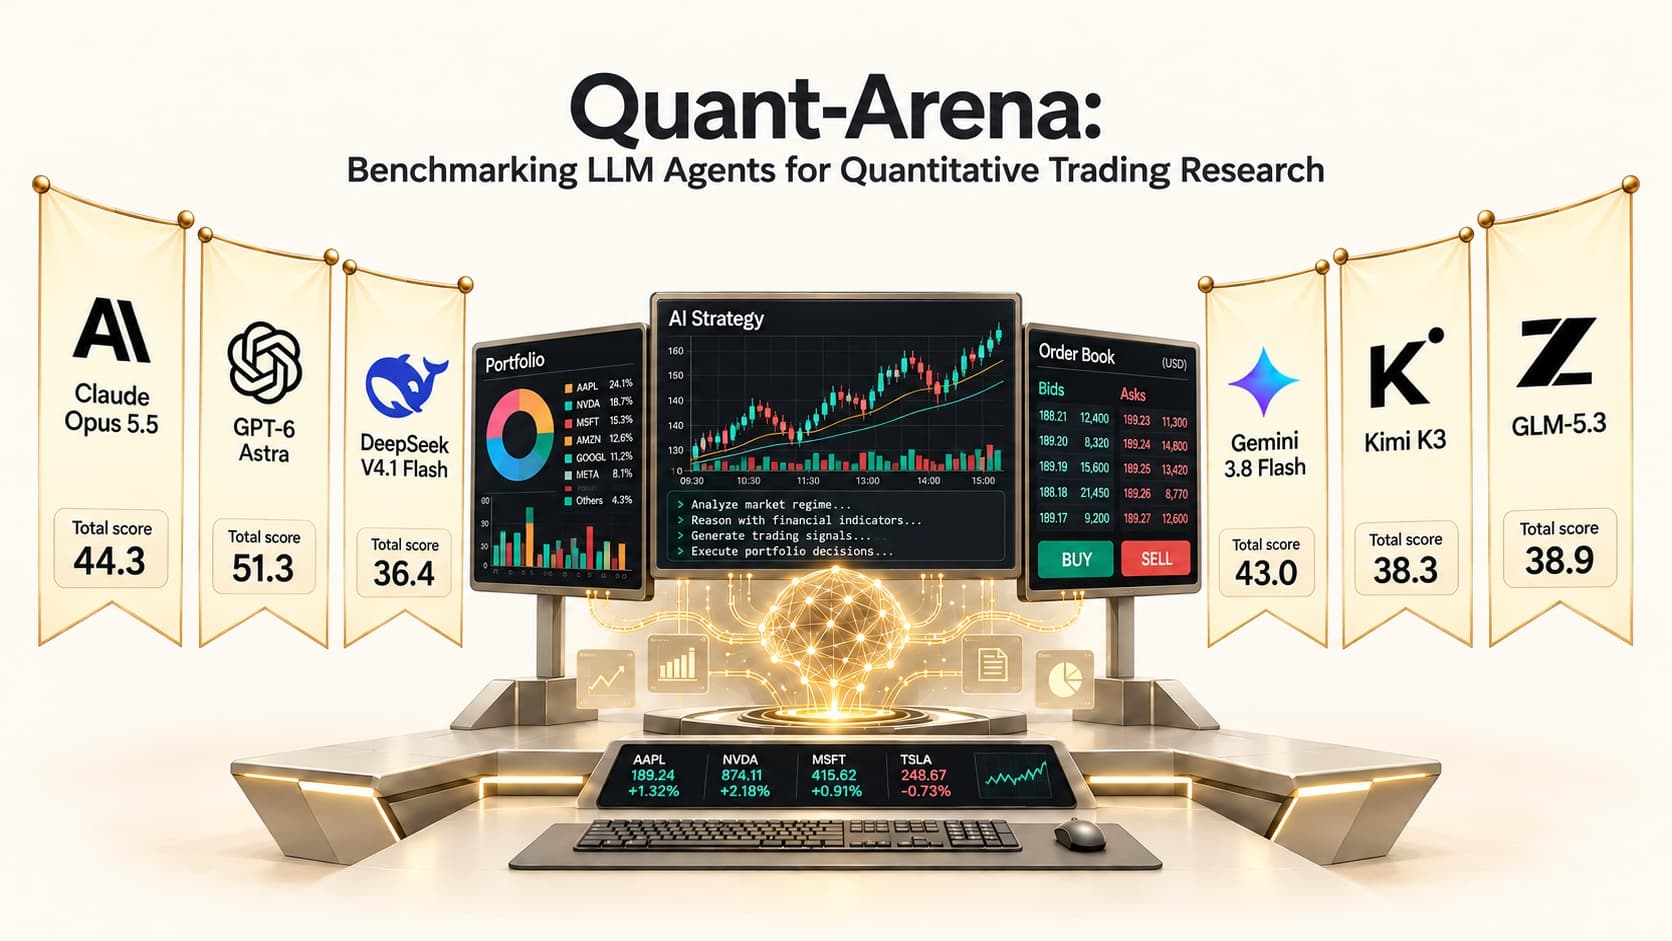
Quant-Arena, büyük dil modellerinin gerçek A-hisse verileri üzerinde uçtan uca nicel ticaret araştırması yapma yeteneğini ölçen yeni bir benchmark ve liderlik tablosudur. Sistem, modellerin 2022-2023 verileriyle strateji geliştirmesini ve bunu 2024'te test etmesini sağlar. Dokuz model arasında GPT-6 Astra öne çıksa da, hiçbir model 2024'te eşit ağırlıklı piyasa getirisini geçememiştir.
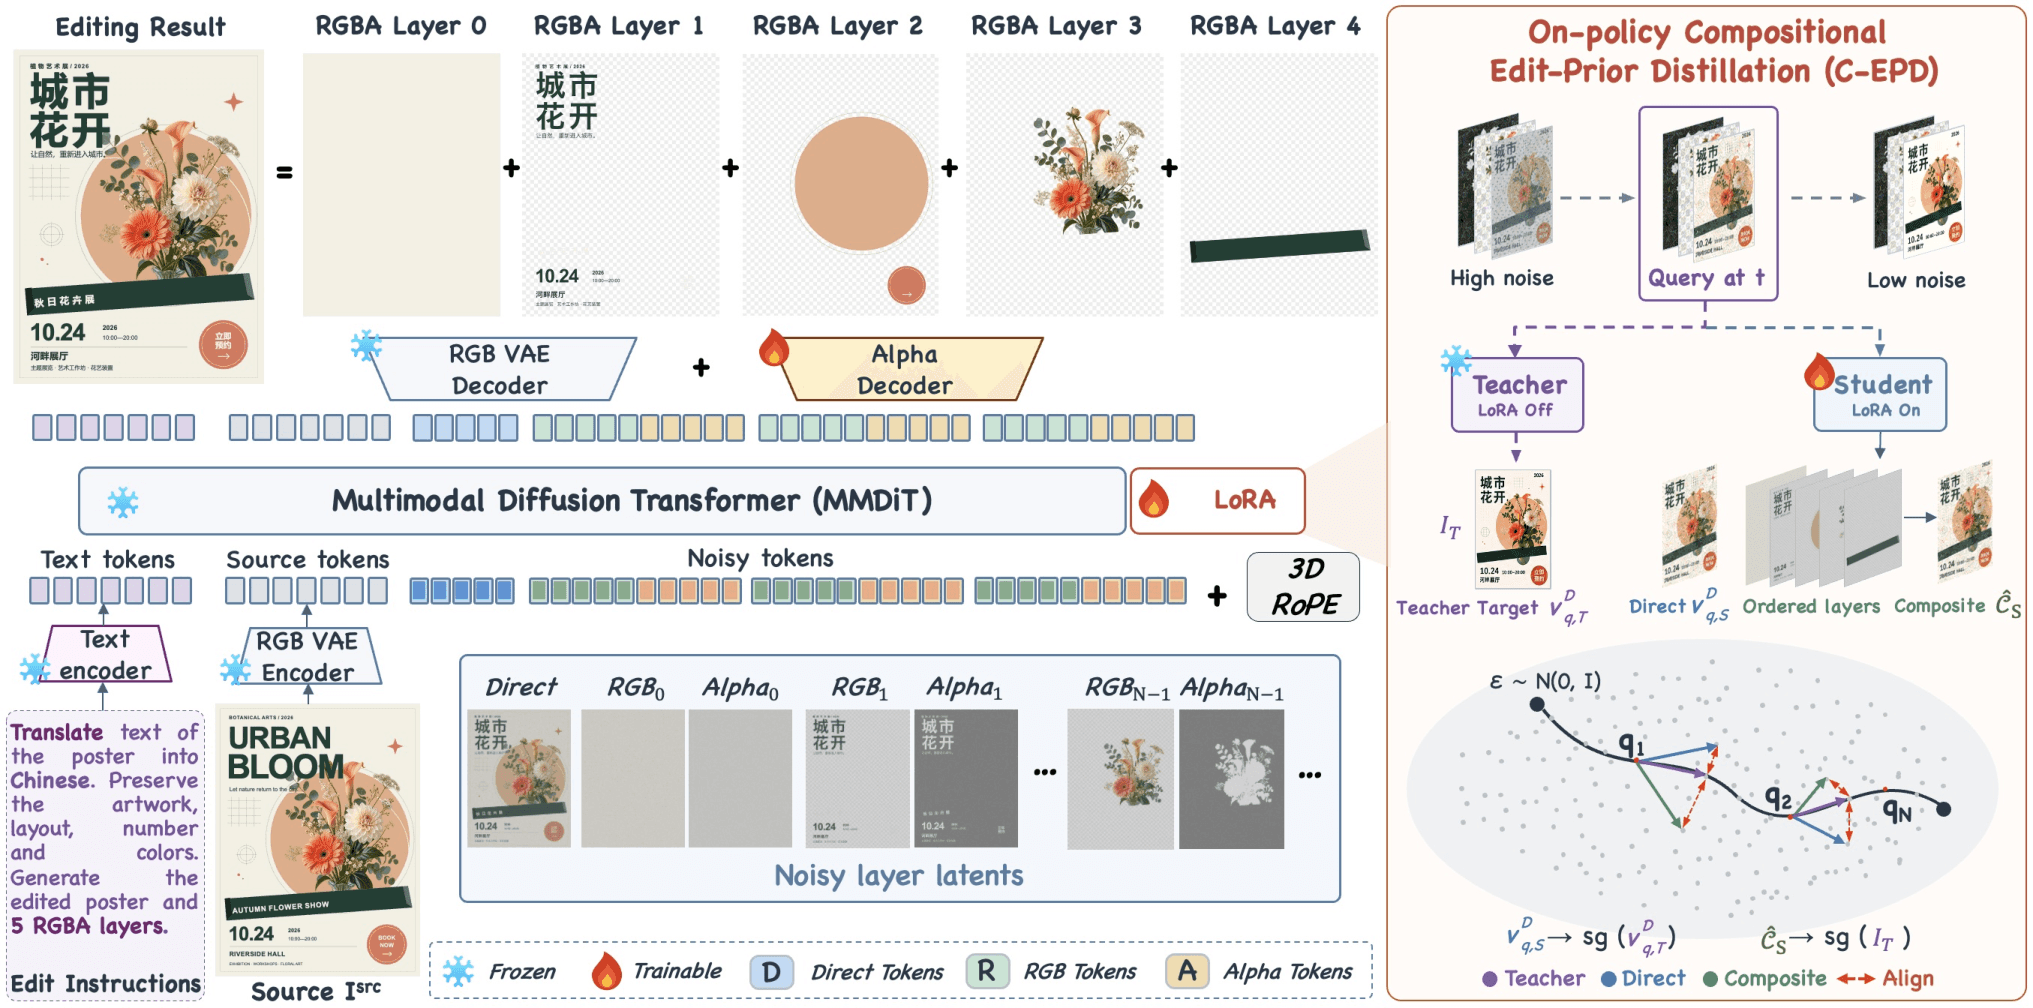
LayerEditor, talimatla yönlendirilen görüntü düzenlemesini ve yeniden kullanılabilir RGBA katmanlarının üretilebilirliğini birleştiren yeni bir çerçevedir. In-Context RGB-Alpha Token Modeling, düzenlenmiş tuvali ve sıralı RGB-Alpha katmanlarını tek bir token dizisinde temsil eder. Compositional Edit-Prior Distillation, önceden eğitilmiş modelin düzenleme yeteneğini korur. LayerEditor-100K, sıralı RGBA katman anotasyonlarına sahip büyük ölçekli bir veri setidir.
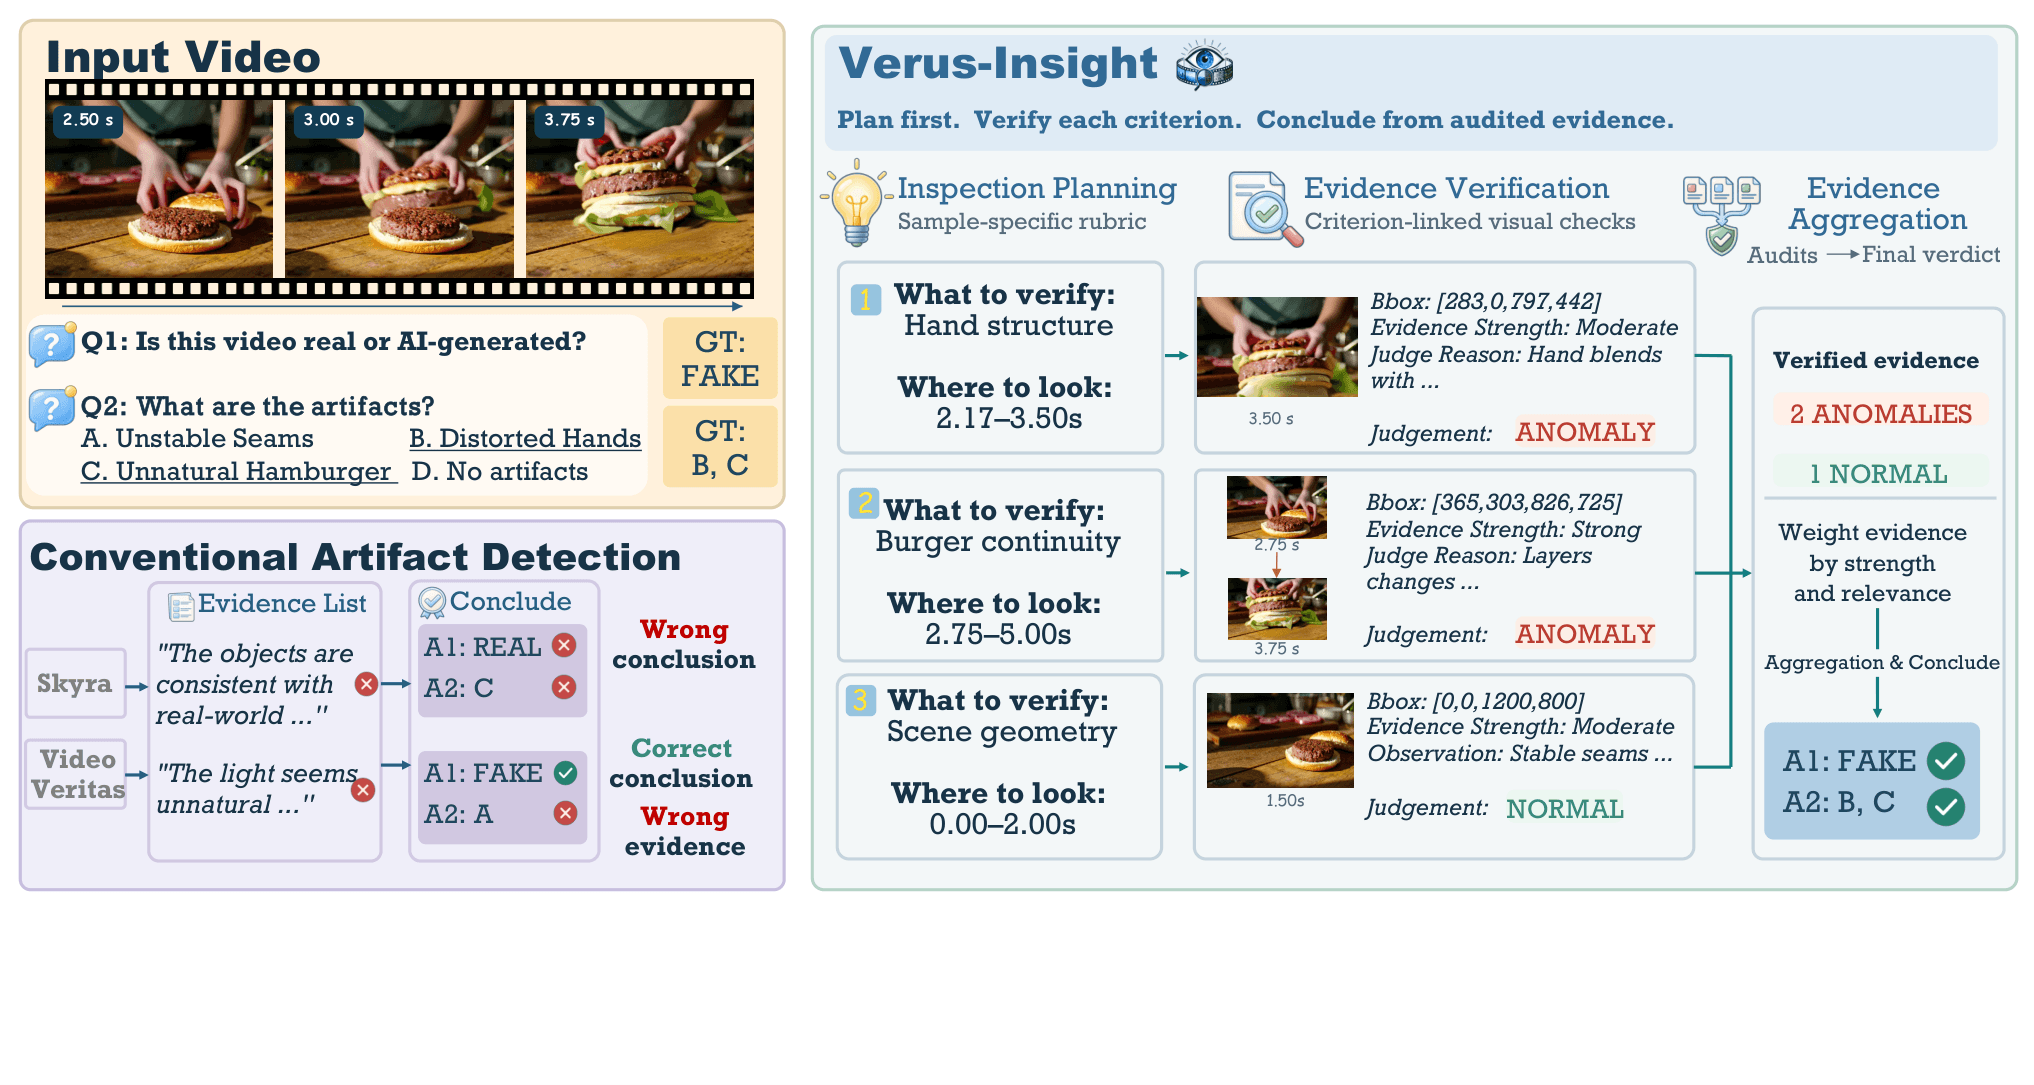
Verus-Insight, yapay zeka ile üretilen videolardaki görsel kusurları tespit etmek için tasarlanmış açıklayıcı bir modeldir. Çalışma, mevcut dedektörlerin ince detayları kaçırma sorununu çözmek amacıyla kusur algılama sürecini planlama, doğrulama ve birleştirme olarak üç temel yeteneğe ayırır. İnsan odaklı eğitim ve Verus-Bench veri setiyle desteklenen model, video kaynak doğrulamasında güvenilirlik ve şeffaflık sağlamayı hedefler.
arXiv1 dk okuma
25–36 / 121 yayın
Nasıl hazırlıyoruz?
Kaynağı belli. Sınırları açık.
Resmî duyuruları, araştırma makalelerini ve açık kaynak projelerinin sürüm notlarını yapay zekâ ile Türkçe özetliyoruz. Her haberde kaynak bağlantılarına, kullanım alanlarına ve açıklanmayan noktalara yer veriyoruz.
Doğrudan kaynak
Araştırma makalesine, model duyurusuna veya projenin deposuna haberden ulaşabilirsiniz.
Bulgular ve yorumlar
Kaynakta açıklanan sonuçları, olası kullanım alanları ve bilinmeyenlerden ayrı sunuyoruz.
Görsellerin kaynağı
Görsel ve videoların kaynağını belirtiyoruz. Konuyu anlatmak için kullanılan illüstrasyonları da işaretliyoruz.
Araştırma kaynakları
Makaleleri kendiniz keşfedin.
Yeni çalışmalar bulabileceğiniz dizinler ve araştırma laboratuvarları. Bir görsel özet ilginizi çekerse sonuçları özgün makaleden okuyun.