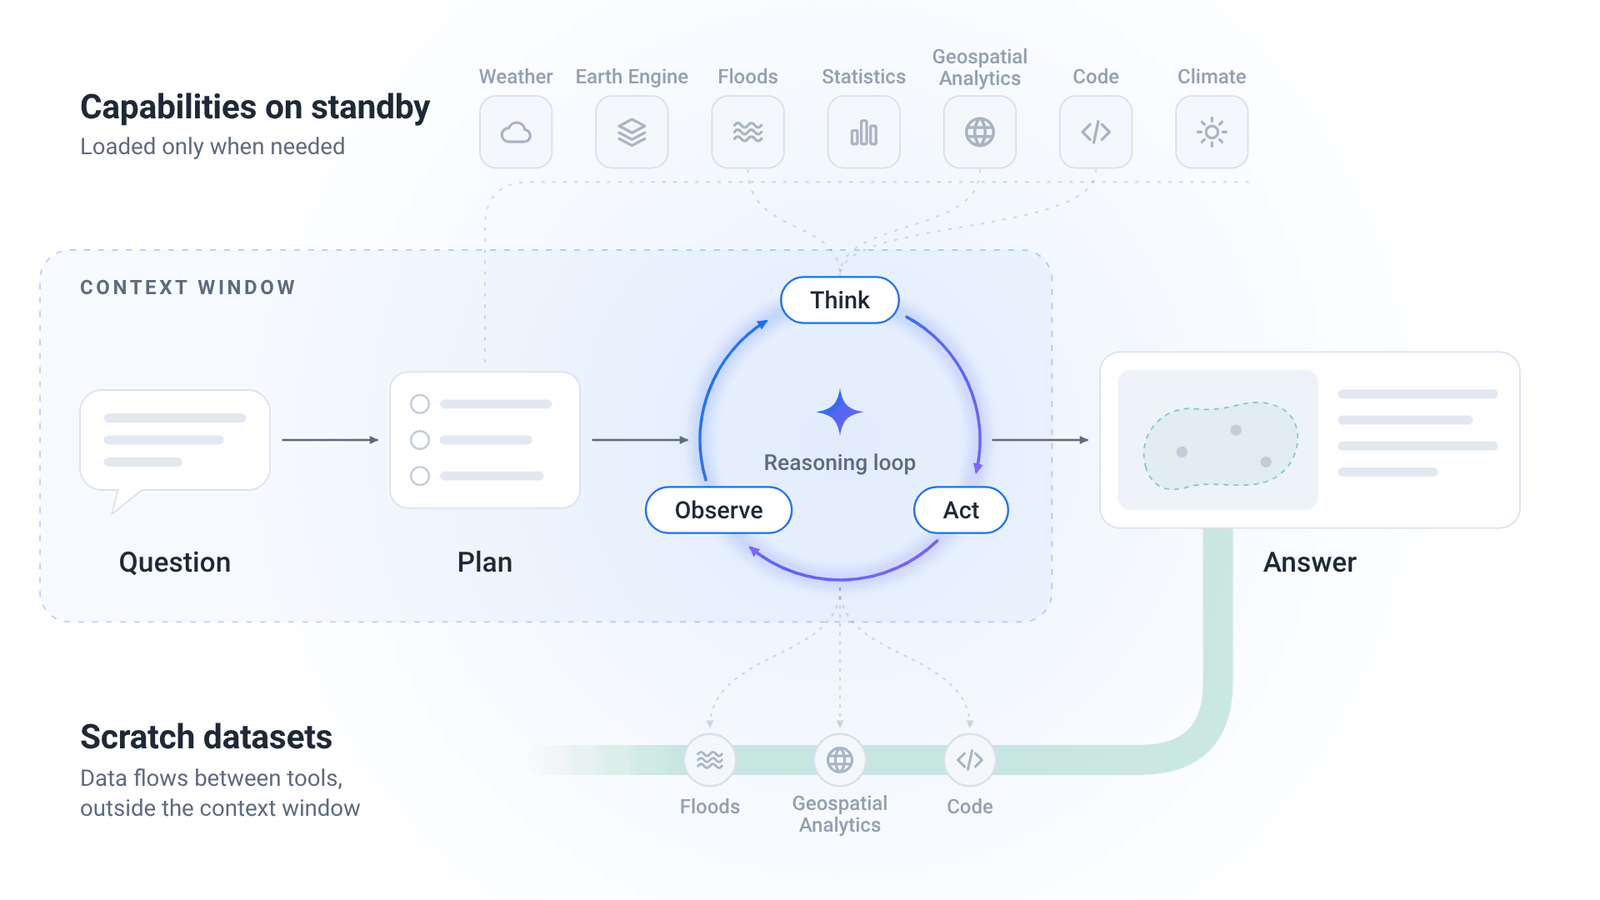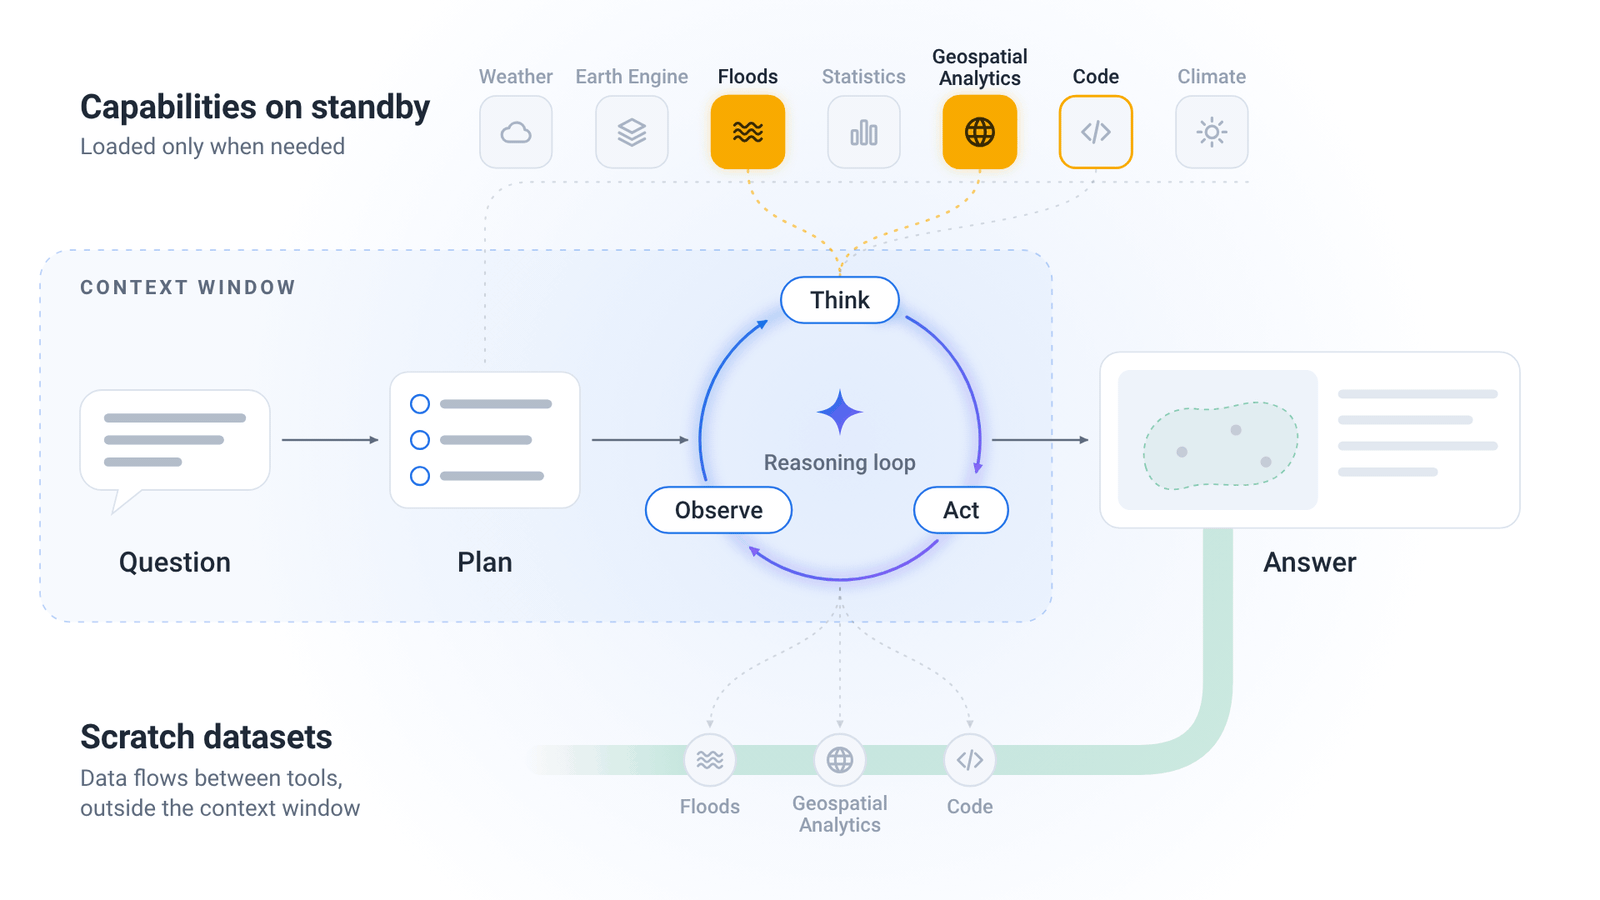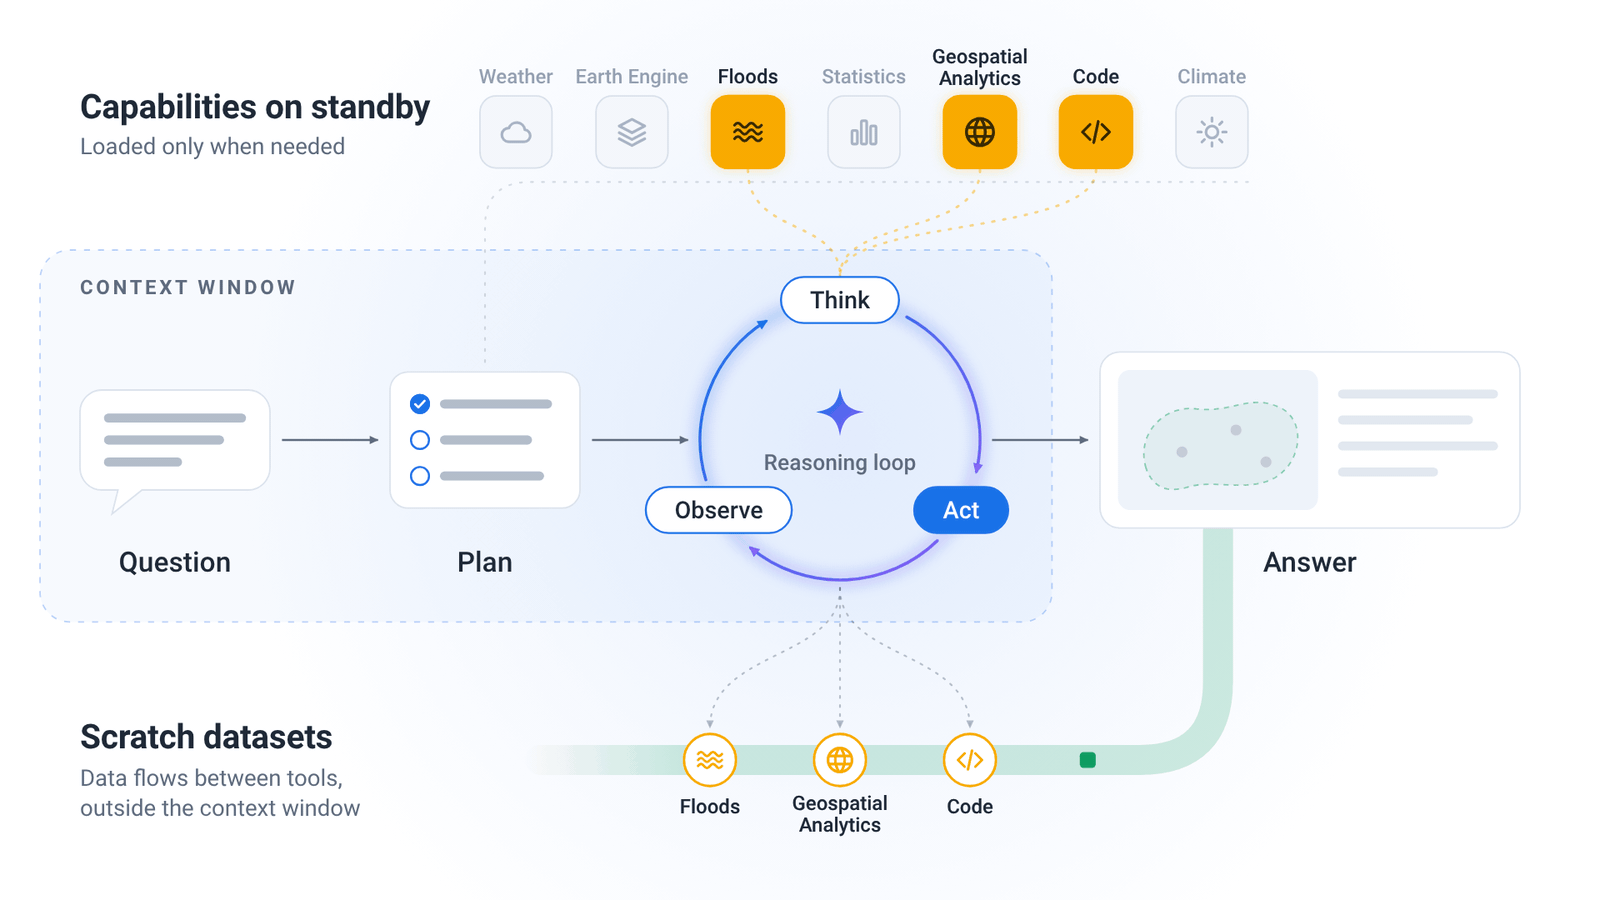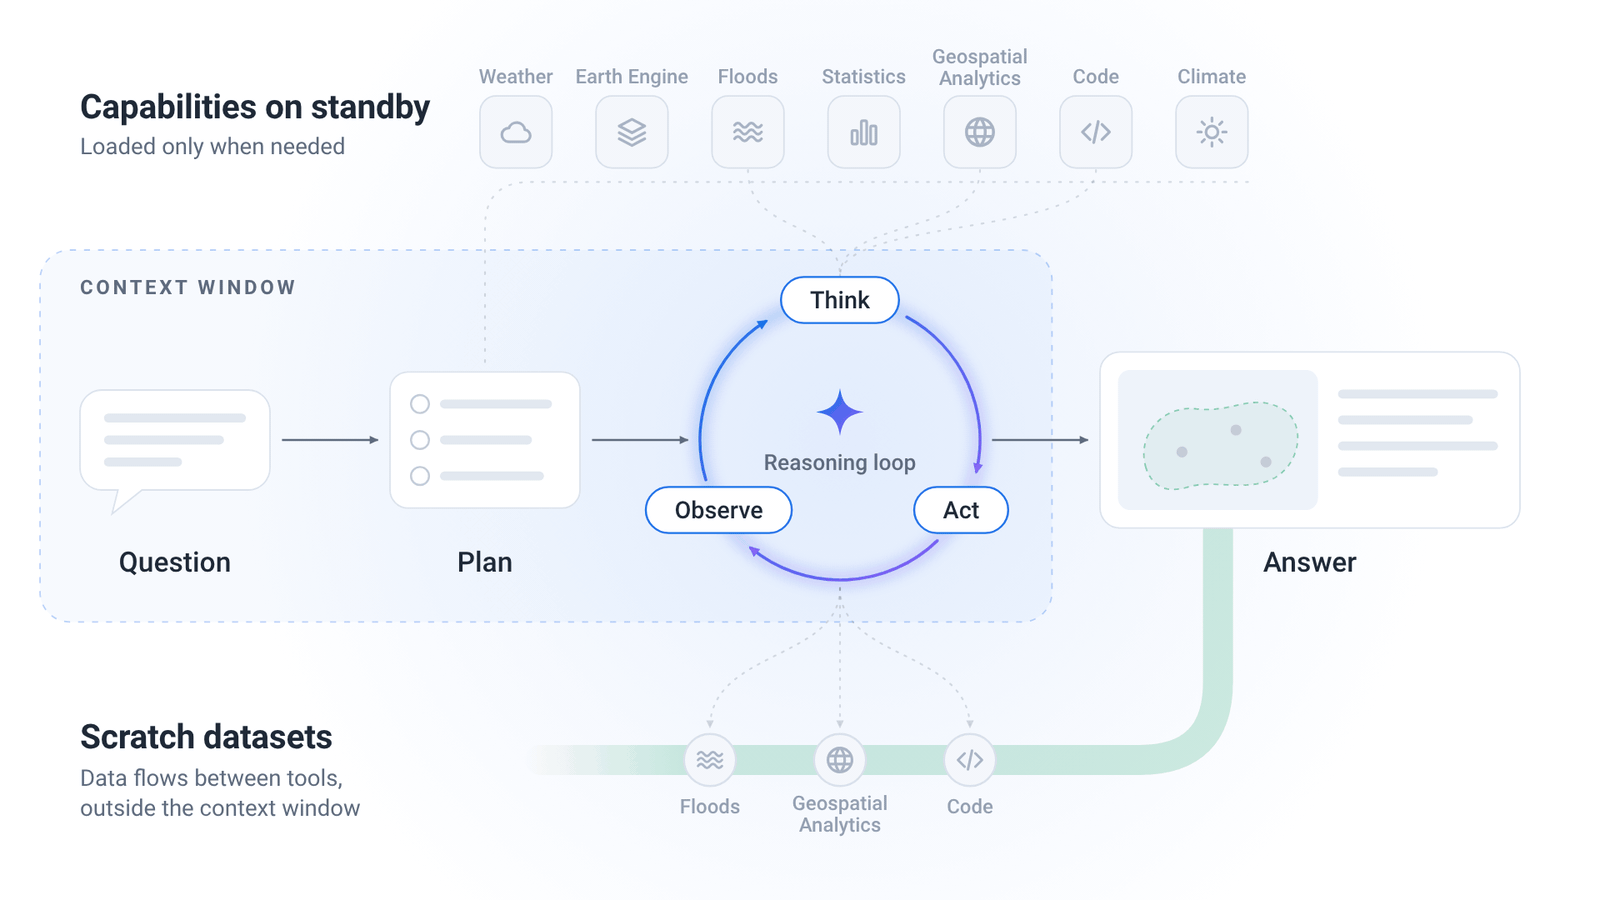
Google Research, uzamsal akıl yürütme ajanını ve Planetary Prediction Engine'i genişletti. Yeni teknik rapor, alanına özgü araçların ve planlamanın standart LLM'lere göre üstünlüğünü dört farklı ölçekte kanıtlıyor. WHO ve diğer ortaklarla yapılan deneysel testler, salgın ve afet analizlerinde haftalar süren süreçlerin dakikalara indiğini gösteriyor.
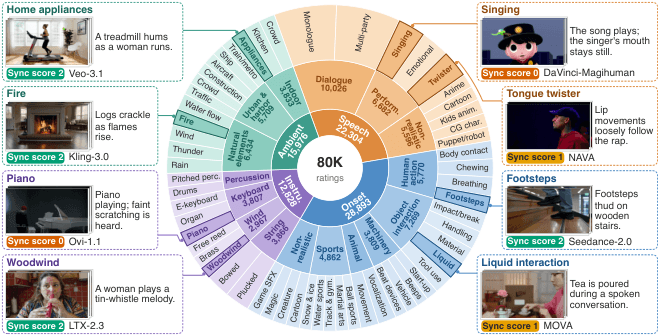
SyncReward, ses-görüntü üretimindeki senkronizasyon sorununu çözmek için insan hizalı bir ödül modeli sunuyor. Çalışma, 80K profesyonel puan içeren SyncReward-Data-80K veri seti ve 1K klipten oluşan SyncReward-Bench'i tanıtıyor. Model, semantik-zamanlayıcı karşıtlı ön eğitim ve insan denetimiyle eğitiliyor. Değerlendirme metriği olarak insan yargısıyla en yüksek uyumu sağlarken, ödül olarak pekiştirmeli öğrenme ile üretim kalitesini artırıyor.
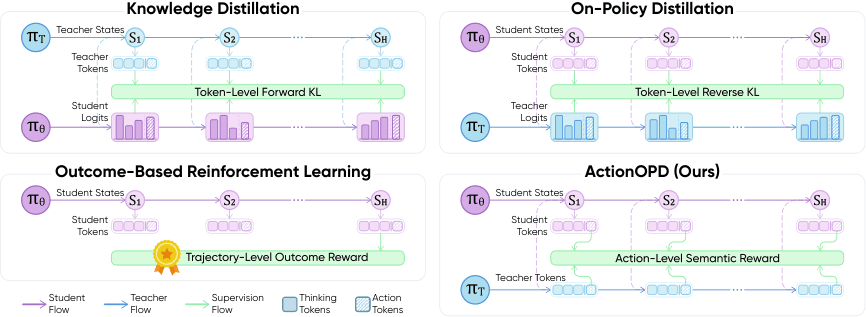
ActionOPD, dil model ajanlarını daha küçük modellere aktarırken token düzeyi yerine semantik karar düzeyinde hizalama yapan yeni bir on-policy distillation yöntemidir. Öğretmen modelin token olasılıklarına veya aynı tokenizer'a ihtiyaç duymadan, öğrenci modelin karşılaştığı durumlarda semantik uyum ödülleriyle eğitim yapar. Qwen3-4B ve Qwen3-8B modellerinde dağıtım dışı benchmark'larda ortalama 3.3-6.9 puanlık iyileşme göstermiştir.
Bu çalışma, off-policy RLVR'de token bazlı önem örneklemesini Proximal KL düzenlemesiyle birleştirir. Teorik kanıtlar, tam gelecek KL kredisinin policy gradient sapmasını ortadan kaldırdığını gösterir. Qwen3 modellerinde GRPO'ya kıyasla daha yüksek doğruluk ve kararlılık elde edilir.
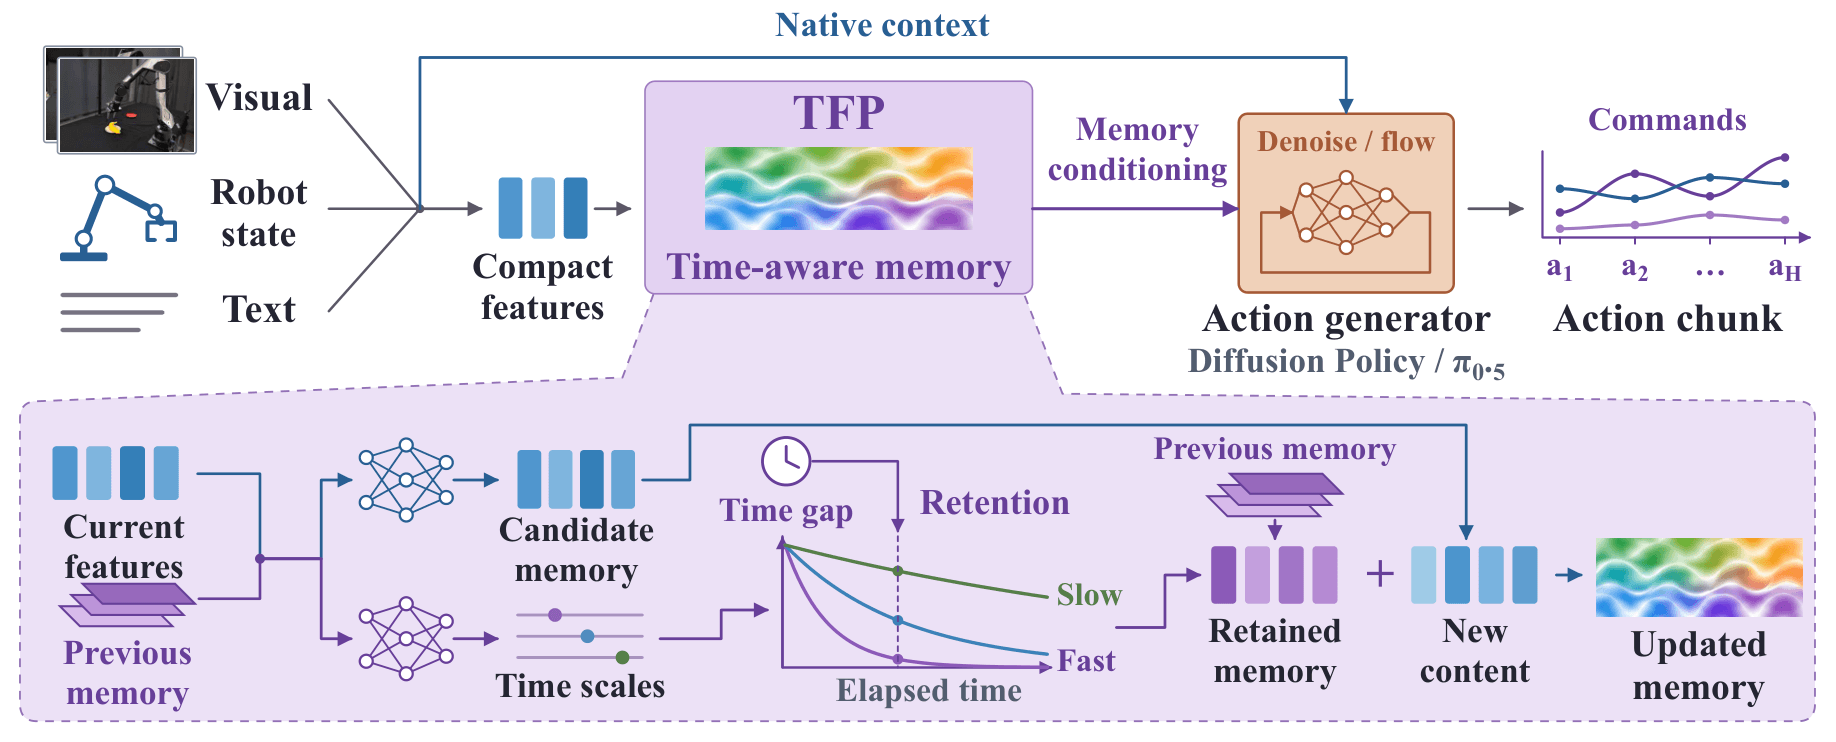
Bu çalışma, robot politika hafızalarında fiziksel zamanın eksik boyut olduğunu öne sürüyor. TFP yöntemi, hafıza dinamiklerini ölçülen zaman aralıklarına göre evriltiyor. Diffusion Policy ve π0.5 ile yapılan testlerde, zamanlama hassasiyetinin hem ölçülen aralıklara hem de saklanan geçmişe bağlı olduğu gösteriliyor. Bu yaklaşım, manipülasyon görevlerinde daha tutarlı davranışlar sağlıyor.
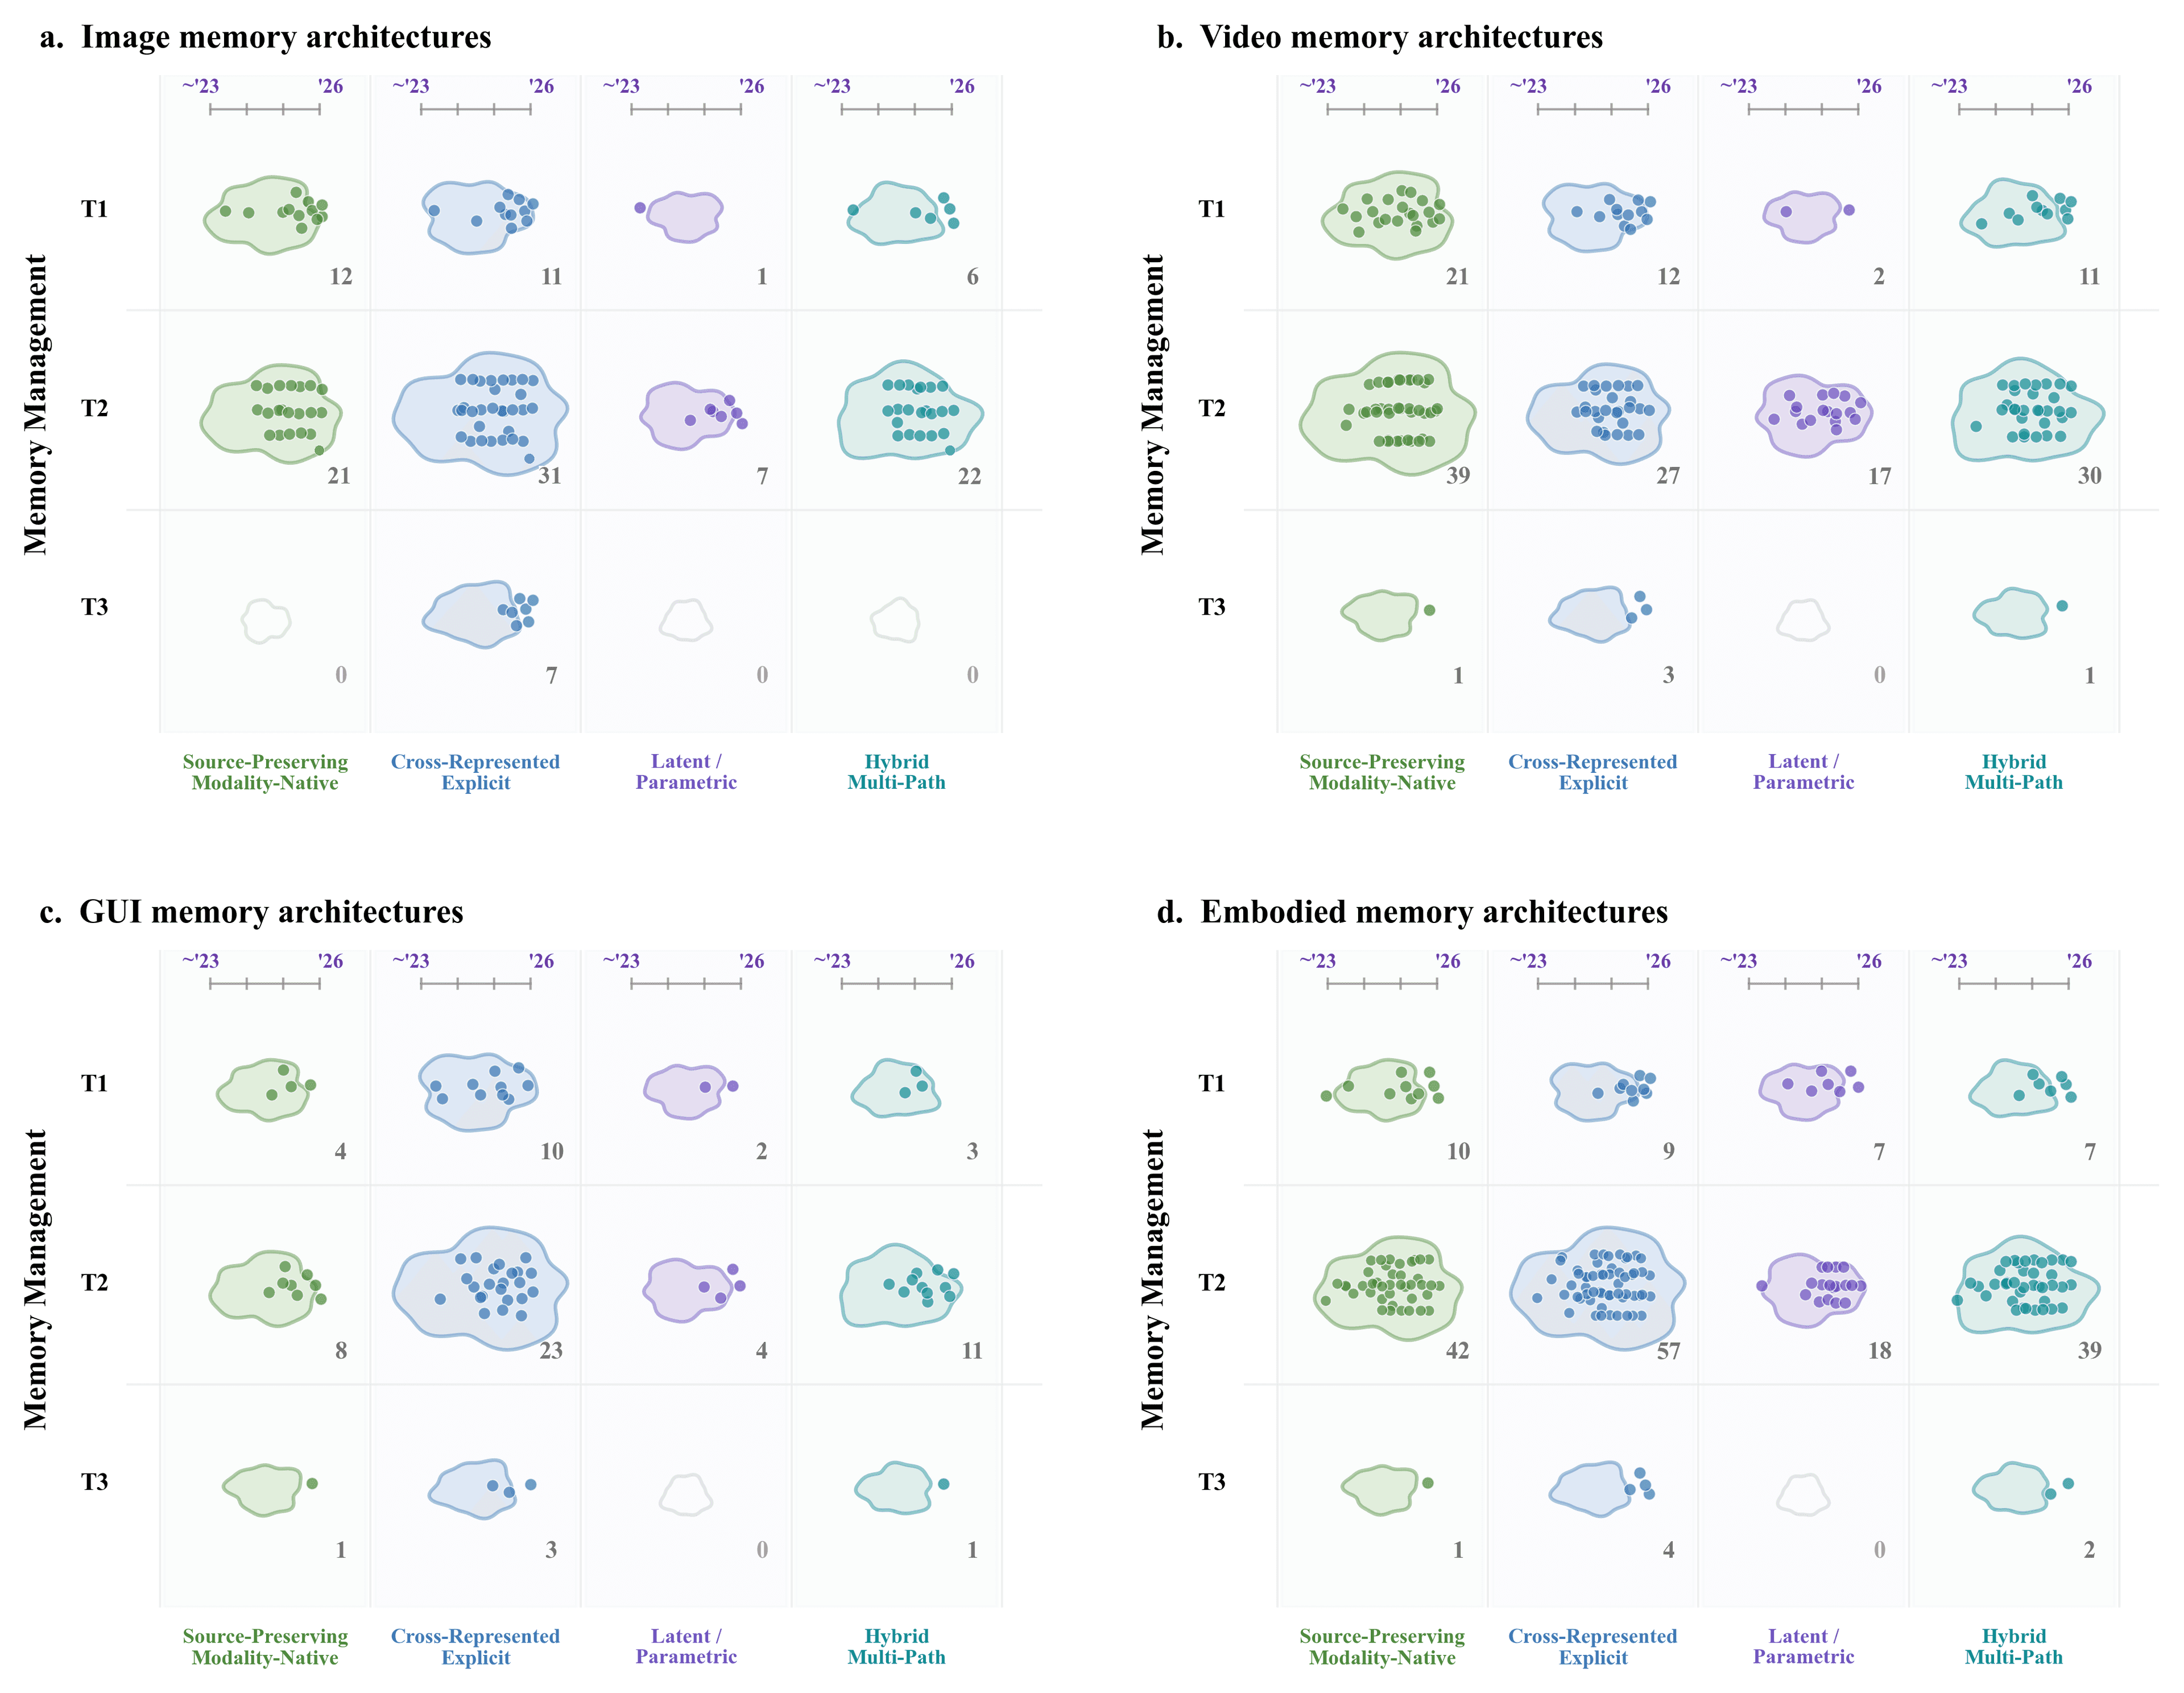
arXiv'de yayımlanan bu çalışma, çok modlu yapay zeka ajanlarının karmaşık verilerden sürekli bilgi edinme sorununu ele alıyor. Oluşturma-temsil ve hafıza yönetimi eksenlerinde iki boyutlu bir analiz çerçevesi sunarak, statik, dinamik ve kendini evrimleştiren hafıza politikalarını sınıflandırıyor.
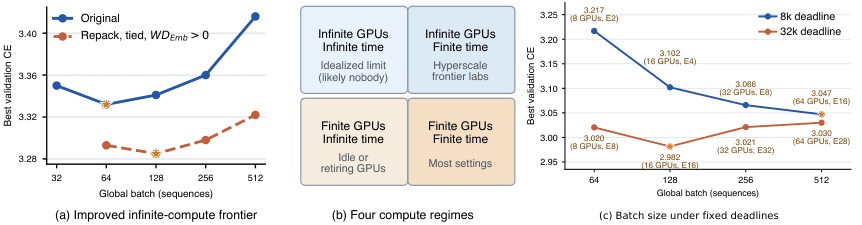
Sınırlı benzersiz veri ve bol hesaplama gücü koşullarında tekrarlı ön eğitimi inceleniyor. Parti boyutu ve epoch sayısının birlikte optimizasyonu, küçük partilerin dolaylı düzenleme etkisiyle daha iyi doğrulama kaybı sağladığını gösteriyor. GPU ve zamanın ayrı kaynaklar olarak ele alınması, geleneksel veri paralelliği pratiklerini sorgulatıyor.
Bu çalışma, LLM eğitiminde bellek verimliliğini artırmak için alt uzay optimizasyonuna kalan düzeltme çerçevesi ekler. SMRC ve PMRC algoritmaları, momentum SGD ve Muon için O(T^{-1/4}) yakınsama hızı sağlar. Çok aşamalı varyantlar, değişen baskın alt uzayı izlemek için tabanları periyodik olarak yeniden hesaplar ve aynı yakınsama sırasını korur.
Araştırma, LLM ajanlarının araç çağrılarını doğrulayan yargıç modellerinin, girdilerinde açık bir referans bulunmayan doğru değerleri reddetme eğiliminde olduğunu gösteriyor. Bu 'türetme boşluğu', varsayılan veya çıkarılan değerlerde belirginleşiyor. DeRef yöntemi, yargıç için ayrı bir referans metni oluşturarak bu sorunu azaltıyor ve doğrulama performansını artırıyor.
Görsel üretken modellerde, eğitim görüntüleri arasındaki kod uzayının açıkça denetlenmesi öneriliyor. InterpTok, bu boşlukta kalan karışımları doğal görüntülere dönüştürmek için ayrıştırıcı tabanlı bir yöntem sunuyor. Yaklaşım, interpolasyon kalitesini üç kat artırırken difüzyon modelinin FID skorunu 11.61'den 8.48'e düşürüyor.
Allen Institute for AI, HiRO-ACEv2 sistemini tanıttı. Bu sistem, 100 km çözünürlüklü ACE modelinin çıktılarını 3 km'ye indirgeyerek küresel iklim verisi üretir. Yeni HiROv2 modeli, yalnızca yağış değil; rüzgar ve basınç gibi birden fazla alanı aynı anda tahmin eder. Sistem, X-SHiELD simülasyonuna kıyasla yaklaşık 300 kat daha düşük maliyetle 10 yıllık veri üretebilir.
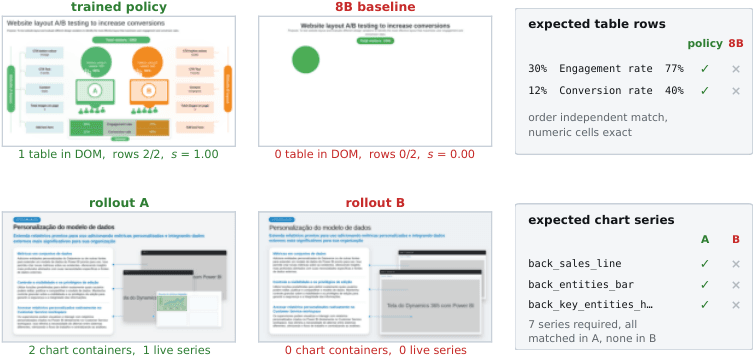
AesCode, görsel tasarım kodu üretirken içerik promptuna dayalı kod üretimi ile aynı prompttan üretilen görseli estetik rehber olarak kullanır. Tasarım grafiği üzerinden ayrıştırılabilir özellikler için deterministik doğrulayıcılar, ayrıştırılamayanlar için VLM yargıcı ile ödül üretir. Bu ayrık ödüllendirme, görsel kaliteyi ve doğrulanabilirliği birlikte artırır.
arXiv / cs.AI + cs.CL1 dk okuma
49–60 / 159 yayın
Nasıl hazırlıyoruz?
Kaynağı belli. Sınırları açık.
Resmî duyuruları, araştırma makalelerini ve açık kaynak projelerinin sürüm notlarını yapay zekâ ile Türkçe özetliyoruz. Her haberde kaynak bağlantılarına, kullanım alanlarına ve açıklanmayan noktalara yer veriyoruz.
Doğrudan kaynak
Araştırma makalesine, model duyurusuna veya projenin deposuna haberden ulaşabilirsiniz.
Bulgular ve yorumlar
Kaynakta açıklanan sonuçları, olası kullanım alanları ve bilinmeyenlerden ayrı sunuyoruz.
Görsellerin kaynağı
Görsel ve videoların kaynağını belirtiyoruz. Konuyu anlatmak için kullanılan illüstrasyonları da işaretliyoruz.
Araştırma kaynakları
Makaleleri kendiniz keşfedin.
Yeni çalışmalar bulabileceğiniz dizinler ve araştırma laboratuvarları. Bir görsel özet ilginizi çekerse sonuçları özgün makaleden okuyun.
 Video