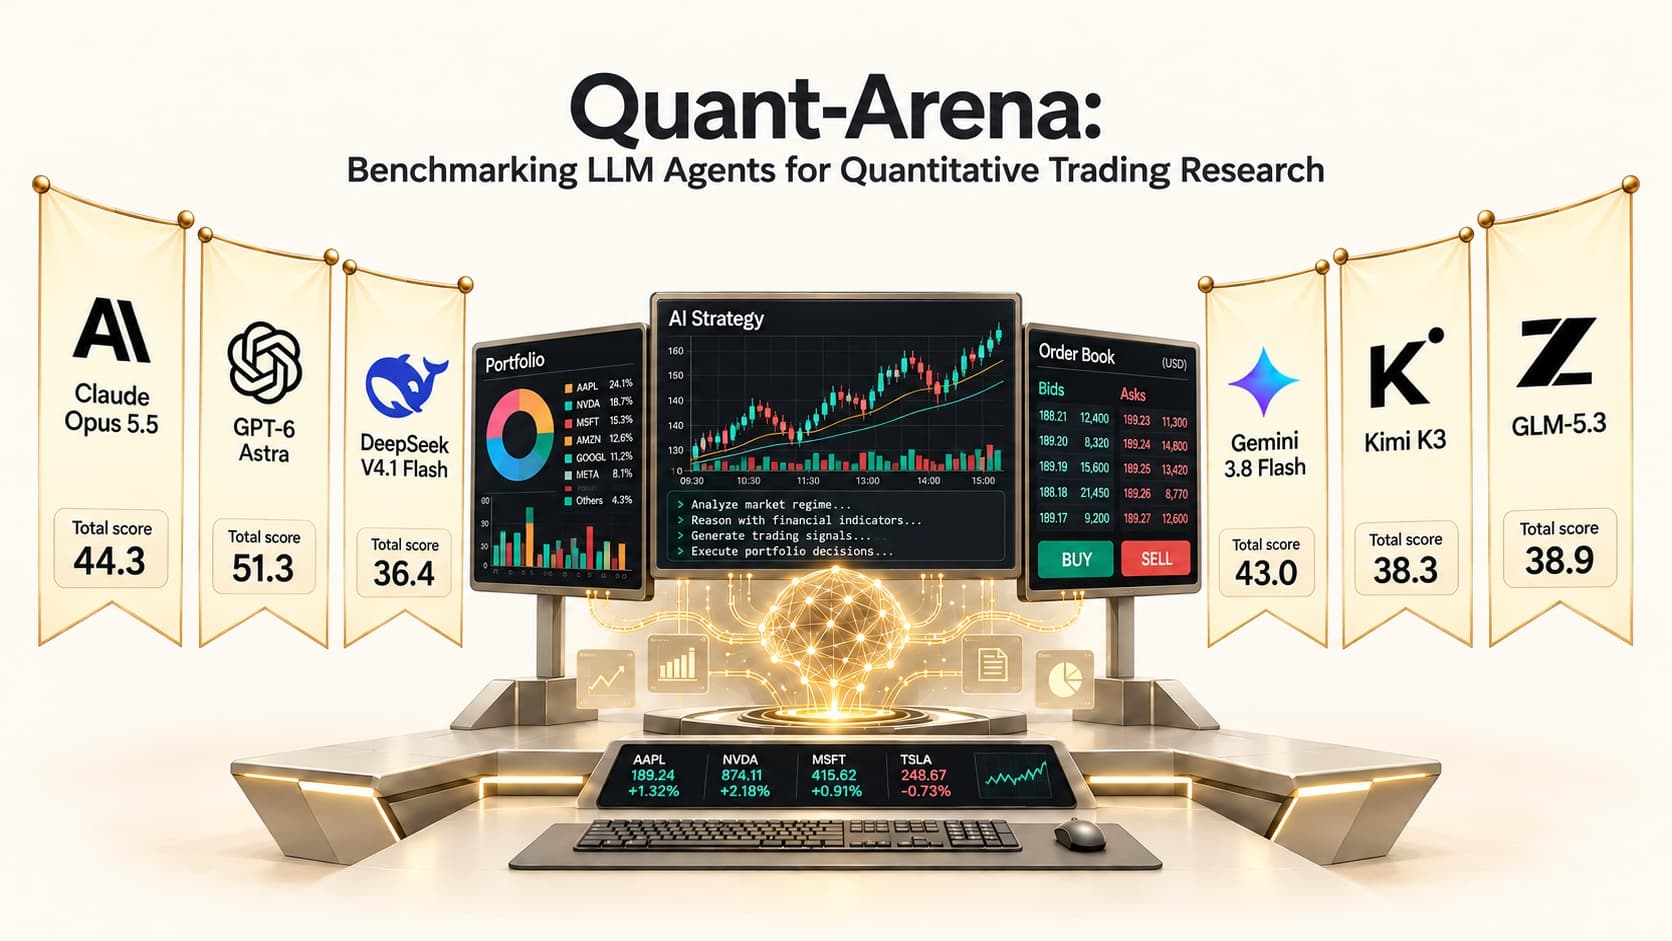
Quant-Arena, büyük dil modellerinin gerçek A-hisse verileri üzerinde uçtan uca nicel ticaret araştırması yapma yeteneğini ölçen yeni bir benchmark ve liderlik tablosudur. Sistem, modellerin 2022-2023 verileriyle strateji geliştirmesini ve bunu 2024'te test etmesini sağlar. Dokuz model arasında GPT-6 Astra öne çıksa da, hiçbir model 2024'te eşit ağırlıklı piyasa getirisini geçememiştir.
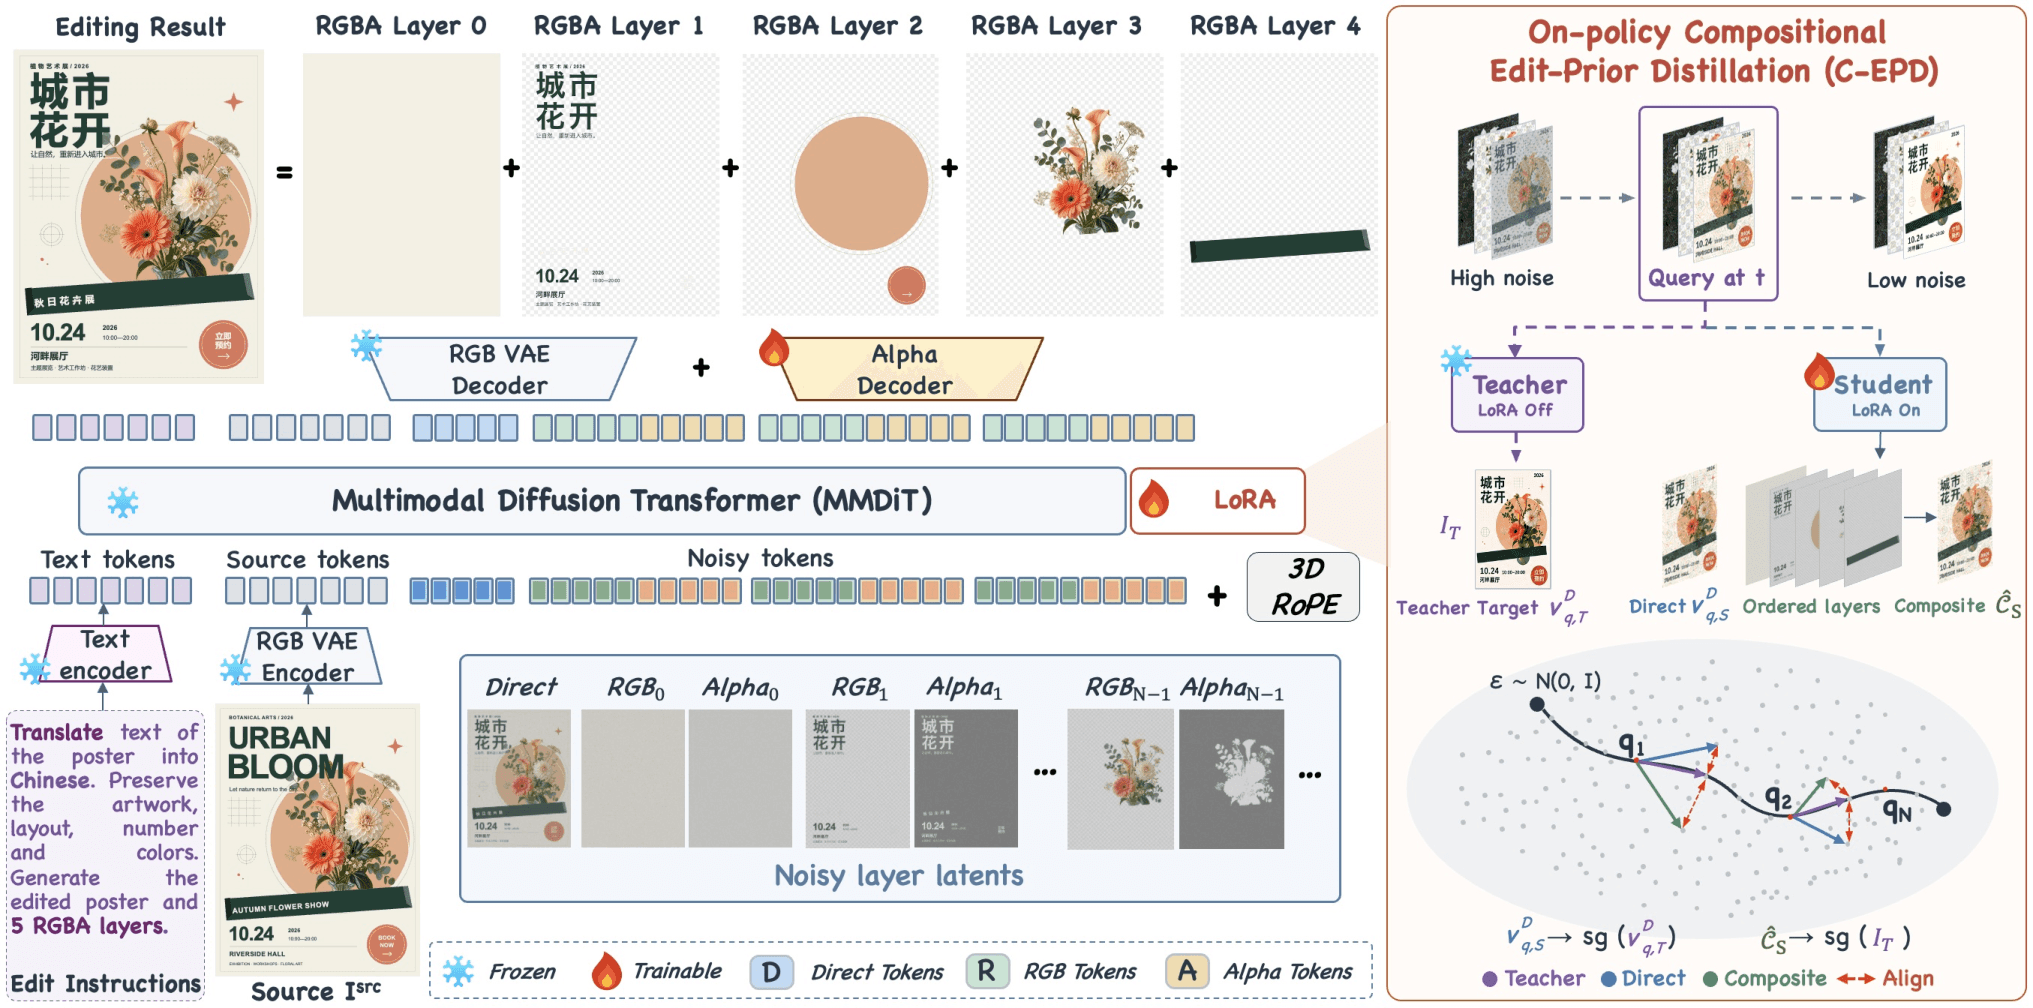
LayerEditor, talimatla yönlendirilen görüntü düzenlemesini ve yeniden kullanılabilir RGBA katmanlarının üretilebilirliğini birleştiren yeni bir çerçevedir. In-Context RGB-Alpha Token Modeling, düzenlenmiş tuvali ve sıralı RGB-Alpha katmanlarını tek bir token dizisinde temsil eder. Compositional Edit-Prior Distillation, önceden eğitilmiş modelin düzenleme yeteneğini korur. LayerEditor-100K, sıralı RGBA katman anotasyonlarına sahip büyük ölçekli bir veri setidir.
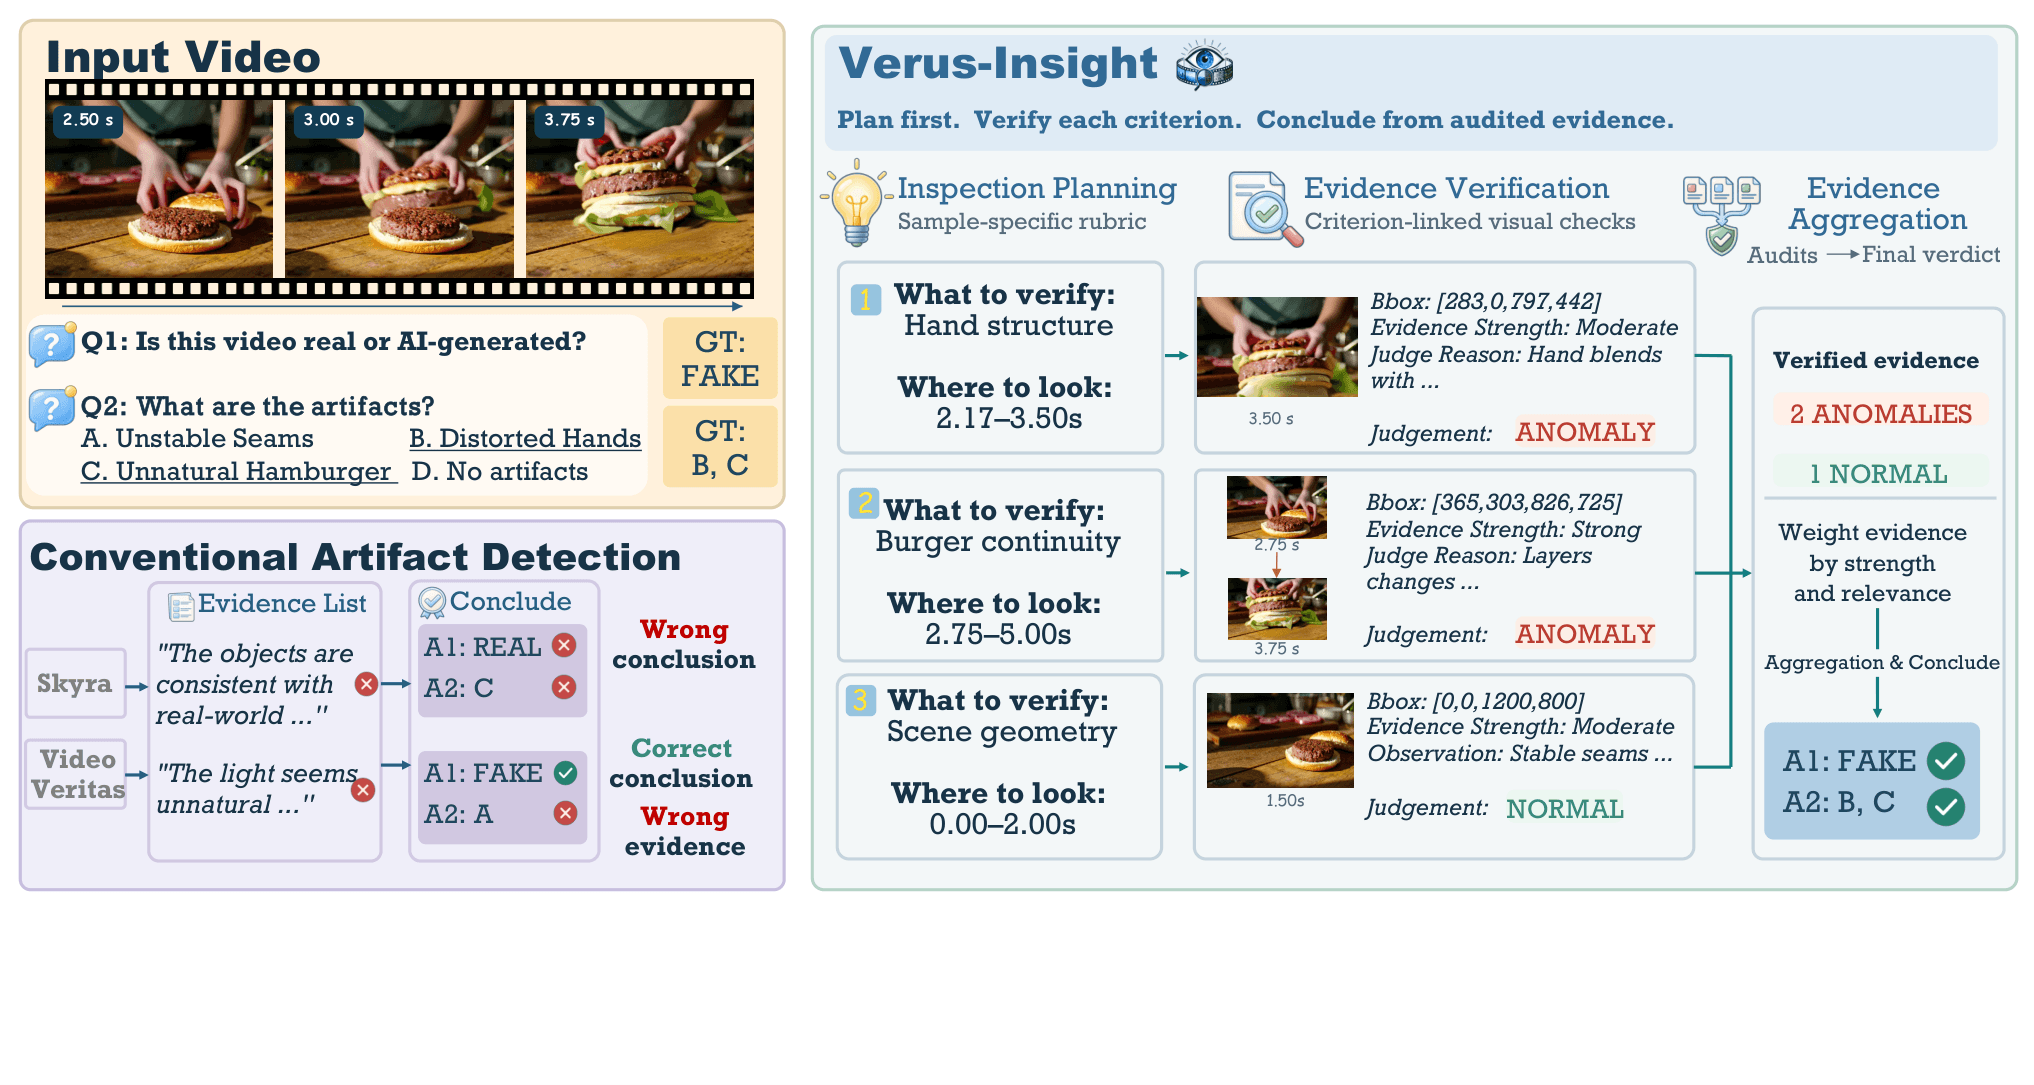
Verus-Insight, yapay zeka ile üretilen videolardaki görsel kusurları tespit etmek için tasarlanmış açıklayıcı bir modeldir. Çalışma, mevcut dedektörlerin ince detayları kaçırma sorununu çözmek amacıyla kusur algılama sürecini planlama, doğrulama ve birleştirme olarak üç temel yeteneğe ayırır. İnsan odaklı eğitim ve Verus-Bench veri setiyle desteklenen model, video kaynak doğrulamasında güvenilirlik ve şeffaflık sağlamayı hedefler.
ToM2Vec, çoklu ajan işbirliği için sürekli akıl yürütme tokenları kullanarak gizli uzayda zihin teorisi oluşturmayı hedefler. Metin tabanlı temsilin sınırlarını aşarak belirsizlik altında partner durumlarını soyutlar. Overcooked-AI ve Decrypto gibi ortamlarda taban modele göre tutarlı iyileşmeler gösterir ve eğitimde görülmemiş model ailelerine genellenir.
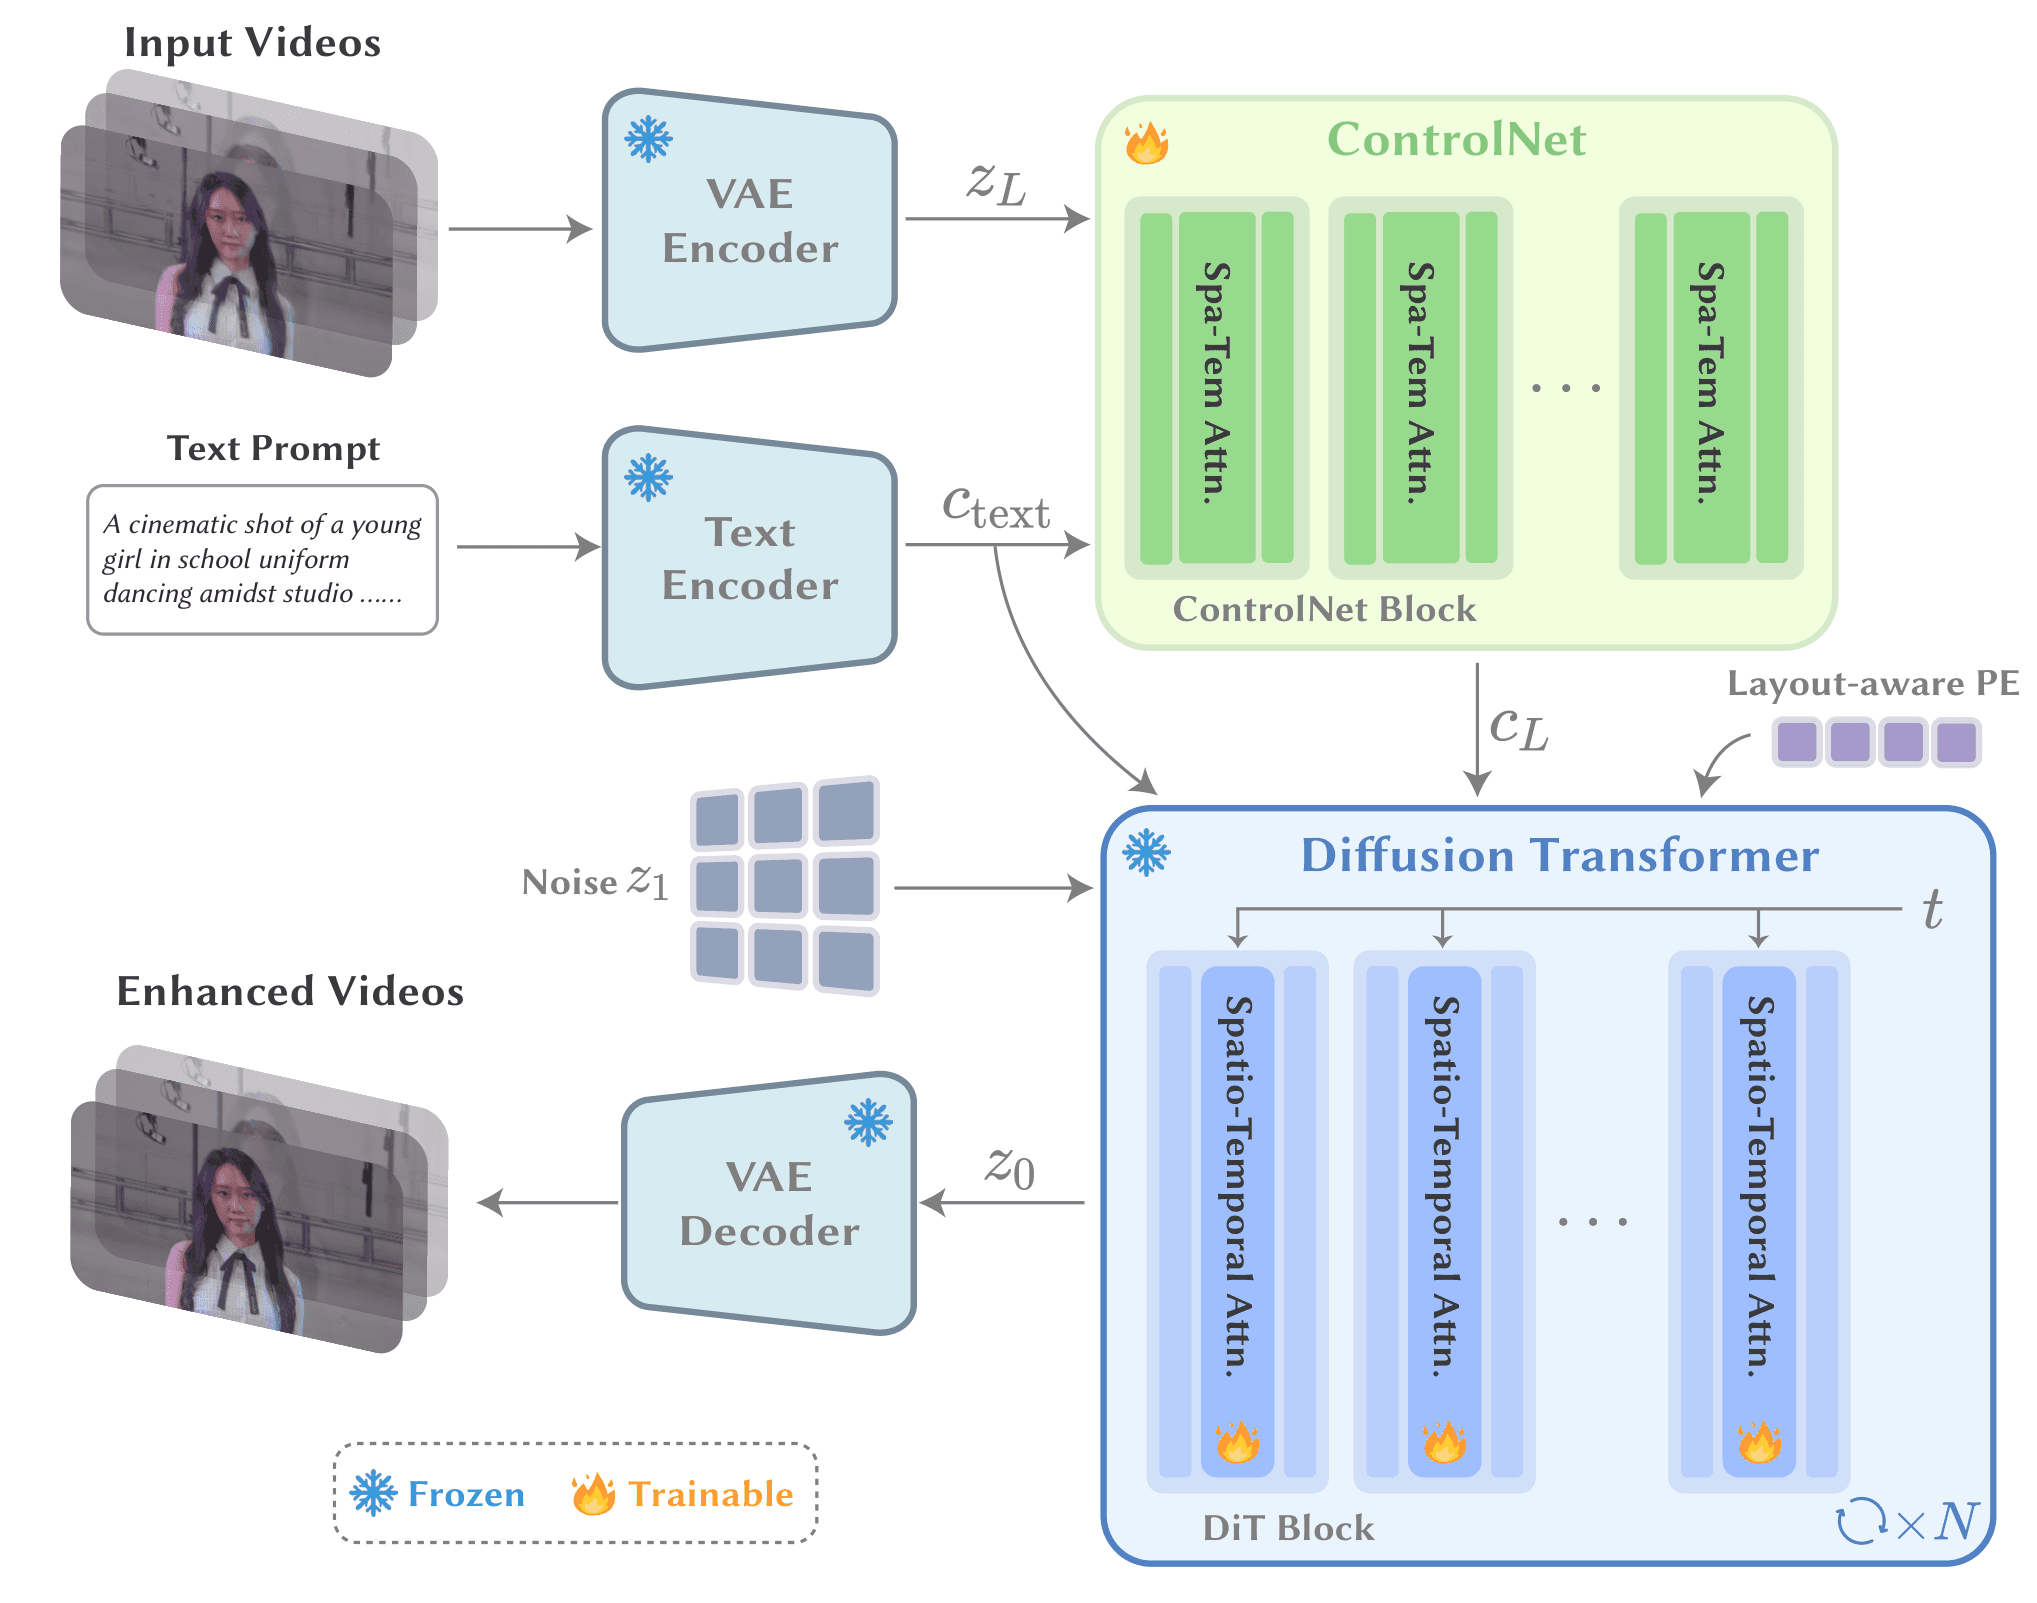
RealMe, seyrek ve düşük çözünürlüklü yakalamalardan yüksek kaliteli hacimsel video üretmek için video difüzyon modellerini kullanan bir çerçevedir. 2K çözünürlük ve 4D tutarlılık sağlayarak yoğun kamera kurulumlarına olan ihtiyacı azaltır. DNA-Rendering ve RealVV veri setlerinde mevcut yöntemlerden üstün performans gösterdiği raporlanmıştır.
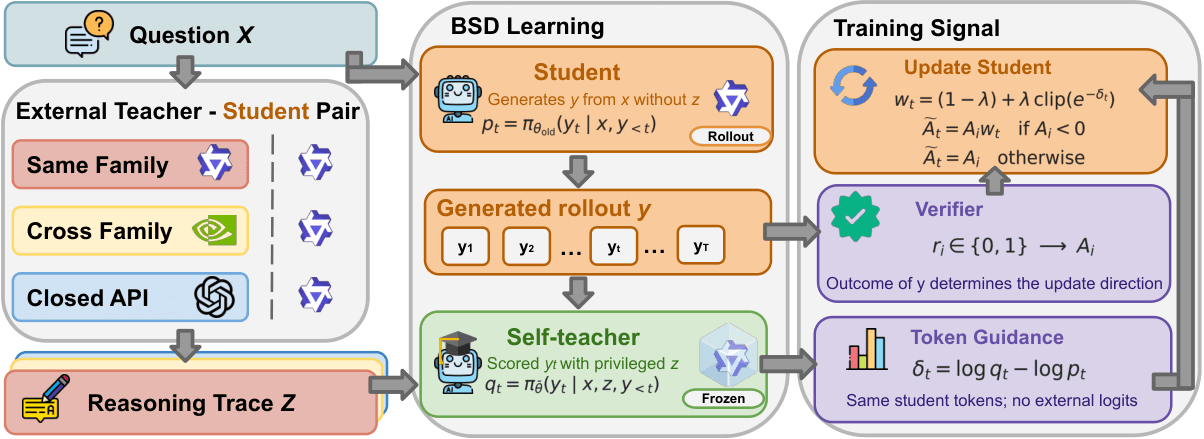
Bridged Self-Distillation (BSD), güçlü bir öğretmen modelin akıl yürütme yeteneklerini daha küçük bir öğrenci modele aktarmak için tasarlanmış yeni bir çerçevedir. Yöntem, harici öğretmenin yalnızca metin üreterek akıl yürütme izi sağlaması ve öğrencinin kendi token uzayında koşullu bir kopyasının bu izi kullanarak rollout'ları puanlaması üzerine kuruludur. Bu yaklaşım, ortak tokenizör, çapraz tokenizör ve kapalı API öğretmen senaryolarını tek bir eğitim prosedürü altında birleştirir.
Qwen-Audio-3.1-ASR, önceki sürümün üzerine inşa edilmiş, konuşma tanıma ve konuşmacı ayırma yeteneklerini geliştiren bir ses-dil model ailesidir. 30 dil ve 16 Çince lehçesini destekler. Genel ses anlama, ses olayı algılama ve zamanlama gibi görevleri de kapsar. Farklı dağıtım ihtiyaçlarına yönelik akış ve asenkron işleme varyantları sunar.
Bu çalışma, ajan sistemlerinde tek bir sabit yapıya bağlı kalmak yerine çeşitli çalışma yapılarında eğitim yaparak genelleme sorununu çözen Harness Scaling yöntemini tanıtıyor. Faktöriyel yapı uzayı oluşturularak dengeli bir eğitim alt kümesi seçiliyor. Bu yaklaşım, bilinmeyen beyaz kutu yapılarında tutarlı iyileşme sağlıyor ve dış siyah kutu yapılarına etkili transfer imkanı sunuyor.
Ask-to-Distill, on-policy distillation için sentetik soru sentezleyen bir çerçevedir. Doğru cevap veya ödül sinyali gerektirmeden, öğrenci-öğretmen dağılımsal farkını kullanarak soru değerini optimize eder. Matematik, kod ve ajan görevlerinde gerçek soru bankalarını eşitleyen veya aşan performans gösterir.
HarnessAdapt-RL, kodlama ajanlarını eğitirken politika ile iskeleti birlikte optimize eden yeni bir pekiştirmeli öğrenme çerçevesi sunar. Dondurulmuş öğretmen modelleri, görev bazlı beceriler üretir ve tekrarlayan etkileşim sorunlarını çözmek için araçları evrimleştirir. Bu dinamik uyarlama, sabit iskeletli geleneksel yöntemlere kıyasla daha yüksek başarı oranları elde edilmesini sağlar.
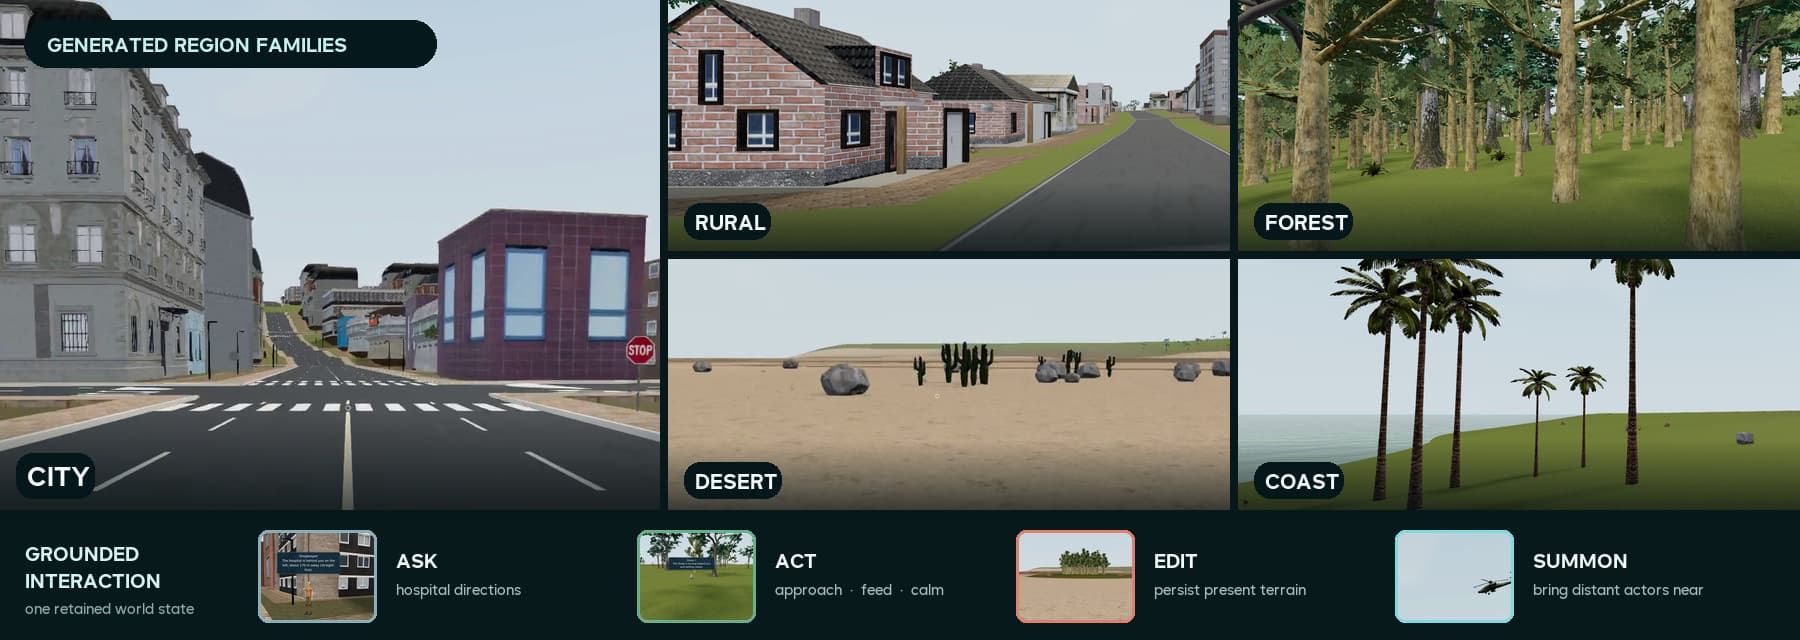
WorldStream, hiyerarşik planlama ve kalıcı durum yönetimiyle sınırsız 3D dünyalar üreten açık uçlu bir modeldir. Sistem, kullanıcı hareketine göre dinamik olarak yeni bölgeler oluşturur ve önceki düzenlemeleri koruyarak tutarlı bir oyun deneyimi sunar.
Araştırma, büyük dil modellerinin kapalı kitap modundaki hatalarının çoğunun eksik bilgi değil, ilk token hatası olduğunu gösteriyor. İlk token ipucu yöntemi, doğru ilk token verildiğinde modelin cevabı tamamladığını ve bunu doğru kabul ettiğini ortaya koyuyor. Bu bulgu, hataların geri kazanılabilir bir sınıf olduğunu ve çıkarım zamanı müdahalelerinin etkili olabileceğini kanıtlıyor.
arXiv1 dk okuma
49–60 / 119 yayın
Nasıl hazırlıyoruz?
Kaynağı belli. Sınırları açık.
Resmî duyuruları, araştırma makalelerini ve açık kaynak projelerinin sürüm notlarını yapay zekâ ile Türkçe özetliyoruz. Her haberde kaynak bağlantılarına, kullanım alanlarına ve açıklanmayan noktalara yer veriyoruz.
Doğrudan kaynak
Araştırma makalesine, model duyurusuna veya projenin deposuna haberden ulaşabilirsiniz.
Bulgular ve yorumlar
Kaynakta açıklanan sonuçları, olası kullanım alanları ve bilinmeyenlerden ayrı sunuyoruz.
Görsellerin kaynağı
Görsel ve videoların kaynağını belirtiyoruz. Konuyu anlatmak için kullanılan illüstrasyonları da işaretliyoruz.
Araştırma kaynakları
Makaleleri kendiniz keşfedin.
Yeni çalışmalar bulabileceğiniz dizinler ve araştırma laboratuvarları. Bir görsel özet ilginizi çekerse sonuçları özgün makaleden okuyun.