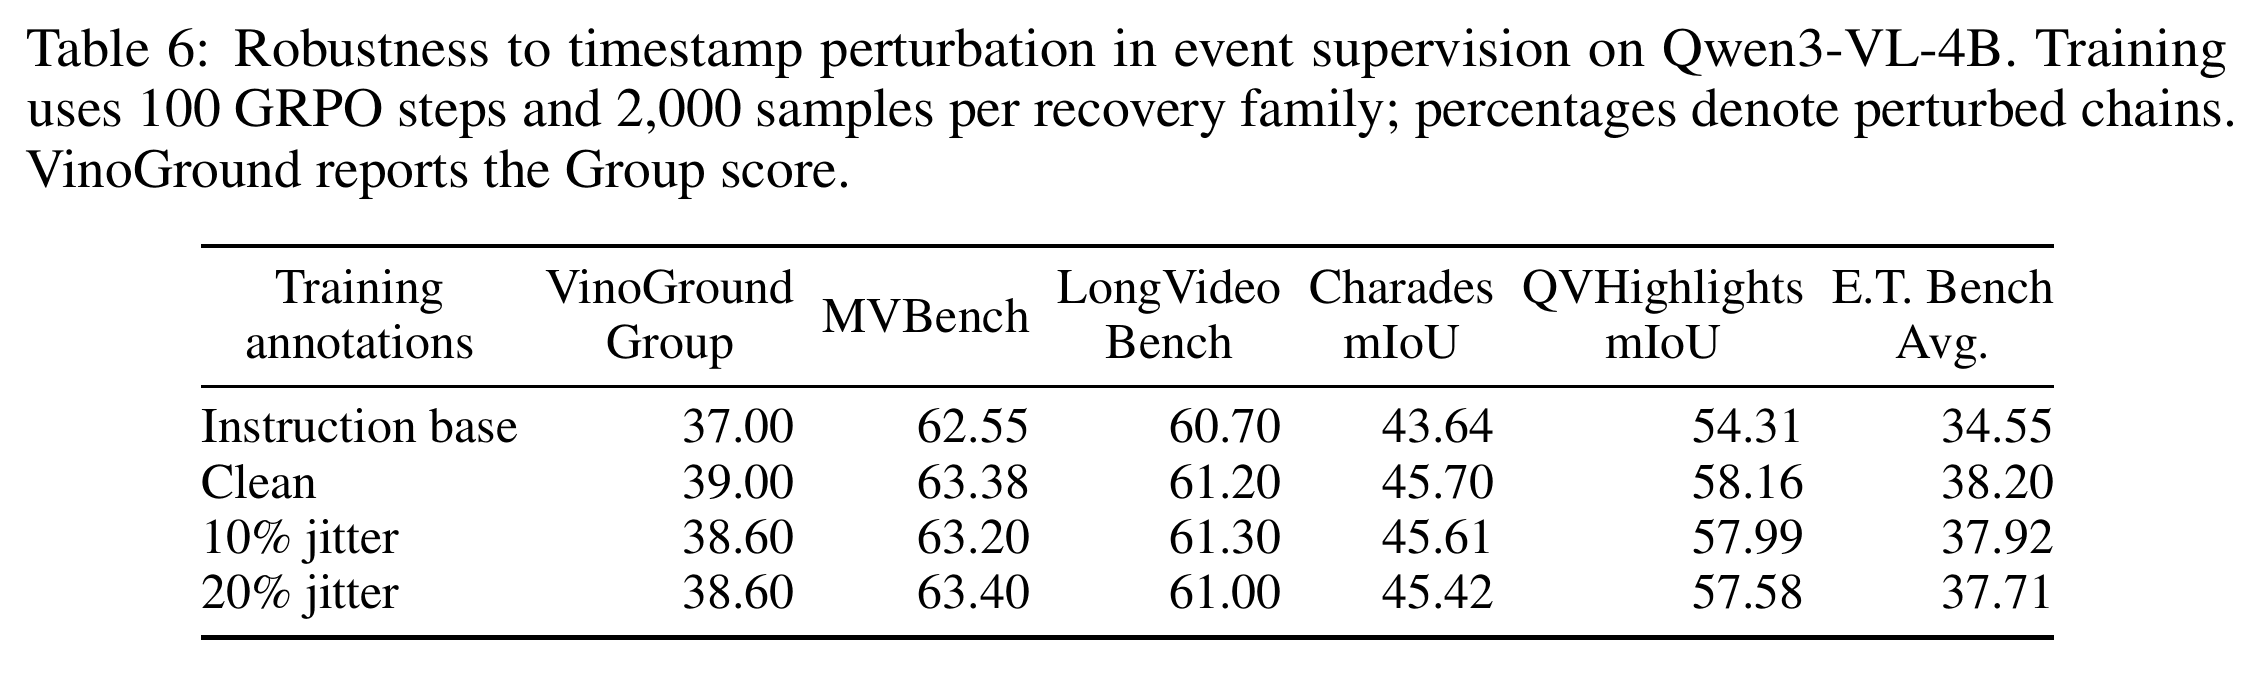
EventLens, video anlama modellerinin zaman yapısını yeniden kurma yeteneğini geliştirmek için görsel odaklı pekiştirmeli öğrenme kullanır. Model, olay sınırlarını ve ilişkilerini dil kısayolları yerine görsel kanıtlarla öğrenir. Bu yöntem, insan etiketi gerektirmeyen deterministik ödüllerle eğitim sağlar.
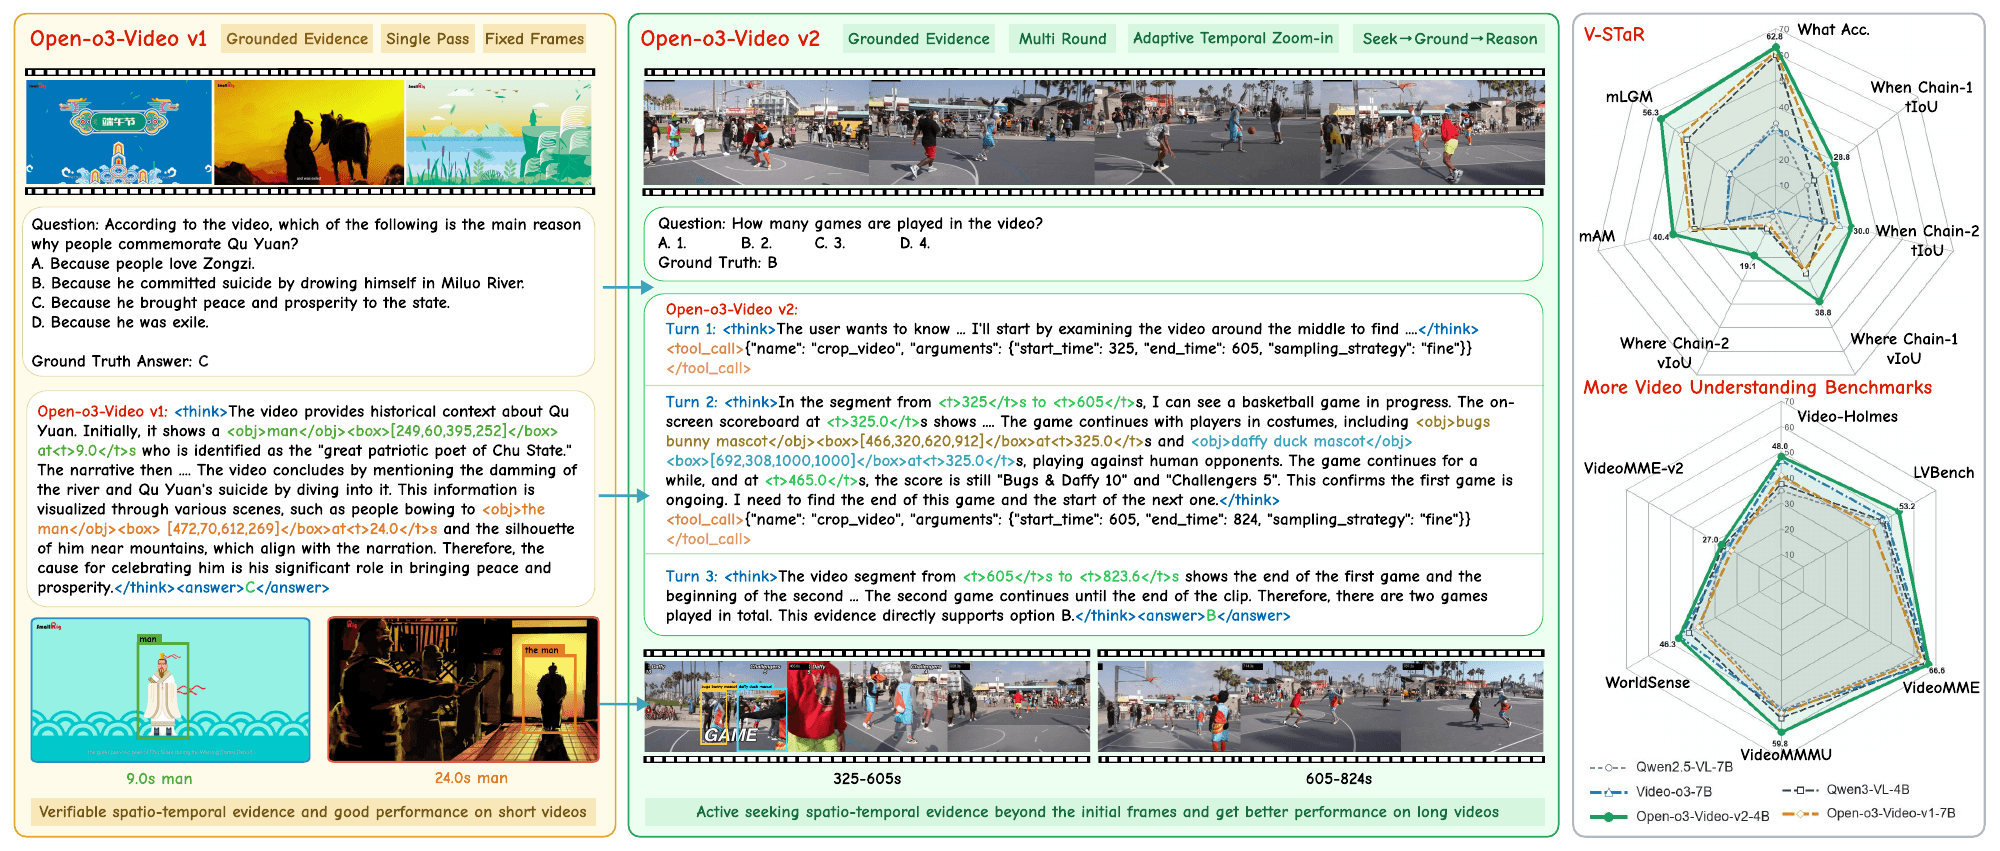
Open-o3-Video-v2, video akıl yürütmeyi ajan tabanlı bir kanıt toplama sürecine dönüştürüyor. Model, eksik bilgileri tespit edip zaman damgaları ve nesne kutuları ile desteklenen çok turlu bir analiz yapıyor. Yeni STGR-v2 veri setleri ve CS-GRPO algoritması bu süreci destekliyor.
arXiv1 dk okuma
1–2 / 2 yayın
Nasıl hazırlıyoruz?
Kaynağı belli. Sınırları açık.
Resmî duyuruları, araştırma makalelerini ve açık kaynak projelerinin sürüm notlarını yapay zekâ ile Türkçe özetliyoruz. Her haberde kaynak bağlantılarına, kullanım alanlarına ve açıklanmayan noktalara yer veriyoruz.
Doğrudan kaynak
Araştırma makalesine, model duyurusuna veya projenin deposuna haberden ulaşabilirsiniz.
Bulgular ve yorumlar
Kaynakta açıklanan sonuçları, olası kullanım alanları ve bilinmeyenlerden ayrı sunuyoruz.
Görsellerin kaynağı
Görsel ve videoların kaynağını belirtiyoruz. Konuyu anlatmak için kullanılan illüstrasyonları da işaretliyoruz.
Araştırma kaynakları
Makaleleri kendiniz keşfedin.
Yeni çalışmalar bulabileceğiniz dizinler ve araştırma laboratuvarları. Bir görsel özet ilginizi çekerse sonuçları özgün makaleden okuyun.