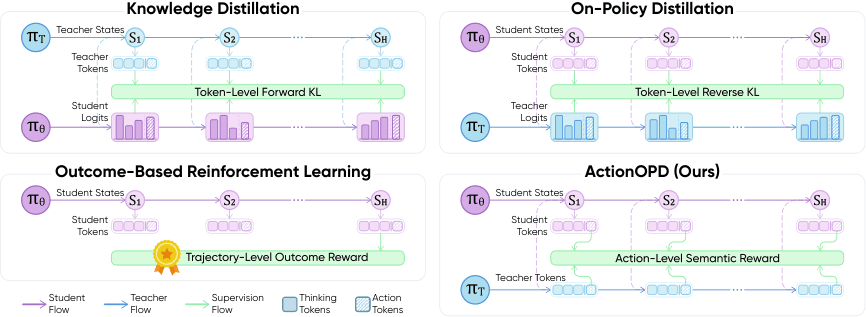
ActionOPD, dil model ajanlarını daha küçük modellere aktarırken token düzeyi yerine semantik karar düzeyinde hizalama yapan yeni bir on-policy distillation yöntemidir. Öğretmen modelin token olasılıklarına veya aynı tokenizer'a ihtiyaç duymadan, öğrenci modelin karşılaştığı durumlarda semantik uyum ödülleriyle eğitim yapar. Qwen3-4B ve Qwen3-8B modellerinde dağıtım dışı benchmark'larda ortalama 3.3-6.9 puanlık iyileşme göstermiştir.
Bu çalışma, off-policy RLVR'de token bazlı önem örneklemesini Proximal KL düzenlemesiyle birleştirir. Teorik kanıtlar, tam gelecek KL kredisinin policy gradient sapmasını ortadan kaldırdığını gösterir. Qwen3 modellerinde GRPO'ya kıyasla daha yüksek doğruluk ve kararlılık elde edilir.
arXiv1 dk okuma
1–2 / 2 yayın
Nasıl hazırlıyoruz?
Kaynağı belli. Sınırları açık.
Resmî duyuruları, araştırma makalelerini ve açık kaynak projelerinin sürüm notlarını yapay zekâ ile Türkçe özetliyoruz. Her haberde kaynak bağlantılarına, kullanım alanlarına ve açıklanmayan noktalara yer veriyoruz.
Doğrudan kaynak
Araştırma makalesine, model duyurusuna veya projenin deposuna haberden ulaşabilirsiniz.
Bulgular ve yorumlar
Kaynakta açıklanan sonuçları, olası kullanım alanları ve bilinmeyenlerden ayrı sunuyoruz.
Görsellerin kaynağı
Görsel ve videoların kaynağını belirtiyoruz. Konuyu anlatmak için kullanılan illüstrasyonları da işaretliyoruz.
Araştırma kaynakları
Makaleleri kendiniz keşfedin.
Yeni çalışmalar bulabileceğiniz dizinler ve araştırma laboratuvarları. Bir görsel özet ilginizi çekerse sonuçları özgün makaleden okuyun.