Büyük dil modellerinde mekanik belirsizliği ölçen neden-sonuç sağlamlık marjı
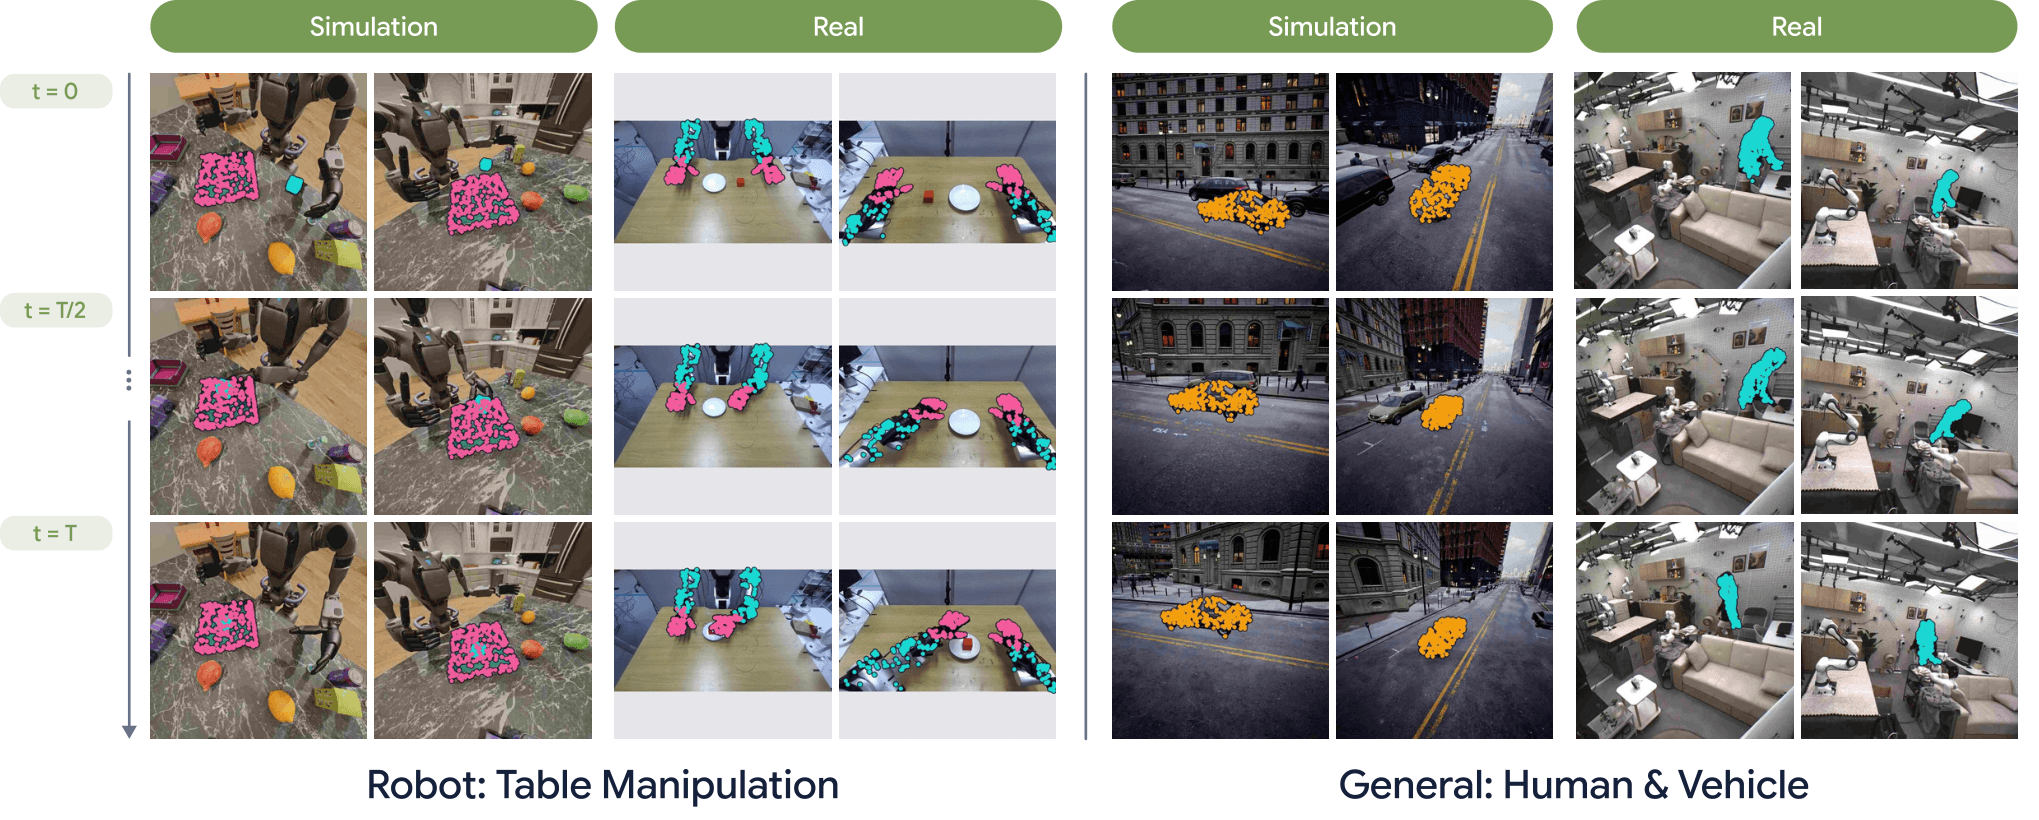
Araştırma, büyük dil modellerindeki halüsinasyon riskini azaltmak için 'mekanik belirsizlik' kavramını ve 'neden-sonuç sağlamlık marjı' metrikini tanıtır. Jlens kavram yönlendirme vektörleri kullanılarak bu marj, modelin çıktısını saptırmak için gereken minimum iç müdahale olarak işlevselleştirilir. Üç açık kaynak model ve beş veri seti üzerinde yapılan testlerde, hatalı yanıtların bu marjın daha küçük olduğu ve bu yöntemin geleneksel belirsizlik ölçümlerini tamamladığı görülmüştür.

Bu yazıda
Ne değişti?
Mekanik belirsizlik, modelin iç mekanizmalarının kararlılığı üzerinden tanımlanır ve neden-sonuç sağlamlık marjı ile ölçülür.
Üç açık kaynak modelde, hatalı ve belirsiz yanıtların iç müdahalelere karşı daha hassas olduğu ve marjlarının daha küçük olduğu gösterilmiştir.
Neden önemli?
Kritik alanlarda kullanılan büyük dil modellerinin güvenilirliği, halüsinasyon eğilimleri nedeniyle sürekli sorgulanmaktadır. Bu çalışma, belirsizliğin yalnızca çıktı dağılımından değil, modelin iç mekanizmalarının kararlılığından da kaynaklandığını gösteren yeni bir perspektif sunar. Doğru öğrenilen bilgilerin eğitim sonrası marjlarının artması, bu yaklaşımın mekanik bir temele dayandığını ve modelin bilgiyi ne kadar sağlam öğrendiğine dair içgörü sağladığını destekler.
Geliştirici için ne anlama geliyor?
Geliştiriciler, modelin iç mekanizmalarındaki kırılganlığı ölçerek halüsinasyon riskini daha erken tespit edebilir. Bu yaklaşım, yalnızca çıktıya dayalı belirsizlik metriklerinin ötesine geçerek, modelin neden belirli bir cevabı ürettiğine dair mekanik bir sinyal sunar. Kritik uygulamalarda güven skorlarını zenginleştirmek için bu yöntemin mevcut pipeline'lara entegre edilmesi değerlendirilebilir.
Henüz neyi bilmiyoruz?
- Yöntem, üç açık kaynak model ve beş soru-cevap veri setiyle sınırlı bir kapsamda test edilmiştir.
- Neden-sonuç sağlamlık marjının, geleneksel yöntemlerle tam olarak nasıl birleştirileceği pratik detayları belirsizdir.
Haberin kaynakları
Birincil kaynakMeasuring Mechanistic Uncertainty in Large Language Models via Causal Robustnessarxiv.org Araştırma keşfiHugging Face Daily PapersÖzgün sayfayı açYayın tarihleri
- blue'og yayını
- Kaynak yayını
Bu yazı, bağlantılı kaynaklar okunarak yapay zekâ ile hazırlandı. Kaynaktaki bulguların yanı sıra kullanım alanları ve açıklanmayan noktalar da yer alır. Görsel ve videoların kaynakları üzerlerinde belirtilir; hakları sahiplerine aittir. En güncel ayrıntılar için kaynakları inceleyebilirsiniz.