On-policy distillation'da eğitim-çıkarma uyumsuzluğu toleransı
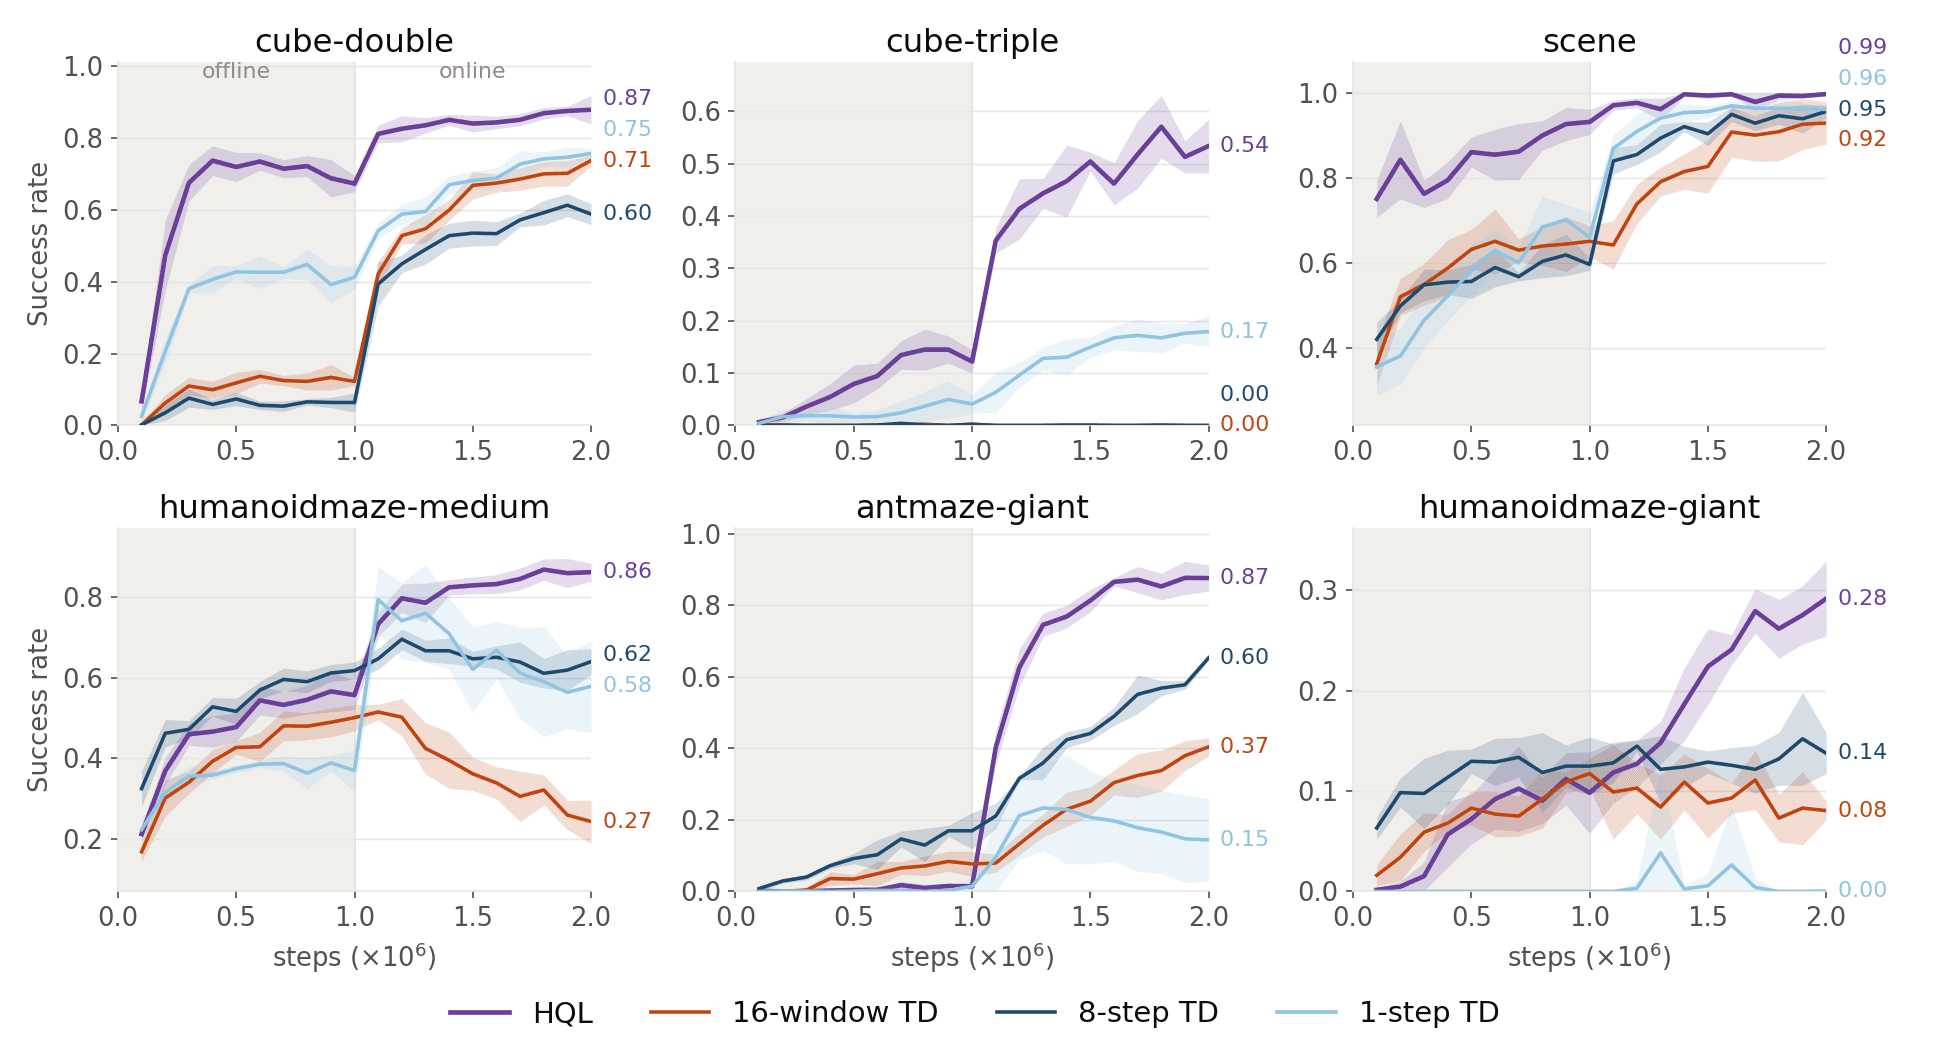
Bu çalışma, on-policy distillation'da eğitim ve çıkarım arasındaki uyumsuzluğun ne kadar tolere edilebildiğini inceler. Kuantizasyon ve asenkron dağıtımın etkilerini ölçen araştırma, OPD'nin RL yöntemlerine kıyasla daha kararlı olduğunu gösterir. FP8 kullanımı, KV önbelleği kapasitesini artırırken eğitim kalitesini korur.

Bu yazıda
Ne değişti?
OPD, yüksek seviyelere kadar uyumsuzluğu anlamlı kalite kaybı olmadan tolere eder ve deneysel bir bütçe ortaya koyar.
FP8 tarifi, BF16'ya kıyasla KV önbelleğinde en az 1.93 kat daha fazla token kapasitesi sağlarken eğitim kalitesini korur.
Neden önemli?
RL yöntemlerini kararsızlaştıran dağıtım yapılandırmalarında OPD kararlı kalır. Bu fark, büyük dil modellerinin eğitiminde maliyet verimliliği ve sistem kararlılığı için kritik bir avantaj sağlar. Araştırma, pratik sistem tasarımlarında güvenle uygulanabilir bir eşik belirler.
Geliştirici için ne anlama geliyor?
Geliştiriciler, FP8 ve asenkron dağıtım kombinasyonuyla eğitim süresini kısaltabilir. Hafif kabul kontrolü, her aday yapılandırma için tam eğitim koşmadan maliyetli denemeleri önler. Bu yaklaşım, sınırlı donanım bütçesiyle daha hızlı prototipleme imkânı tanır.
Henüz neyi bilmiyoruz?
- Araştırma, üç öğrenci-öğretmen çifti ve tek bir çiftte ek testlerle sınırlıdır; genel geçerlilik tüm modeller için garanti edilmez.
- Sonuçlar, belirli kuantizasyon ve asenkron dağıtım koşullarına dayanır; farklı donanım veya görevlerde değişebilir.
Haberin kaynakları
Birincil kaynakHow Much Training-Inference Mismatch Can On-Policy Distillation Tolerate?arxiv.org Araştırma keşfiHugging Face Daily PapersÖzgün sayfayı açYayın tarihleri
- blue'og yayını
- Kaynak yayını
Bu yazı, bağlantılı kaynaklar okunarak yapay zekâ ile hazırlandı. Kaynaktaki bulguların yanı sıra kullanım alanları ve açıklanmayan noktalar da yer alır. Kapak, konuyu anlatan bir illüstrasyondur. En güncel ayrıntılar için kaynakları inceleyebilirsiniz.