Sıralama odaklı on-policy distilasyon yöntemi O3PD tanıtıldı
Yeni bir distilasyon yöntemi olan O3PD, öğrenci modelin kendi çıktılarını kullanarak öğretmenin token sıralamasını öğrenmesini sağlar. Bu yaklaşım, olasılık değerlerini eşleştirmek yerine sıralamaya odaklanarak sıcaklık hassasiyetini ortadan kaldırır ve matematik testlerinde daha iyi sonuçlar verir.

Bu yazıda
Ne değişti?
O3PD, öğretmenin üst sıradaki K token sırasını kopyalayarak olasılık değerlerini eşleştirmeden eğitim yapar.
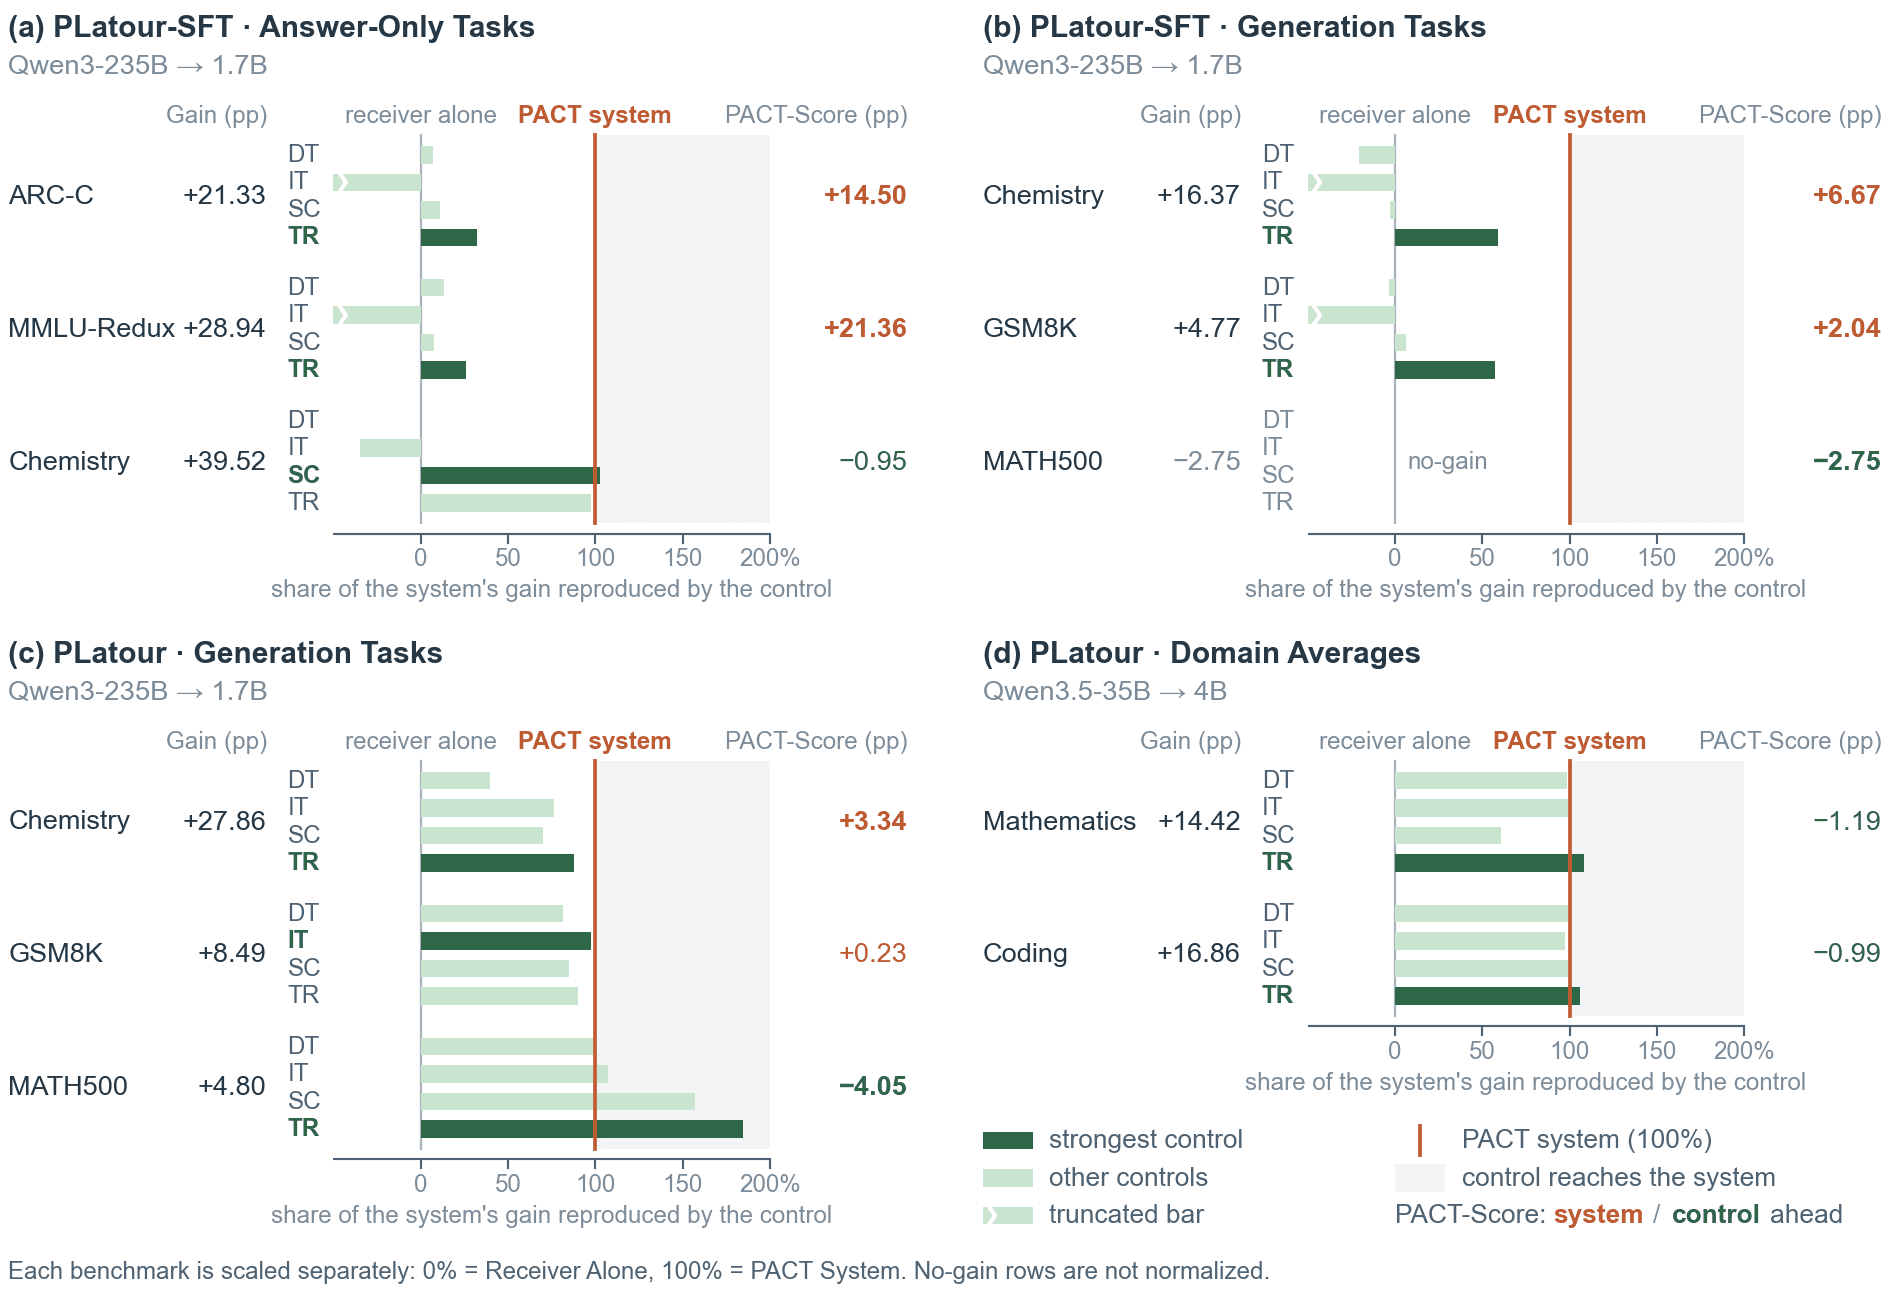
Altı farklı çift üzerinde O3PD, OPD'ye kıyasla matematik testlerinde ortalama 2.9 puana kadar üstünlük gösterdi.
Neden önemli?
Geleneksel distilasyonda öğretmen modelin olasılık değerleri, öğrenci modelin kapasitesini aşan kalibrasyon bilgisi içerebilir. O3PD, bu bilgiyi sıralama bilgisiyle değiştirerek model boyutu farkını daha verimli yönetmeyi hedefler.
Geliştirici için ne anlama geliyor?
Bu yöntem, küçük modellerin büyük öğretmenlerden öğrenirken sıcaklık ayarıyla uğraşmasını engeller. Sıralama odaklı eğitim, olasılık değerlerini birebir kopyalama zorunluluğunu kaldırarak daha esnek bir distilasyon süreci sunar.
Henüz neyi bilmiyoruz?
- Sonuçlar yalnızca HMMT25 ve AIME serisi gibi matematik odaklı değerlendirme setlerinde raporlanmıştır.
- Yöntemin genel dil görevlerine veya kod üretimine etkisi bu makalede test edilmemiştir.
Haberin kaynakları
Birincil kaynakOrder-Only On-Policy Distillationarxiv.org Araştırma keşfiHugging Face Daily PapersÖzgün sayfayı açYayın tarihleri
- blue'og yayını
- Kaynak yayını
Bu yazı, bağlantılı kaynaklar okunarak yapay zekâ ile hazırlandı. Kaynaktaki bulguların yanı sıra kullanım alanları ve açıklanmayan noktalar da yer alır. Kapak, konuyu anlatan bir illüstrasyondur. En güncel ayrıntılar için kaynakları inceleyebilirsiniz.