Çok modlu büyük dil modellerinde görsel bilginin dil modeline nasıl bağlanacağı sorusunu ele alan bu çalışma, DGP adlı dinamik kapılı yollar mekanizmasını sunar. Yöntem, görsel kodlayıcının her katmanını dil modelinin her katmanına bağlayarak, dil katmanlarının kendi semantik durumuna göre görsel katman tercihini dinamik olarak belirlemesini sağlar. LLaVA-1.5 tabanlı modellerde test edilen yöntem, önceki sabit veya önceden tanımlı bağlantı yöntemlerine kıyasla tutarlı performans artışı elde.
Araştırma, protein motif iskeleti oluşturan üretken modellerin statik yeniden katlanma başarılarının dinamik kararlılığı garanti etmediğini gösteriyor. BILBY-PRO ve BILBY-MD çerçeveleri, hedef kapsamı, benzersiz çözüm verimi ve dinamik sadakat eksenlerinde kapsamlı bir değerlendirme sunuyor. Çalışma, mevcut benchmarkların sınırlılıklarını ortaya koyarak daha gerçekçi test standartları öneriyor.
SplatAnything, ileri beslemeli 3D Gaussian Splatting yöntemlerindeki Gaussian aralığı normalizasyon eksikliğini GSNorm ile giderir. Bu yaklaşım, sahne ölçeği ve kamera konfigürasyonları değişse bile tutarlı bir uzamsal referans sağlar. Sistemli bir benchmark ile test edilen yöntem, özellikle büyük ölçekli sahnelerde ve farklı bakış açıları altında en iyi performansı gösterir.
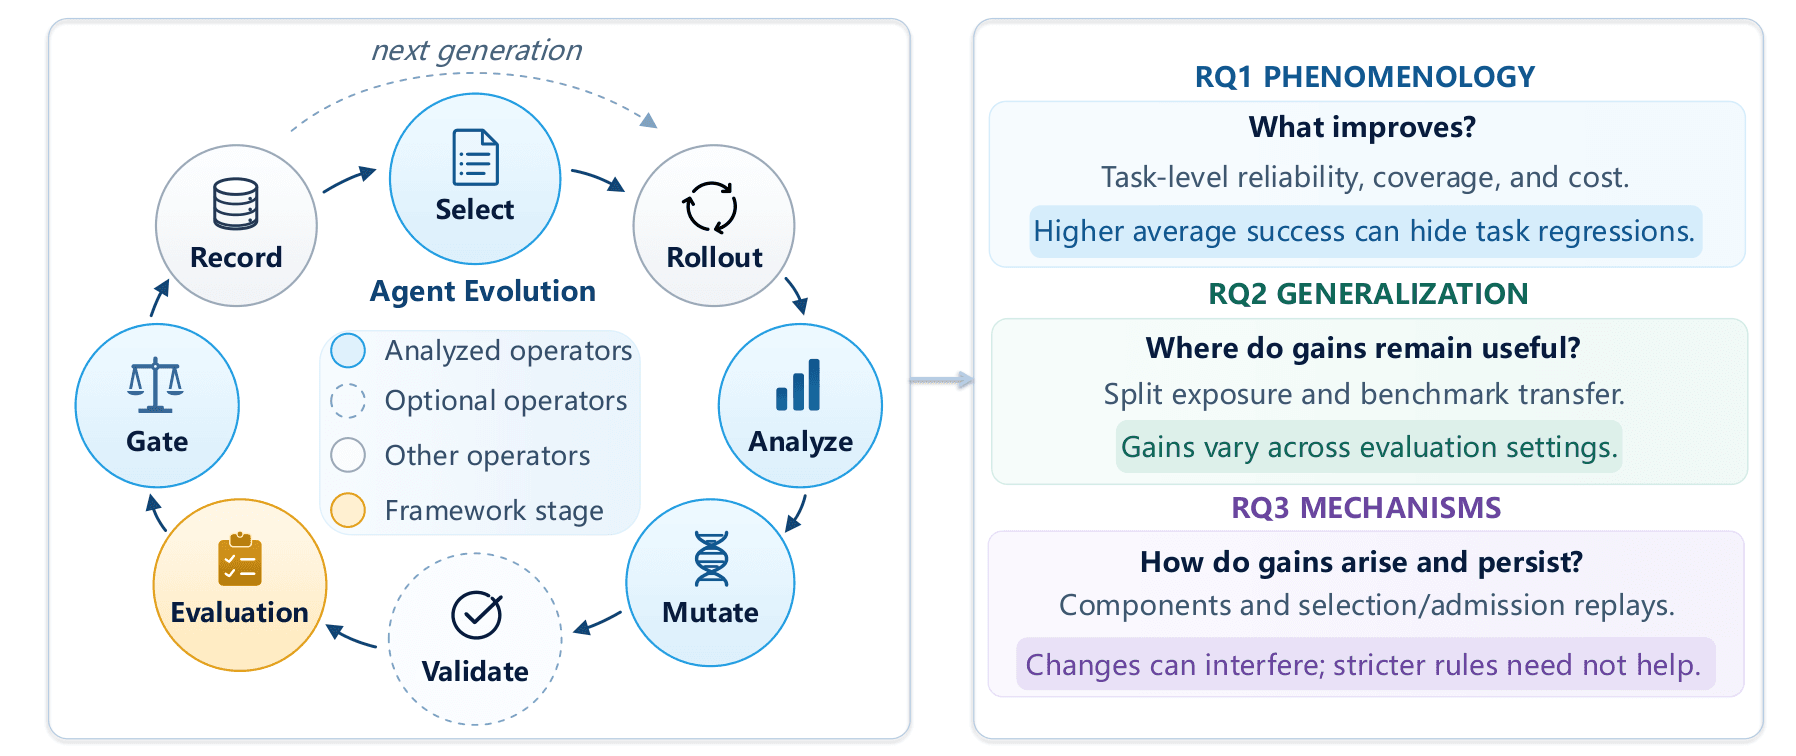
Araştırma, ağırlık güncellemesi yapmadan çalışan ajan evriminin güvenilirliğini sorguluyor. On altı ajanın tamamı yeni görevler kazanırken eski görevleri kaybediyor. Güvenilirlik artışı çoğu zaman maliyeti yükseltiyor ve en yüksek puanlı ajan en büyük ortalama iyileşmeyi vermiyor.
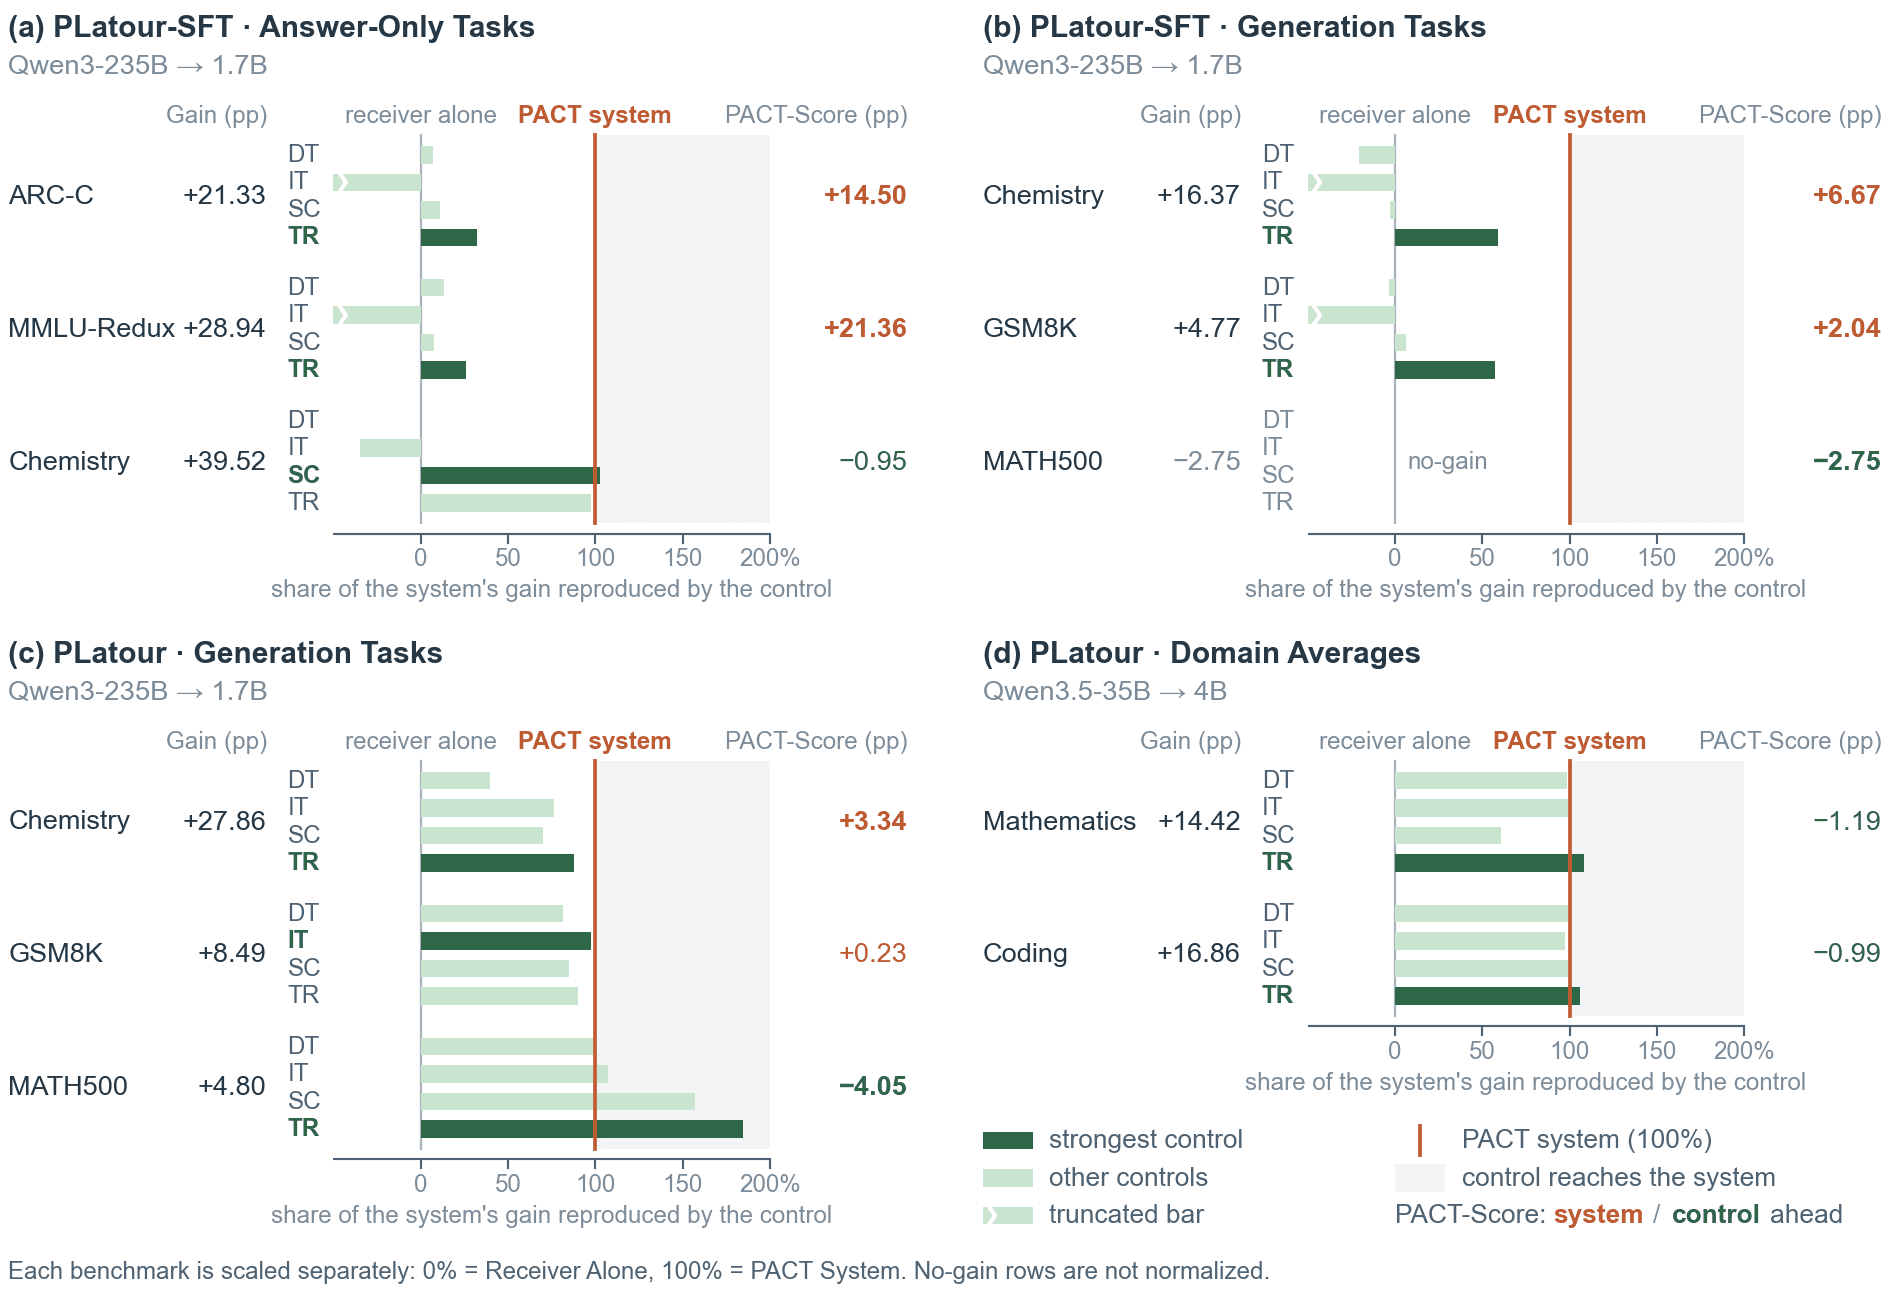
PLatour, büyük bir modelin prompt temsillerini küçük bir modelin verimli üretimiyle birleştiren açık kaynaklı bir PACT çerçevesidir. Görev ödülleriyle eğitilen hafif doğrusal köprüler kullanır. Ancak kontrollü deneyler, bazı kazanımların alıcı modelin kendi adaptasyonundan kaynaklanabileceğini gösterir. Bu nedenle PACT-Check önerilir.
Araştırma, MoE modellerindeki uzmanların ne işe yaradığını incelemek için seyrek otoenkoderları kullanır. Qwen3-30B-A3B üzerinde yapılan analiz, uzmanların Java kodu veya geometri gibi ince görevlerde uzmanlaştığını gösterir. Bu yöntem, uzmanların katkısını yönlendirme frekansından bağımsız olarak ölçer.
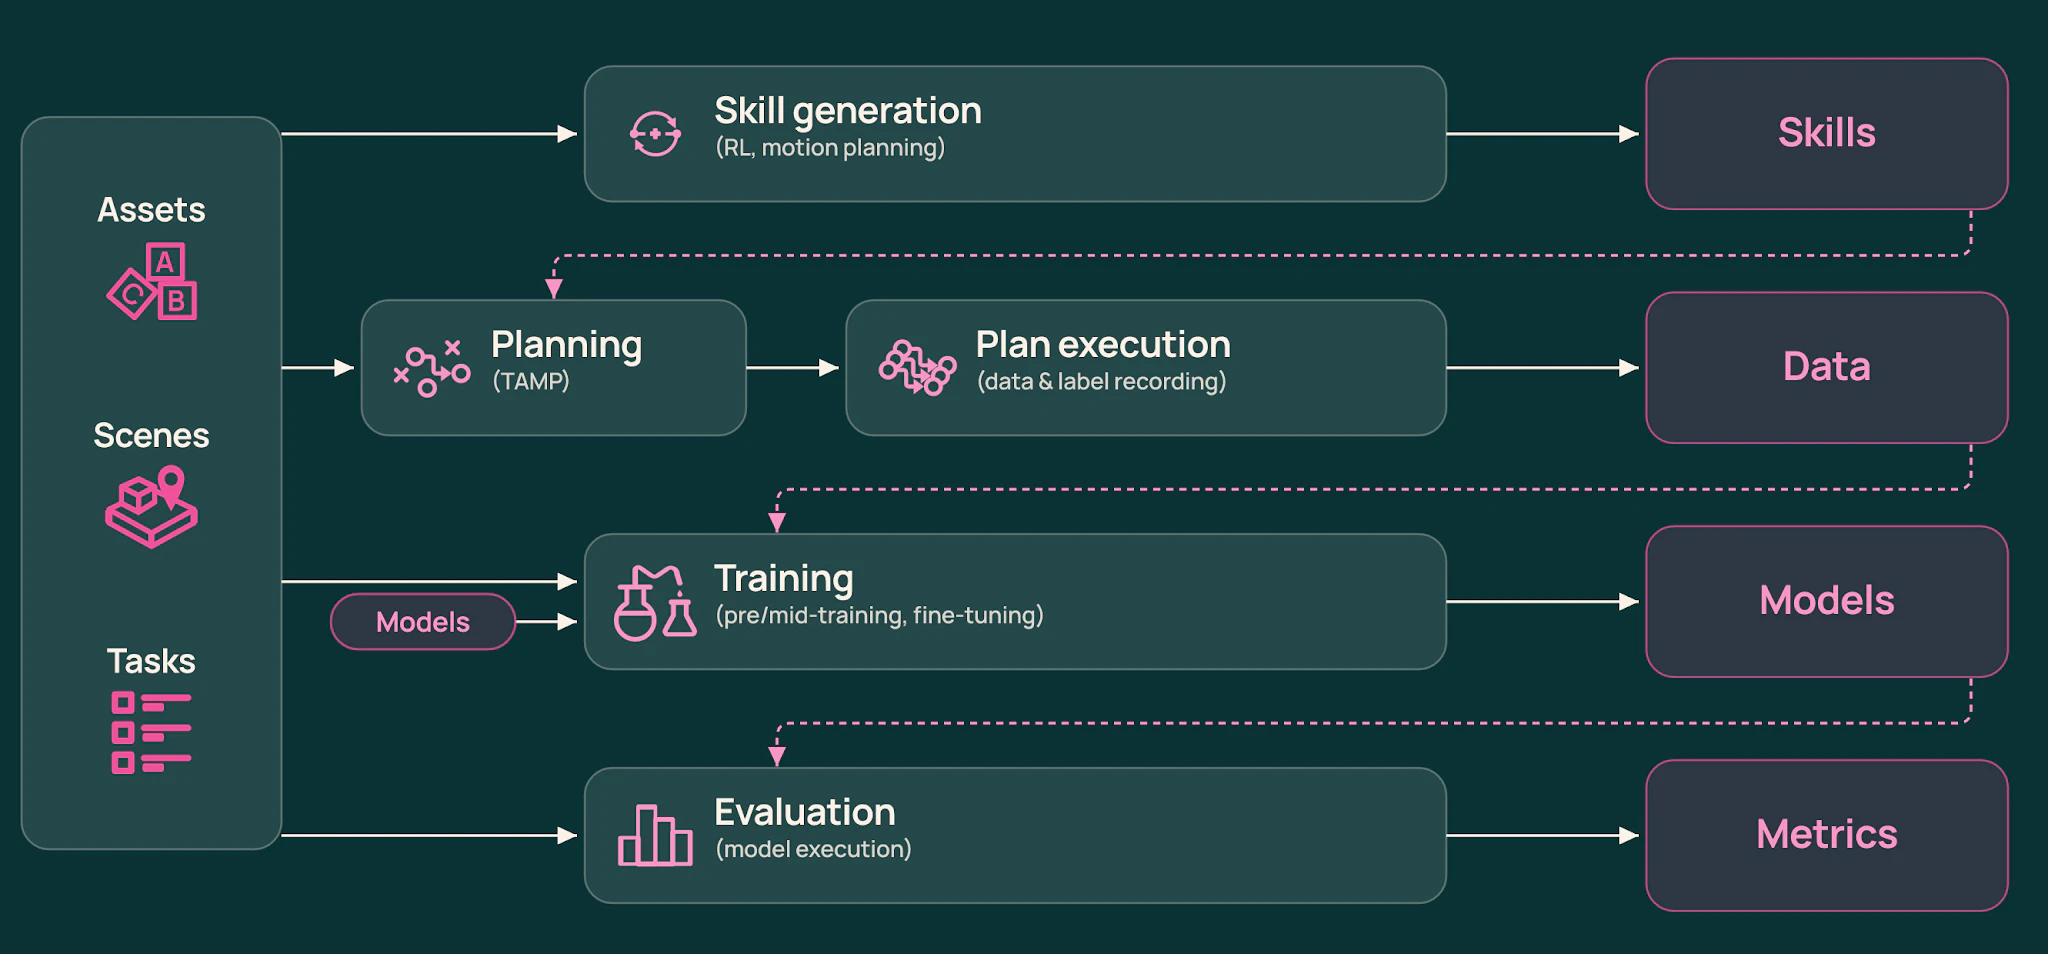
AllenAI, robot öğrenmesi için kontrollü bir simülasyon ortamı olan ToyBlocks'u tanıttı. Bu framework, otomatik görev ve gösterim üretimi ile robotların fiziksel etkileşimlerini ölçülebilir hale getirir. Çalışma, VLA modellerinin mekânsal genelleme sorunlarını ve frontier modellerin araç çağrısı ile planlama yeteneklerini test etmek için tasarlanmıştır.
EDGAR, Gaussian splatting tabanlı avatarlarda bulanıklık ve zamanla tutarsızlık gibi artefaktları gidermek için koşullu difüzyon kullanır. Sapiens modelinden kimlik özellikleri alarak tek adımlı işleme yapar ve MoE mimarisiyle farklı bozulma türlerini ele alır. Üç farklı yeniden yapılandırma yönteminde ham çıktılara kıyasla algısal ve yeniden yapılandırma metriklerinde iyileşme gösterir.
Araştırma, gömme modellerindeki temsil karışmasını azaltmak için girdiye öğrenilebilir [DUMP] token'ları ekleyen basit bir yöntem öneriyor. Bu yaklaşım, model mimarisini ve eğitim kayıp fonksiyonunu değiştirmeden, dikkat çukuru davranışından kaynaklanan kalıntı sinyallerin etkisini azaltıyor. Standart arama ve uzun bağlam testlerinde ince ayarlı taban çizgilerine karşı tutarlı iyileşme gösteriyor.
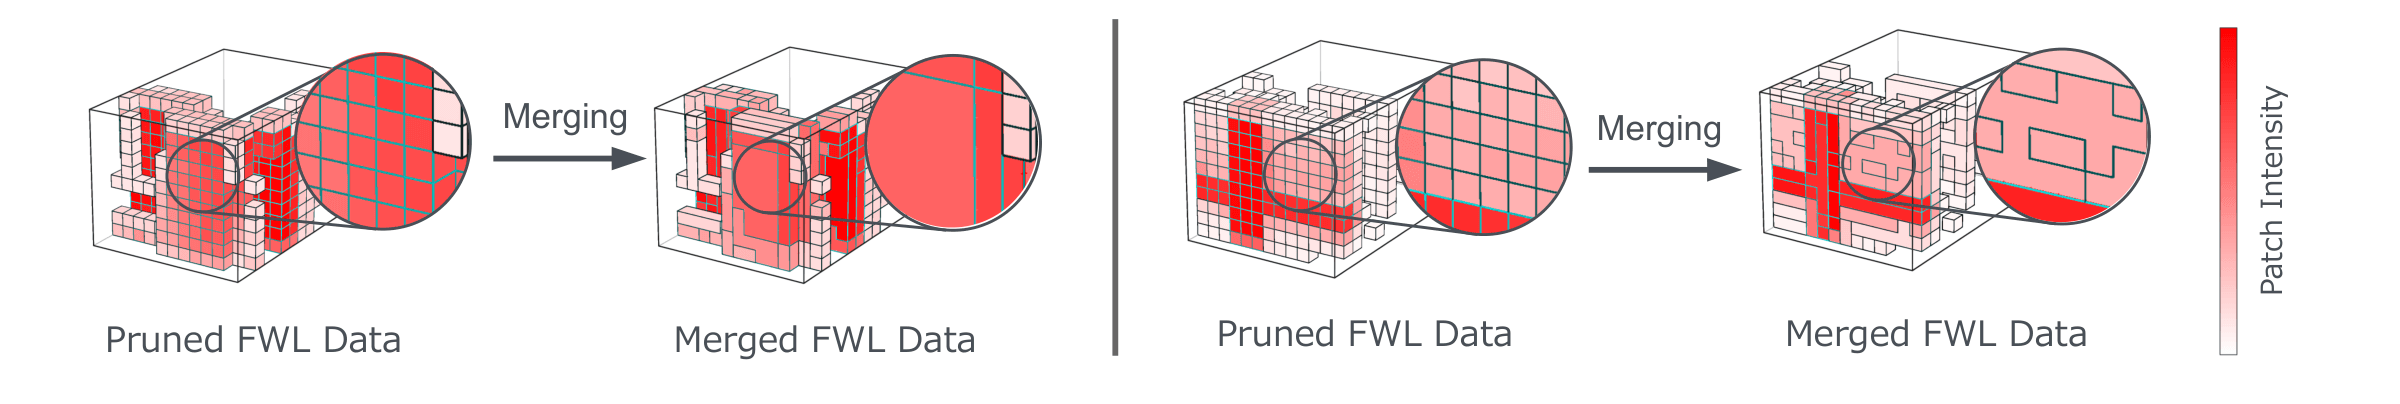
Bu çalışma, tam dalga formu LiDAR verilerinde hesaplama maliyetini azaltmak ve veri kıtlığını çözmek için iki yeni yöntem önerir. FWL-ToPM, yoğunluk dağılımlarını kullanarak token sayısını azaltırken kritik dalga formu içeriğini korur. FWLAug ise fiziksel yapıyı koruyan bir veri artırma çerçevesi sunar. Ghost-FWL üzerinde test edilen bu yöntemler, gerçek zamanlı işlem hızını artırırken doğruluğu da iyileştirir.
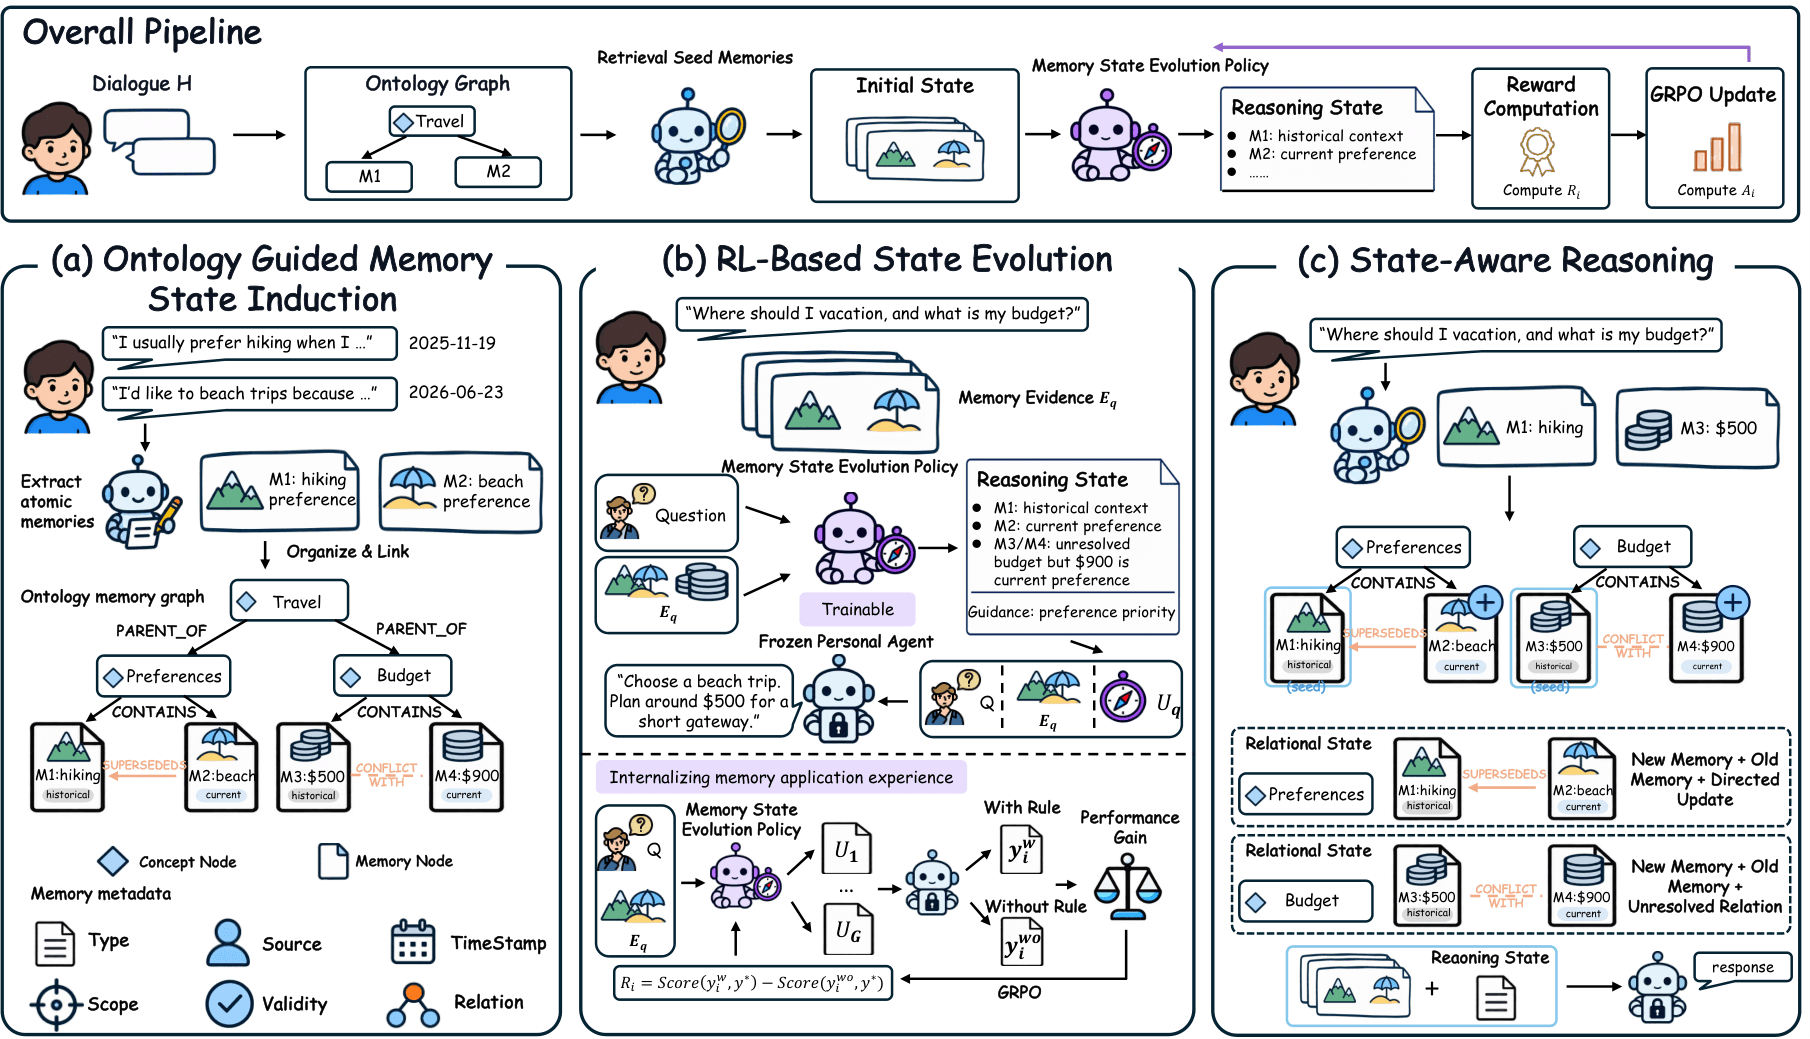
EvoMemState, LLM tabanlı kişisel asistanlar için uzun vadeli hafıza yönetimini bağımsız olgular yerine evrilen durumlar üzerinden ele alan yeni bir çerçevedir. Sistem, olguların geçerliliğini ve ilişkilerini koruyan İlişkisel Durumlar ile güncel isteğe özgü uygulama stratejisi üreten Akıl Yürütme Durumu bileşenlerini kullanır. Pekiştirmeli öğrenme ile desteklenen bu yaklaşım, uzun vadeli diyalog testlerinde mevcut sistemlere kıyasla tutarlı iyileşmeler sunmaktadır.
SLA, robot manipülasyonunda mekânsal anlayışı sürekli ön eğitim yoluyla ölçekleyen bir modeldir. pi05 politikasından başlatılan model, dondurulmuş 3D algılama modelinden gelen mekânsal temsillerle görsel gömümler arasında hizalama yapar. Heterojen robot verilerini birleştirerek farklı gövdeler ve görevler için mekânsal öğrenmeyi destekler. Tüm yardımcı bileşenler yalnızca eğitim sırasında kullanılır, bu da mevcut VLA ağırlıklarının doğrudan yeniden kullanılmasını sağlar.
arXiv1 dk okuma
25–36 / 99 yayın
Nasıl hazırlıyoruz?
Kaynağı belli. Sınırları açık.
Resmî duyuruları, araştırma makalelerini ve açık kaynak projelerinin sürüm notlarını yapay zekâ ile Türkçe özetliyoruz. Her haberde kaynak bağlantılarına, kullanım alanlarına ve açıklanmayan noktalara yer veriyoruz.
Doğrudan kaynak
Araştırma makalesine, model duyurusuna veya projenin deposuna haberden ulaşabilirsiniz.
Bulgular ve yorumlar
Kaynakta açıklanan sonuçları, olası kullanım alanları ve bilinmeyenlerden ayrı sunuyoruz.
Görsellerin kaynağı
Görsel ve videoların kaynağını belirtiyoruz. Konuyu anlatmak için kullanılan illüstrasyonları da işaretliyoruz.
Araştırma kaynakları
Makaleleri kendiniz keşfedin.
Yeni çalışmalar bulabileceğiniz dizinler ve araştırma laboratuvarları. Bir görsel özet ilginizi çekerse sonuçları özgün makaleden okuyun.