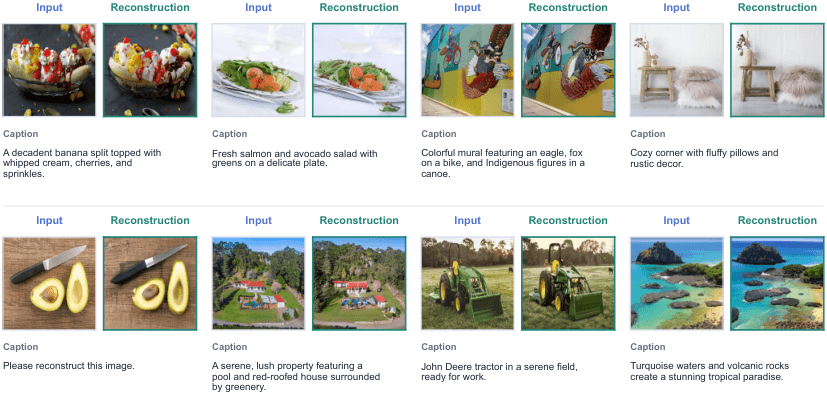
Jeveration, donmuş bir görsel-dil modelini kullanarak tek ileri geçişte yüksek kaliteli görüntü üretimi yapar. Paylaşılan rastgele durum ile paralel tahminleri koordine ederek küresel tutarlılığı sağlar. Metinden görüntüye, görüntüden görüntüye ve yoğun tahmine kadar üç görevi tek kontrol noktasında birleştirir.
AVTR, görsel-dil modellerinde metin tabanlı akıl yürütmenin sınırlarını aşmak için görsel hayal gücünü dinamik bir mod olarak entegre eder. Öğrenilmiş bir yönlendirme politikası, girdiye göre görsel yansıma veya metin çıkarımı arasında seçim yaparak gereksiz uzun izleri önler. Bu yaklaşım, 16 benchmark'ta ortalama 4.5 puanlık iyileşme ve yüzde 33 gecikme azalması sağlar.
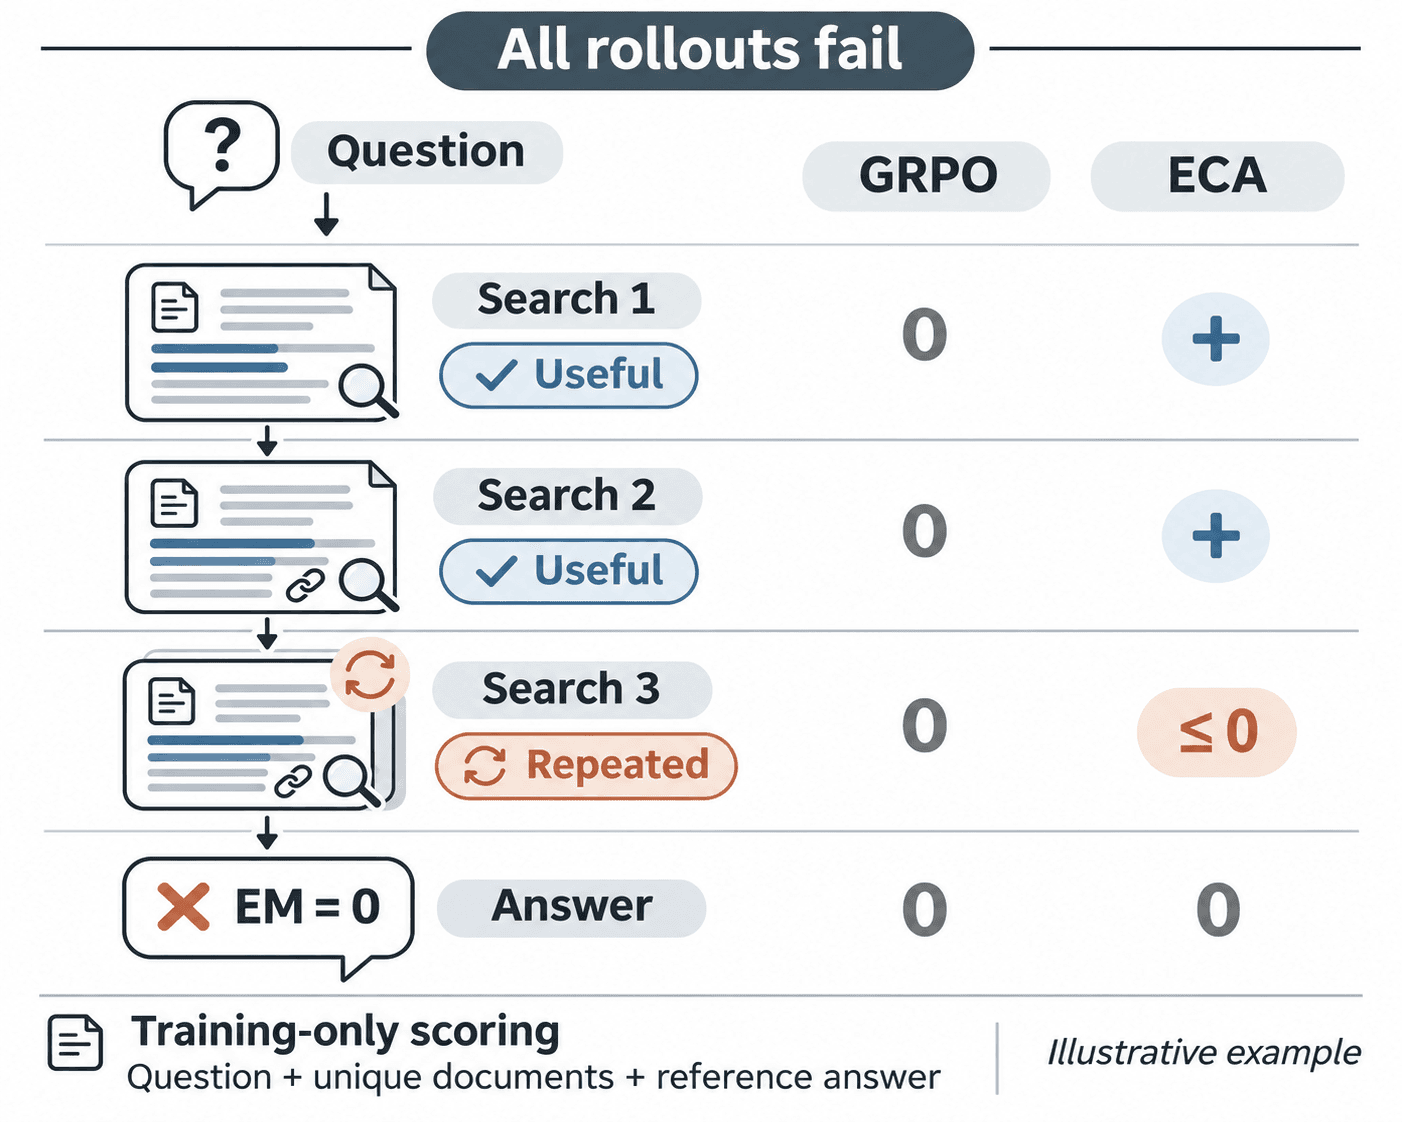
Araştırma, arama destekli dil modellerinde terminal ödül sinyallerinin tüm arama adımlarına eşit kredi ataması sorununu ele alıyor. ECA yöntemi, alınan belgelerin referans cevabın olasılığını artırma derecesini ölçen bir yardımcı sinyal ekleyerek bu sorunu çözmeye çalışıyor. Yedi benchmark'ta test edilen yöntem, özellikle küçük modellerde sonuç odaklı öğrenmeye kıyasla belirgin iyileşme sağlıyor.
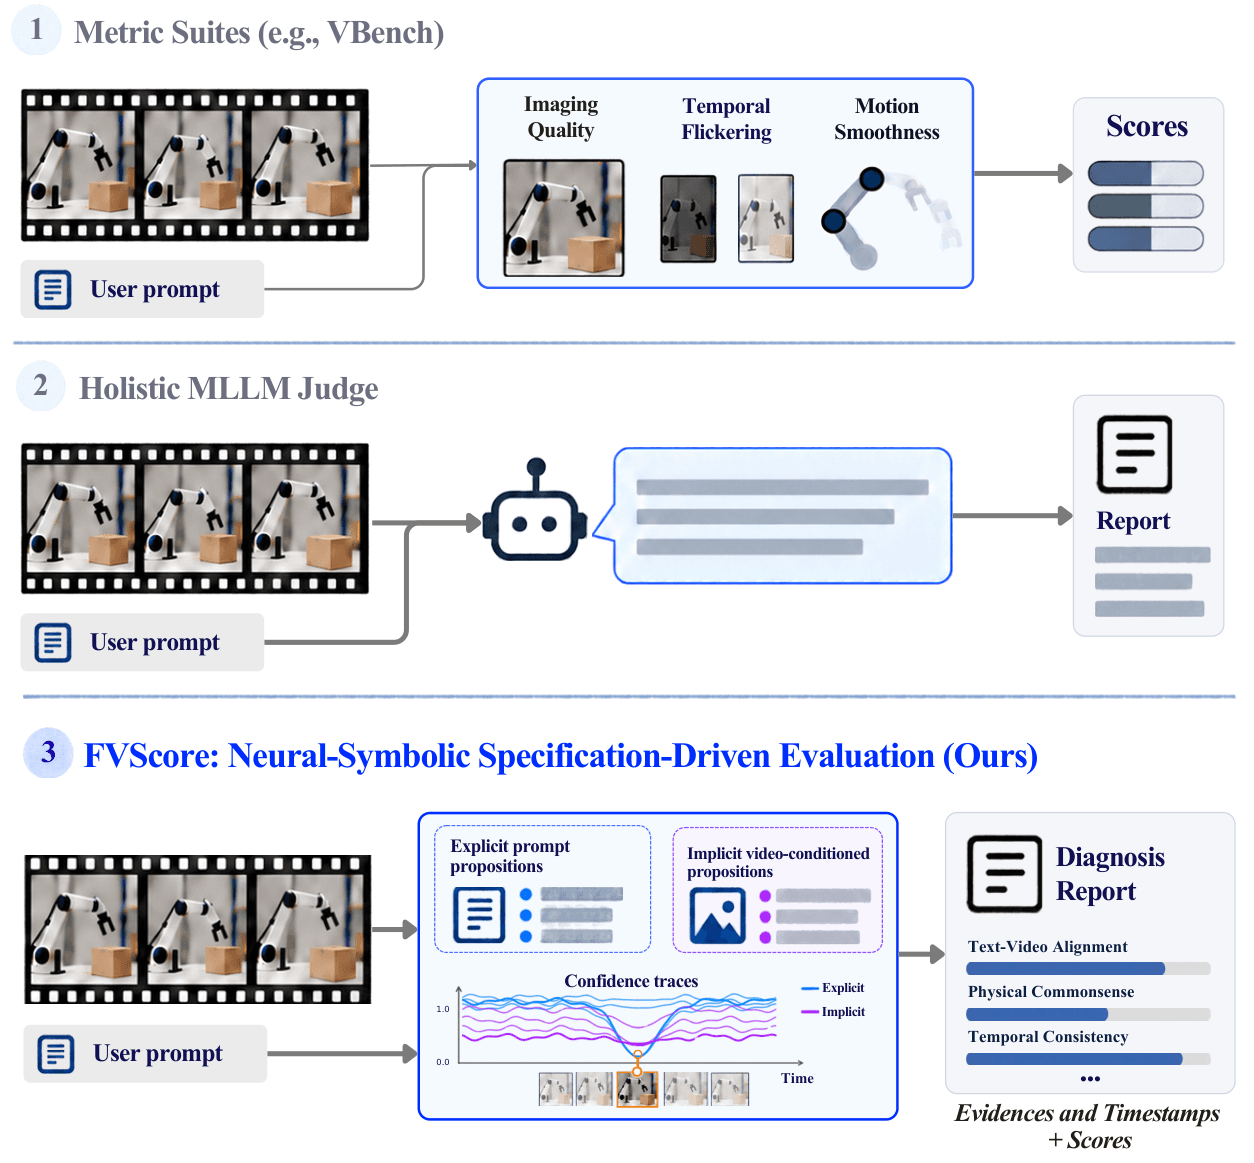
FVScore, video üretimini spesifikasyon odaklı değerlendirmek için sinir-sembolik bir çerçeve sunar. Videoyu açık ve örtük önermelere derleyerek, Lineer Zamanlı Mantık ilhamlı operatörlerle zamanlı ihlalleri analiz eder. İnsan algısıyla hizalı, kanıta dayalı raporlar üreterek mevcut bütüncül değerlendiricilerin sınırlılıklarını aşmayı hedefler.
Yeni bir çalışma, RNN'lerdeki uzun bağımlılık sorunlarının yalnızca gradyan patlamasından değil, gizli durumun rank kısıtlamalarından da kaynaklandığını gösteriyor. Araştırmacılar, zaman kapasitesini koruyan yapılandırılmış yüksek boyutlu durum dinamikleri öneriyor. Bu yaklaşım, standart RNN formülasyonu içinde kalarak hızlı öğrenme sağlıyor ve gradyan istikrarı tek başına yeterli olmadığını kanıtlıyor.
MoE-Context, yapay zeka ajanlarının her adımda tüm geçmişini okuması yerine, hızlı bir evet/hayır geçişiyle yalnızca o an ihtiyaç duyulan bağlam bloklarını seçmesini sağlar. Kalan bilgiler silinmeden tek satırlık notlar olarak saklanır. Qwen3-1.7B modeliyle yapılan testte, yalnızca gerekli bloğun gösterilmesi doğruluğu 120 üzerinden 93'ten 119'a çıkardı. Ancak modelin kendi seçim mekanizması zayıf kaldı ve basit anahtar kelime araması bu görevde mükemmel sonuç verdi.
CHORD, derin modellerin az temsil edilen gruplarda başarısız olmasına neden olan sahte korelasyonları çapraz görünüm uzlaşmasıyla azaltır. Yöntem, önyargı denetimi gerektirmeden farklı temsil alanlarındaki iç sınıf bölünmelerini birleştirerek hedef sınıflandırıcıyı düzeltir. Görüntü, dil ve tıbbi görüntüleme dahil yedi benchmark'ta en kötü grup doğruluğunda tutarlı iyileşmeler gösterilmiştir.
Invoker-Render, görsel vekilleri kullanarak fotorealistik video sentezini açık dünya durumu simülasyonundan ayırır. Model, yapısal vekiller, görünüm referansı ve dil üzerinden koşullandırma sağlar. ProForcing yöntemi, akışkan çıkarımda sürüklenmeyi azaltmak için dört adımlı bir renderere damıtma yapar.
IDEA, GUI ajanlarında adım düzeyinde arka kapı tespitini amaçlayan bir yöntemdir. Görsel tetikleyici ekranda belirip talimatın kontrolü kaybettiği anları, niyet kanıtı baskınlığındaki değişimle ölçer. Qwen2.5-VL-3B üzerinde beş saldırı ailesiyle test edilen sistem, tetikleyici bölgesini lokalize ederken makul bir çıkarım maliyeti ekler.
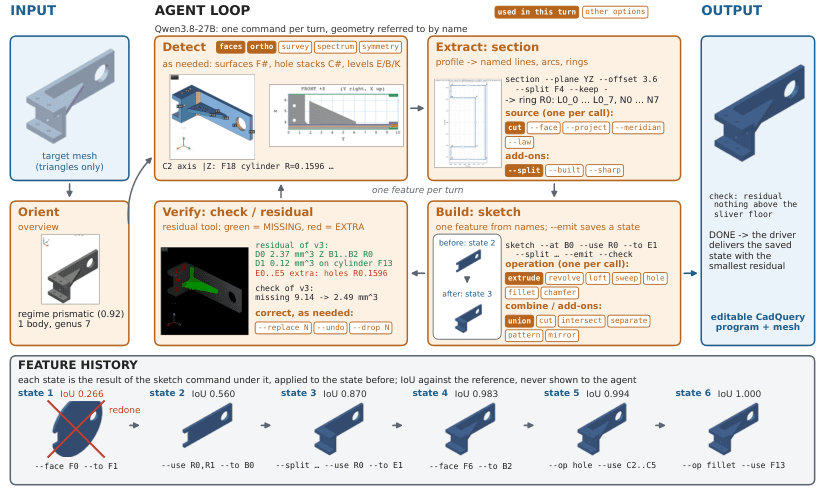
CADMAGEDDON, mesh verilerinden düzenlenebilir CAD modelleri üreten açık kaynak bir ajandır. Tek GPU'lu sistemlerde çalışarak veri gizliliği gerektiren CAD iş akışlarını destekler. Qwen3.8-27B modeliyle ana benchmarklarda önceki yöntemleri geride bırakır ve FreeCAD ile entegre çalışır.
AURA 2.0, akışkan video dil modeli olarak kullanıcıdan bağımsız konuşma başlatma, akışa duyarlı araç çağrısı ve etkileşimli görsel yerelleştirme yeteneklerini birleştirir. Model, görsel akıştaki anlamlı anları tespit edip uygun zamanda müdahale eder. Üç aşamalı eğitim şeması ve uzun vadeli etkileşim hafızası ile bağlamsal süreklilik sağlar. Açık kaynak akış modelleri arasında önde gelen performans gösterdiği iddia edilir.
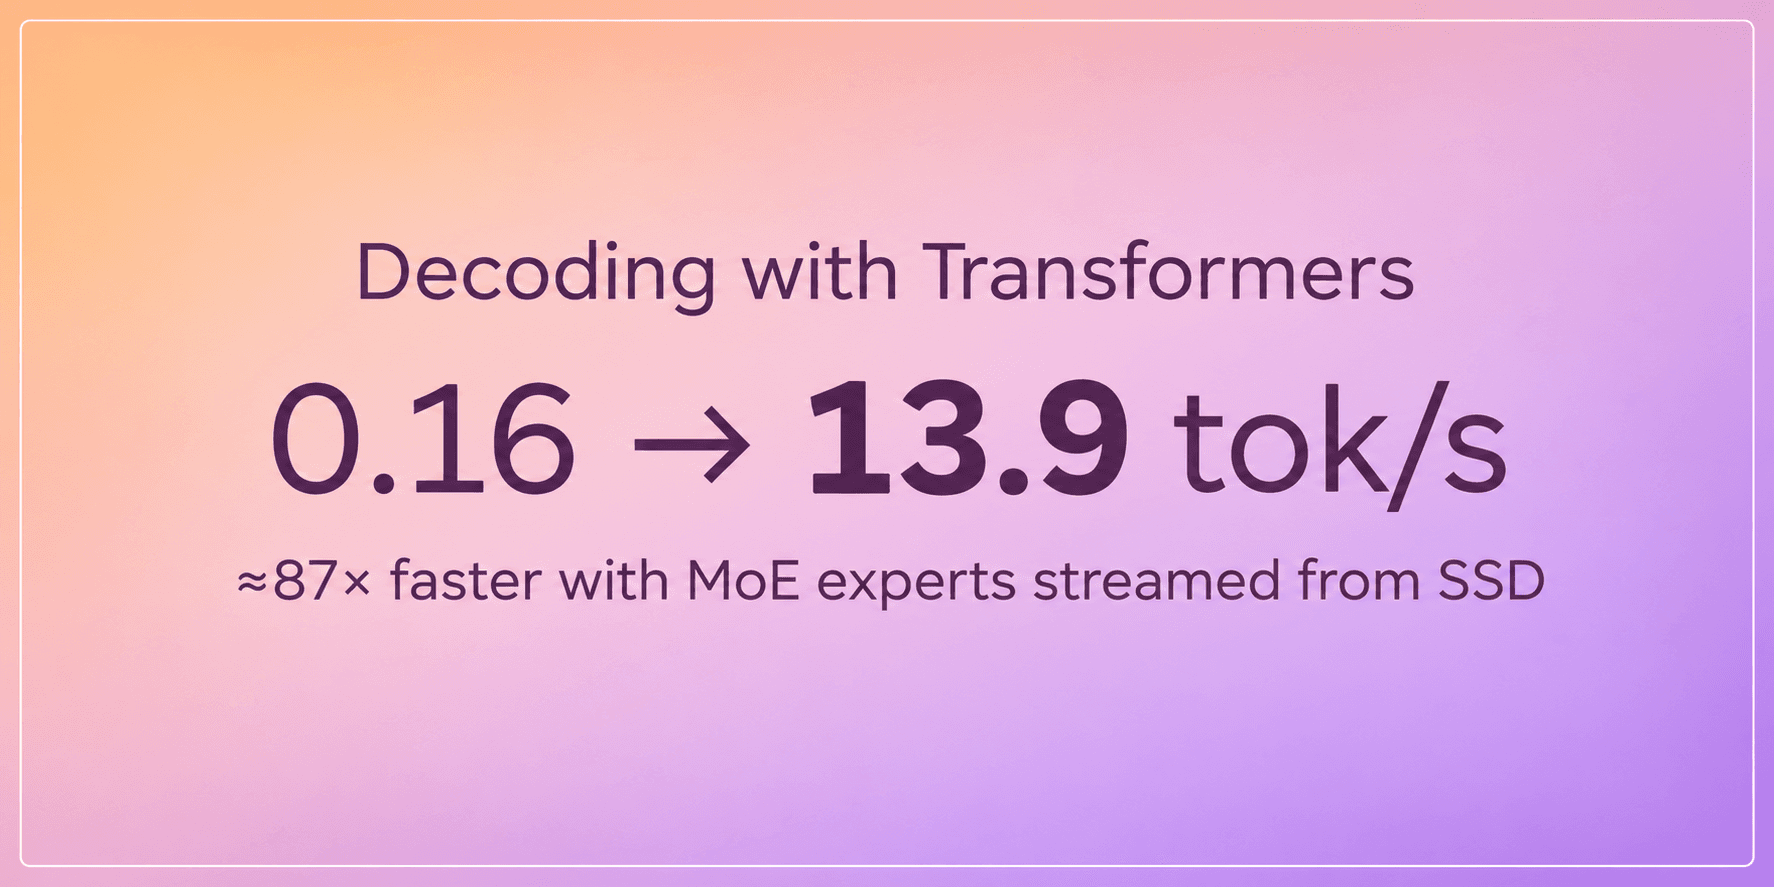
Tarek Ziadé, 180B parametreli MoE modellerini 32 GB RAM'li Mac'te Transformers kütüphanesiyle çalıştırmak için uzman akışlama mimarisi geliştirdi. Diskten okunan uzmanlar sınırlı bir önbellek havuzunda tutularak grouped_mm çekirdeğiyle işleniyor. Bu yöntem, Strata'nın performansına yaklaşarak yerel MoE çıkarımında bellek darboğazlarını aşmanın yeni bir yolunu gösteriyor.
Hugging Face1 dk okuma
37–48 / 166 yayın
Nasıl hazırlıyoruz?
Kaynağı belli. Sınırları açık.
Resmî duyuruları, araştırma makalelerini ve açık kaynak projelerinin sürüm notlarını yapay zekâ ile Türkçe özetliyoruz. Her haberde kaynak bağlantılarına, kullanım alanlarına ve açıklanmayan noktalara yer veriyoruz.
Doğrudan kaynak
Araştırma makalesine, model duyurusuna veya projenin deposuna haberden ulaşabilirsiniz.
Bulgular ve yorumlar
Kaynakta açıklanan sonuçları, olası kullanım alanları ve bilinmeyenlerden ayrı sunuyoruz.
Görsellerin kaynağı
Görsel ve videoların kaynağını belirtiyoruz. Konuyu anlatmak için kullanılan illüstrasyonları da işaretliyoruz.
Araştırma kaynakları
Makaleleri kendiniz keşfedin.
Yeni çalışmalar bulabileceğiniz dizinler ve araştırma laboratuvarları. Bir görsel özet ilginizi çekerse sonuçları özgün makaleden okuyun.