SLA, robot manipülasyonunda mekânsal anlayışı sürekli ön eğitim yoluyla ölçekleyen bir modeldir. pi05 politikasından başlatılan model, dondurulmuş 3D algılama modelinden gelen mekânsal temsillerle görsel gömümler arasında hizalama yapar. Heterojen robot verilerini birleştirerek farklı gövdeler ve görevler için mekânsal öğrenmeyi destekler. Tüm yardımcı bileşenler yalnızca eğitim sırasında kullanılır, bu da mevcut VLA ağırlıklarının doğrudan yeniden kullanılmasını sağlar.
Drex, otoregresif dil modellerinin üretimdeki tutarsızlık ve gecikme sorunlarını çözmek için tasarlanmış açık kaynak karar modeli ailesidir. 8B, 9B, 35B ve 27B parametreli dört modelden oluşan aile, girdi olarak durum ve seçenekler alıp olasılık dağılımı döner. RLAF tabanlı eğitim, doğruluğu ve seçenek sırasına karşı dayanıklılığı artırır. Max modeli, Decision Index'te yeni rekor kırarken, tipik isteklerde 183 ms yanıt süresiyle rakiplerinden belirgin şekilde hızlıdır.
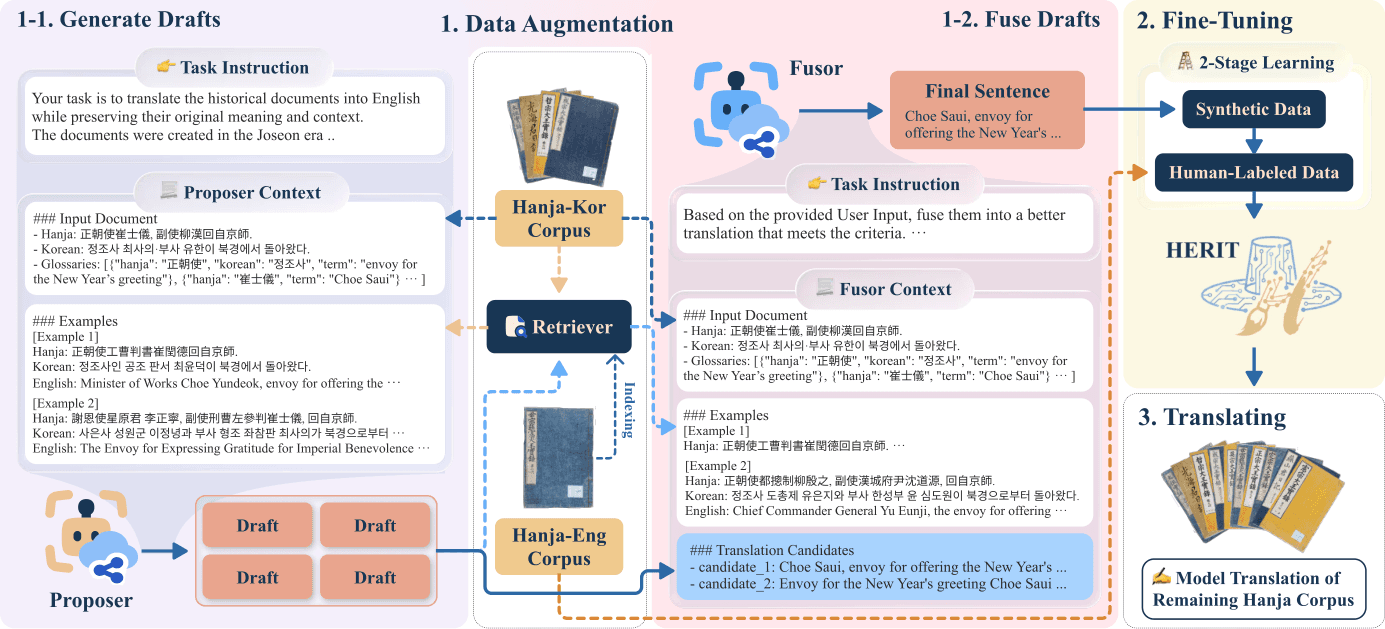
HERIT, Hanca-İngilizce tarihsel çeviride zaman dilimi önyargısını azaltmak için RAG tabanlı sahte etiketleme kullanır. Bu yöntem, sınırlı insan etiketli verinin neden olduğu sorunları ele alarak küresel erişimi kolaylaştırır ve EMNLP 2026 Findings'te kabul edilmiştir.
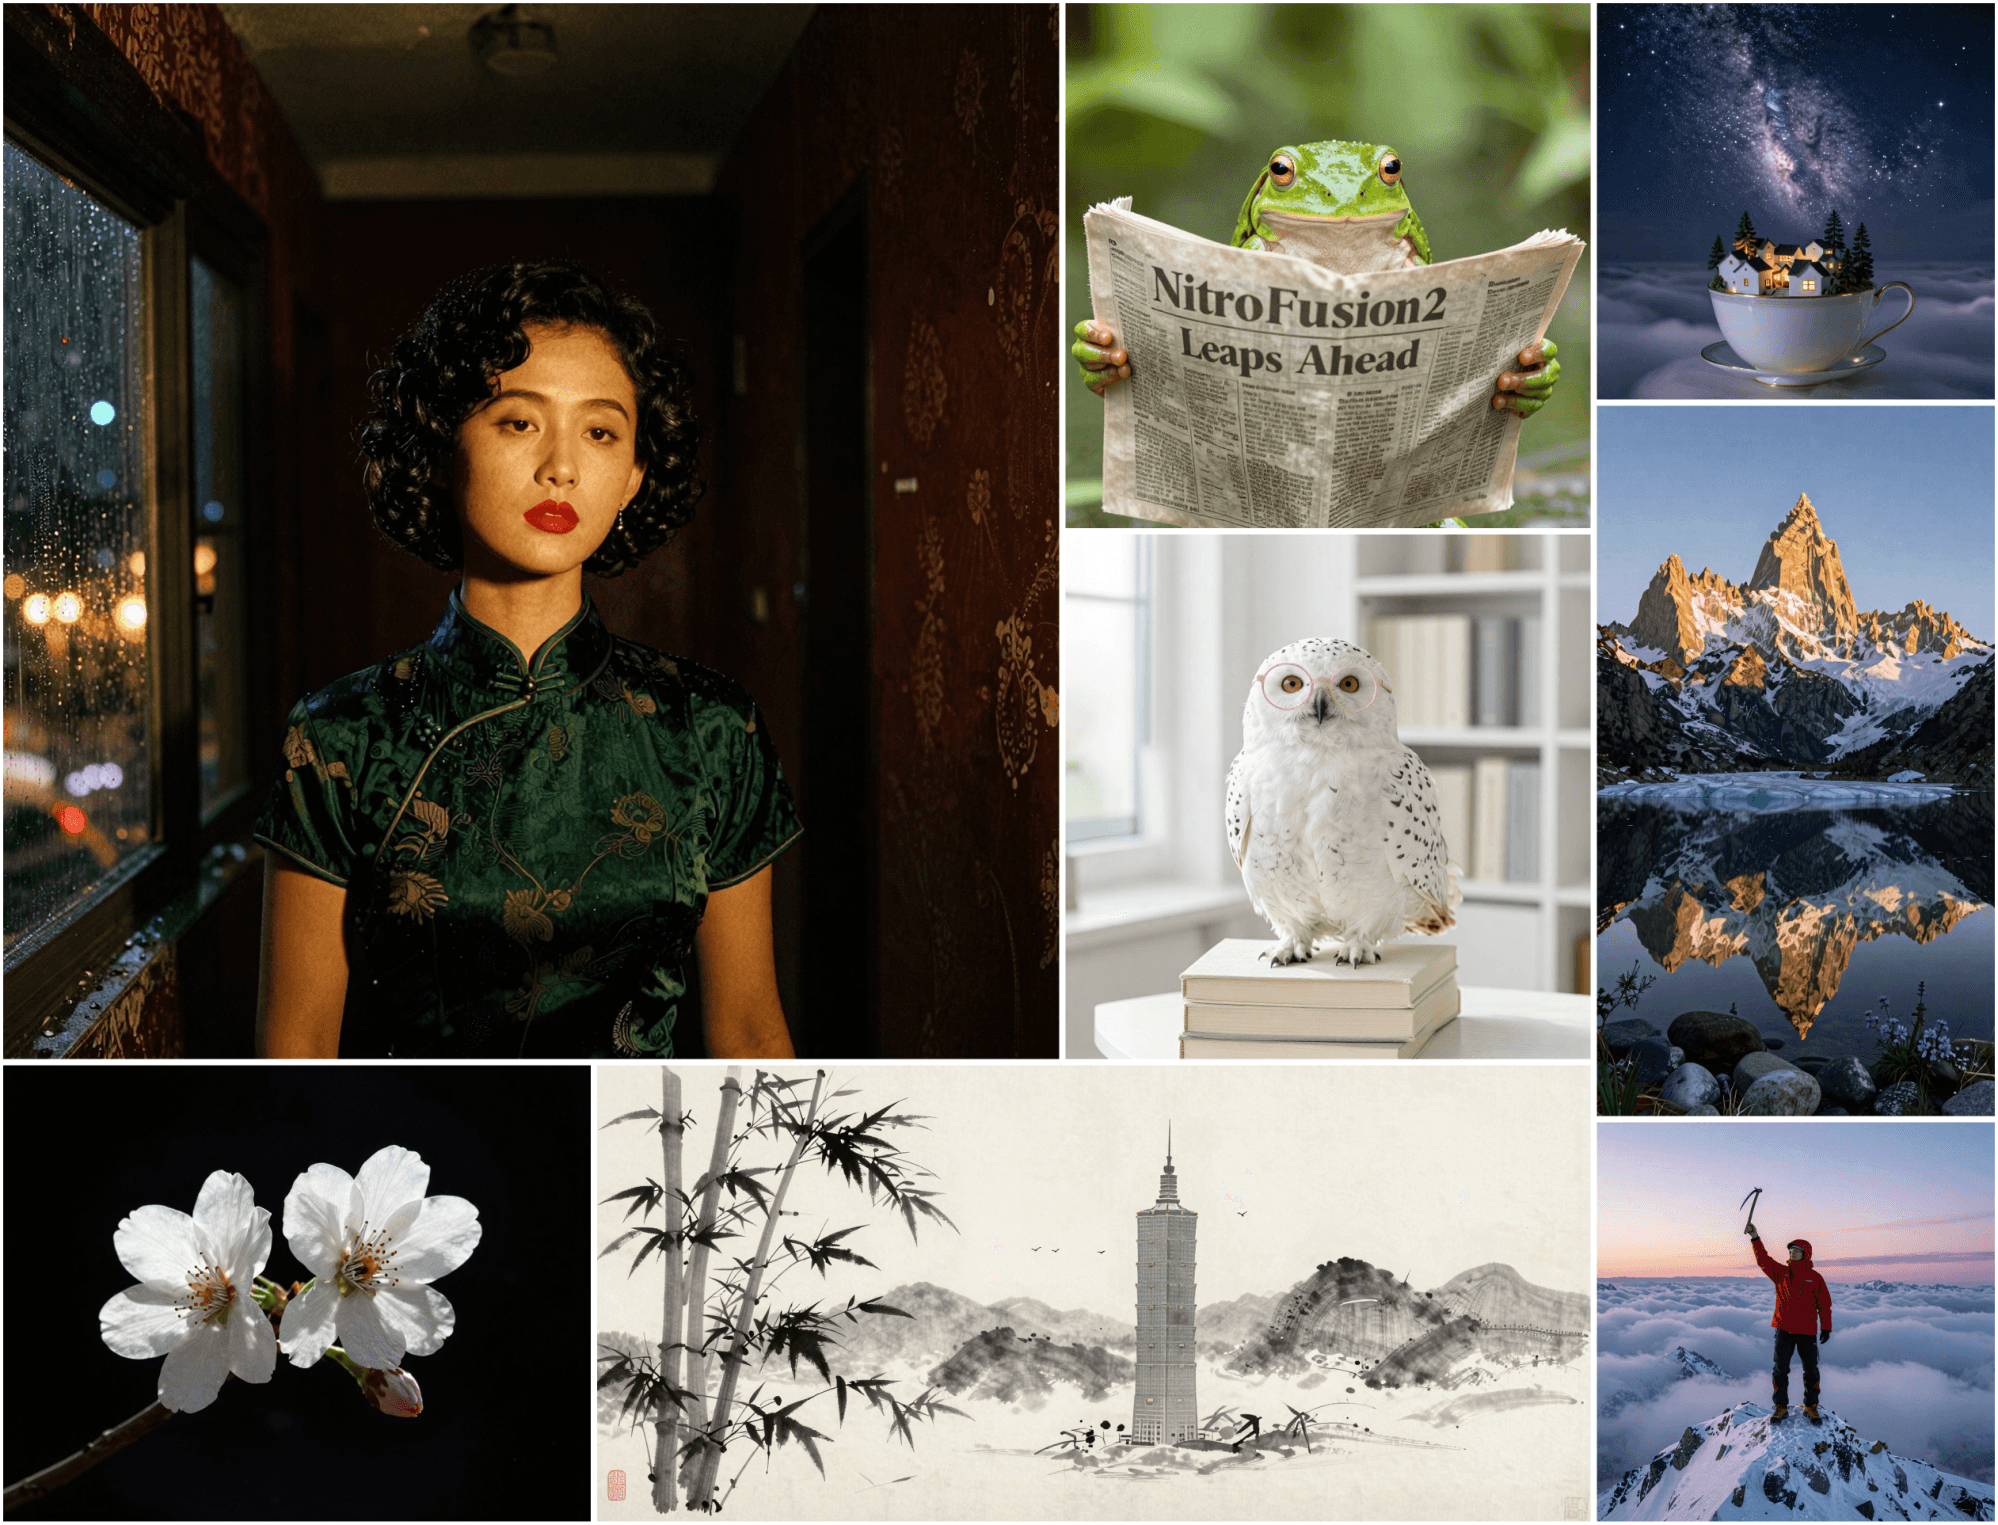
NitroFusion2, multimodal difüzyon transformatorlarında metin akışına adversarial kayıp ekleyerek distillation sürecini hızlandırır. TSAD ve ACD bileşenleri, tek adımda keskin metin ve detay üretimi sağlar.
Koopman Generative Operator, olasılıklı zaman serisi tahmininde yapısal belirsizliği tek adımla üretir. Koopman Patch Embedding ve Flow Matching bileşenleri, iteratif örneklemeyi atlayarak hız kazandırır. Bu yaklaşım, doğruluk ve verimlilik dengesini iyileştirerek pratik bir çerçeve sunar.
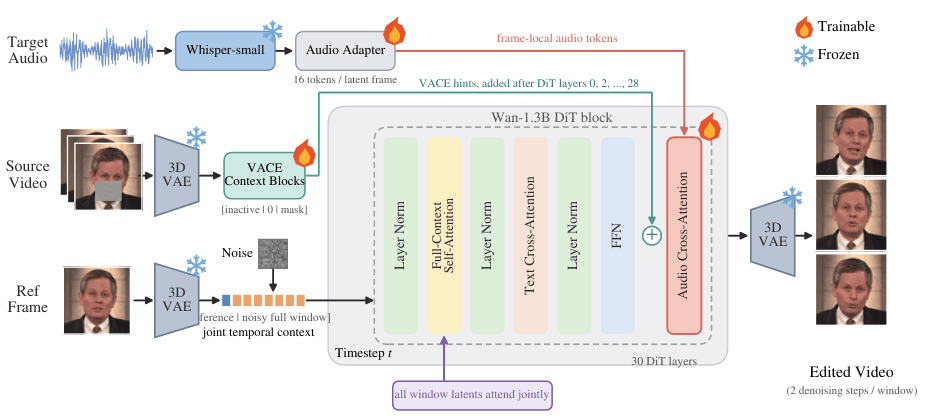
VidDub, video çeviri işlemlerinde kaynak ağız hareketlerinin hedef sesle çakışmasını çözen bir distilasyon yöntemidir. Model, tam çerçeve yeniden yapılandırma yerine çapraz ses senkronizasyonuna odaklanarak iki adımlık difüzyon sürecine indirgenir. Bu yaklaşım, görsel kaliteyi ve kimlik bütünlüğünü korurken işlem hızını artırır. Araştırmacılar, eğitim verisi ve değerlendirme kodunu açık kaynak olarak paylaşmayı planlamaktadır.
LiveFoley, akışkan video-ses üretiminde gerçek zamanlı kısıtlamaları aşan yeni bir mimari sunar. Trailing Sliding Window ve History LocDiT bileşenleri, gecikmeyi insan algı eşiğinin altında tutarken ses-görüntü hizalamasını korur. Çalışma, çevrimdışı modellerle eşdeğer zamanlama ve akış sistemlerinde üstün kalite iddiasında bulunur.
UniRestorer++, çok granüler bozulma modellemesiyle evrensel görüntü onarımında ölçeklenebilirlik sorununu ele alır. Derinlik ve genişlik artışındaki doygunluğu aşmak için grup bazlı uzmanlar ve yoğun uzamsal temsil kullanır. CDD-50 benchmark'ı ile 50 bozulma kategorisini kapsar ve dağıtım dışı girdilerde sağlam performans gösterir.
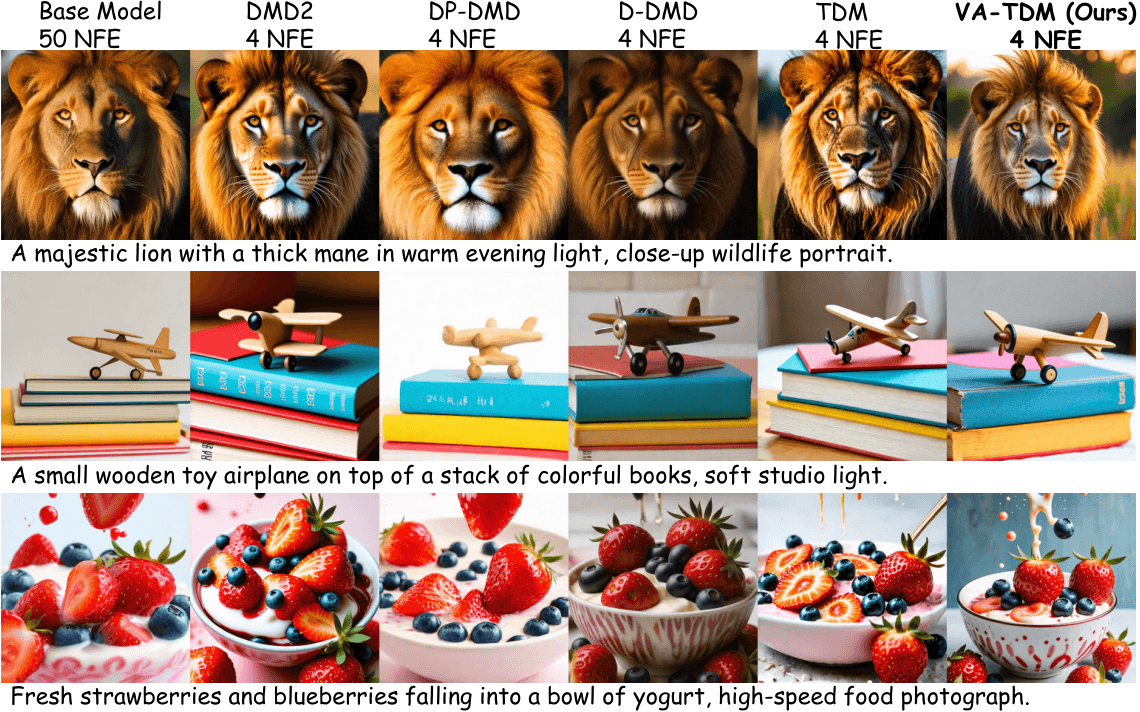
VA-TDM, az adımlı difüzyon modellerinde kaliteyi korumak için hız adversarial distilasyonunu birleştirir. Yöntem, öğrenci dağılımının takibindeki zorlukları aşarak metinden görüntüye ve videoya üretimde dört adımlık süreçte en iyi performansı sağlar. 33B MiniMax-H3 ölçeğinde ölçeklenebilirlik gösteren bu yaklaşım, mevcut distilasyon tekniklerini tek bir çerçevede birleştirir.
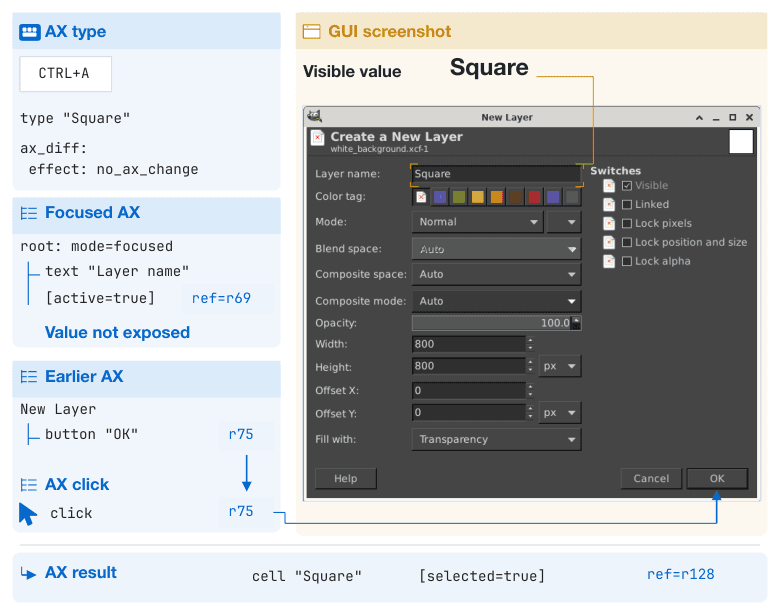
Hybrid Computer Use (HCU), genel ajanlar için programatik, semantik ve görsel etkileşimi birleştiren yeni bir arayüz sunar. Ekran görüntüsü bağımlılığını azaltarak daha verimli görev tamamlama hedefler. OSWorld 2.0'da karşılaştırılan sistemler arasında en yüksek puanları alarak kanal seçiminin önemini kanıtlar.
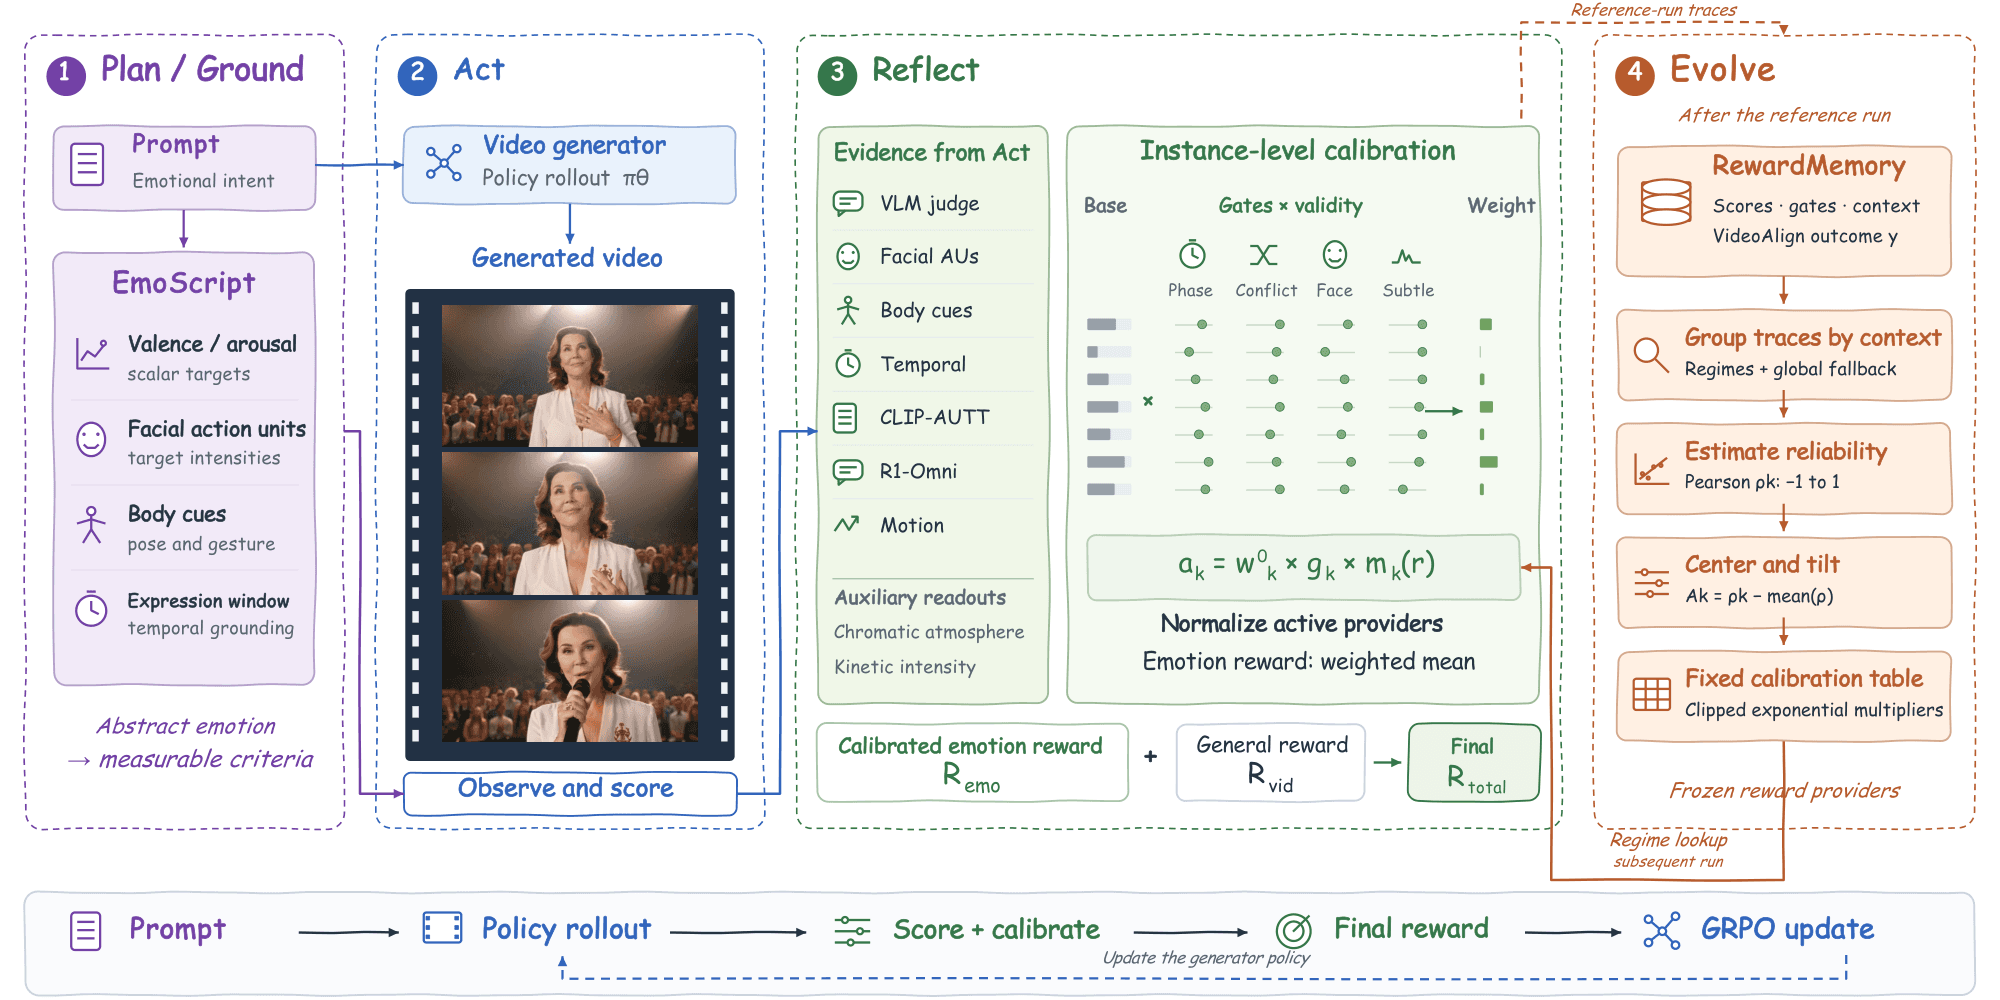
EmoReward, video üretiminde duygusal ifadeyi iyileştirmek için ödül kalibrasyonunu otomatikleştiren bir mekanizmadır. GRPO tabanlı eğitimlerde sabit ödüllerin yetersiz kaldığı durumlarda, eğitim izlerinden öğrenerek ağırlıkları dinamik olarak ayarlar. Bu yaklaşım, ödül avcılığı riskini azaltır ve farklı duygusal bağlamlarda daha tutarlı sonuçlar hedefler.
TurnWise, akışkan video anlayışında GRPO'yu turn-level kredi atamasıyla geliştirir. Yöntem, sessizlikle tamamlanan önek puanlamasıyla her kararın kalan getirisinden grup-göreceli avantajlar oluşturur. Turn-ortalama politika optimizasyonu, çıktı uzunluğundan bağımsız olarak yanıt ve bekleme kararlarına eşit ağırlık verir. Bu tasarım, öğrenme sinyalini önceki ödüllerden ayırarak gereksiz tekrarları azaltır ve bilgilendirici yanıtları teşvik eder. Ekstra rollout veya öğrenilmiş kritik gerektir.
arXiv1 dk okuma
37–48 / 100 yayın
Nasıl hazırlıyoruz?
Kaynağı belli. Sınırları açık.
Resmî duyuruları, araştırma makalelerini ve açık kaynak projelerinin sürüm notlarını yapay zekâ ile Türkçe özetliyoruz. Her haberde kaynak bağlantılarına, kullanım alanlarına ve açıklanmayan noktalara yer veriyoruz.
Doğrudan kaynak
Araştırma makalesine, model duyurusuna veya projenin deposuna haberden ulaşabilirsiniz.
Bulgular ve yorumlar
Kaynakta açıklanan sonuçları, olası kullanım alanları ve bilinmeyenlerden ayrı sunuyoruz.
Görsellerin kaynağı
Görsel ve videoların kaynağını belirtiyoruz. Konuyu anlatmak için kullanılan illüstrasyonları da işaretliyoruz.
Araştırma kaynakları
Makaleleri kendiniz keşfedin.
Yeni çalışmalar bulabileceğiniz dizinler ve araştırma laboratuvarları. Bir görsel özet ilginizi çekerse sonuçları özgün makaleden okuyun.