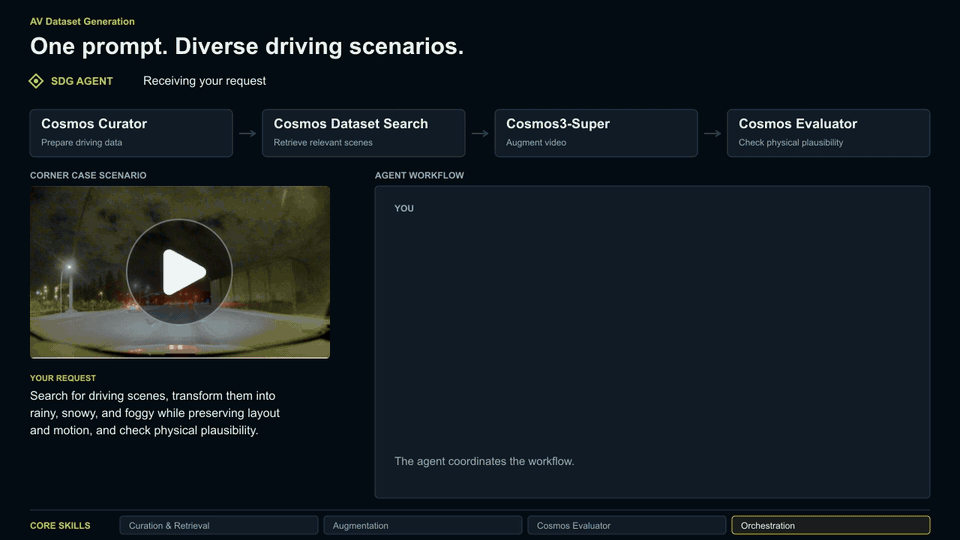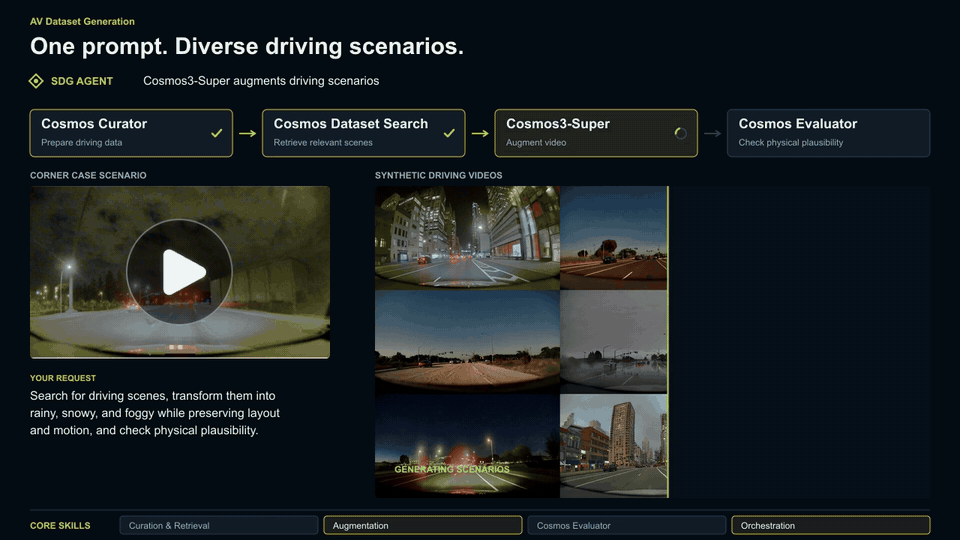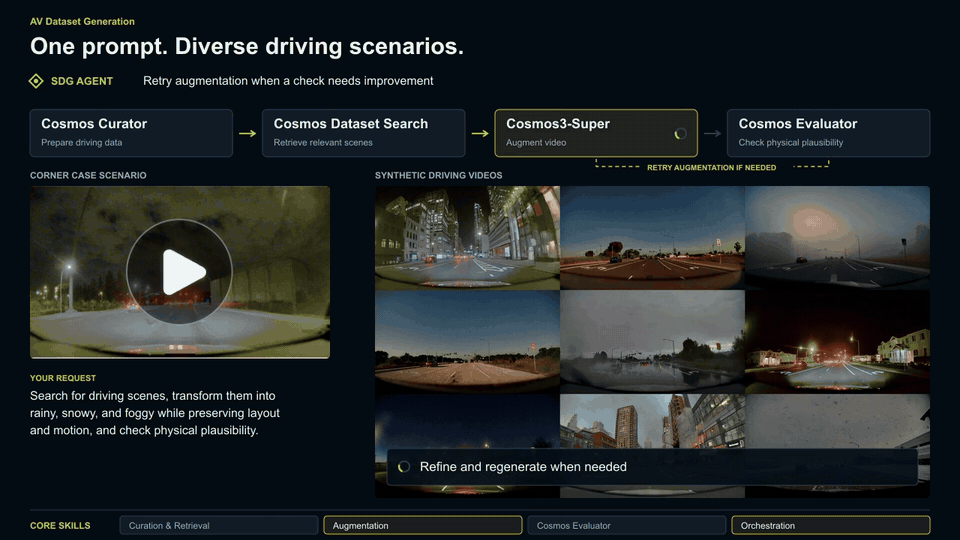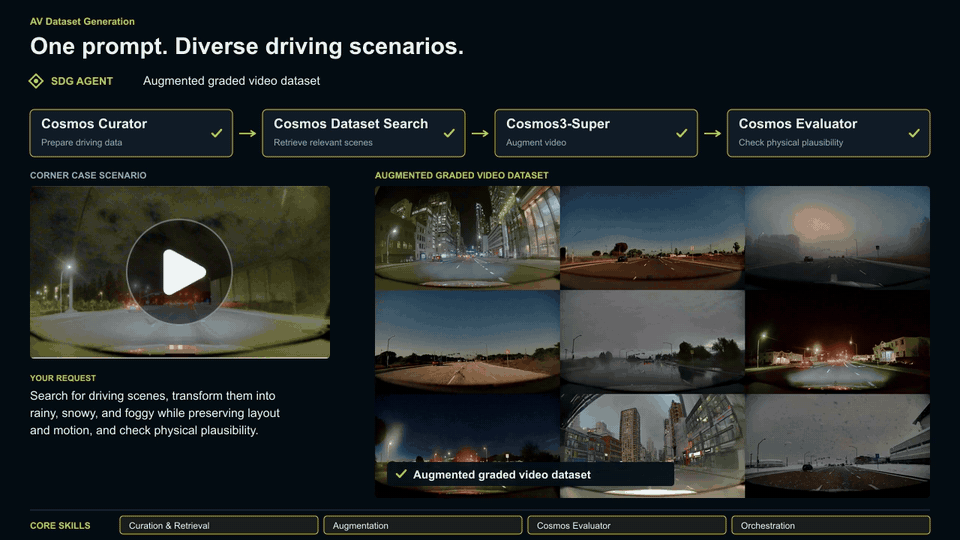
NVIDIA Cosmos Data Factory, kodlama ajanları aracılığıyla iki komutla fiziksel yapay zeka için eğitim verisi üretmeyi kolaylaştırır. Platform, otonom araç senaryoları, görüntü artırma ve nadir olay üretimi gibi beş kullanım senaryosunu destekler. NVIDIA, bu yaklaşımın veri üretim maliyetini ve süresini önemli ölçüde azalttığını ölçtü.
IBM ve Confluent, zaman serisi temel modellerini Confluent platformuna yerleştirdi. Bu modeller, Apache Flink ile akış verilerinde tahmin, anomali tespiti ve optimizasyon sağlar. CPU tabanlı çalışma, GPU gereksinimini ortadan kaldırarak bulut ve yerel kurulumlarda gerçek zamanlı karar destek sistemlerini erişilebilir kılar.
Ambient SFT, otoregresif dil modellerinde küçük veri setleriyle yapılan denetimli ince ayarın neden olduğu aşırı öğrenmeyi ve felaketçi unutmayı önlemek için tasarlanmış bir çerçevedir. Dondurulmuş ön eğitimli model, kaba düzeyde eşleşmesi gereken gürültülü bir öğretmen olarak kullanılır. Yüksek sıcaklıkta koşullu dağılımların eşleşmesi, ön eğitimli modele duyulan güveni kontrol eder. Yöntem, standart SFT'ye kıyasla ortalama yüzde 21'e varan göreli iyileşme göstermiştir.
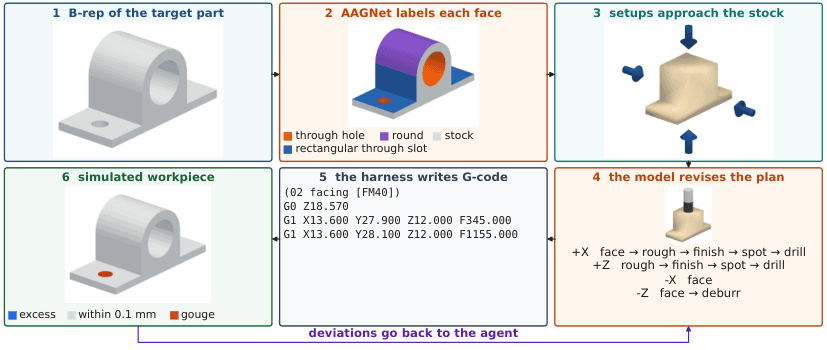
MillBill, CAD modellerini işleme programlarına dönüştüren yeni bir yapay zeka ajanıdır. Sistem, işleme kararlarını geometrik yürütme ve doğrulamadan ayırır. Yerel bir orta ölçekli model operasyonları önerirken, ayrı bir geometrik çerçeve takım yollarını üretir ve simülasyon geri bildirimi sağlar. Bu yaklaşım, sayısal doğruluğu modelin doğrudan yükünden çıkarır.
Bu çalışma, büyük dil modellerindeki sosyal önyargıyı belirli dikkat başlarına atfeden ve bunları ablatasyonla kaldıran yöntemlerin geçerliliğini denetler. Qwen-2.5-7B-Instruct ve Llama-3.1-8B-Instruct üzerinde yapılan analiz, bu başlık haritalarının aslında yanıt uzunluğu gibi yüzey özellikleriyle korele olduğunu gösterir. Müdahale deneyleri, istem kimliğinin varyansın büyük kısmını açıkladığını ve etiket ile uzunluğun doğrusal bağımlı olduğunu ortaya koyar.
AscendGYM, Ascend NPU'lar üzerinde büyük dil modelleri için çekirdek optimizasyonunu ölçen yeni bir benchmark'tır. Gerçek dünya iş yüklerinden türetilen 48 çekirdek ve maliyet-farkındalıklı STS metriği ile ajanların mevcut implementasyonları iyileştirme yeteneğini değerlendirir.
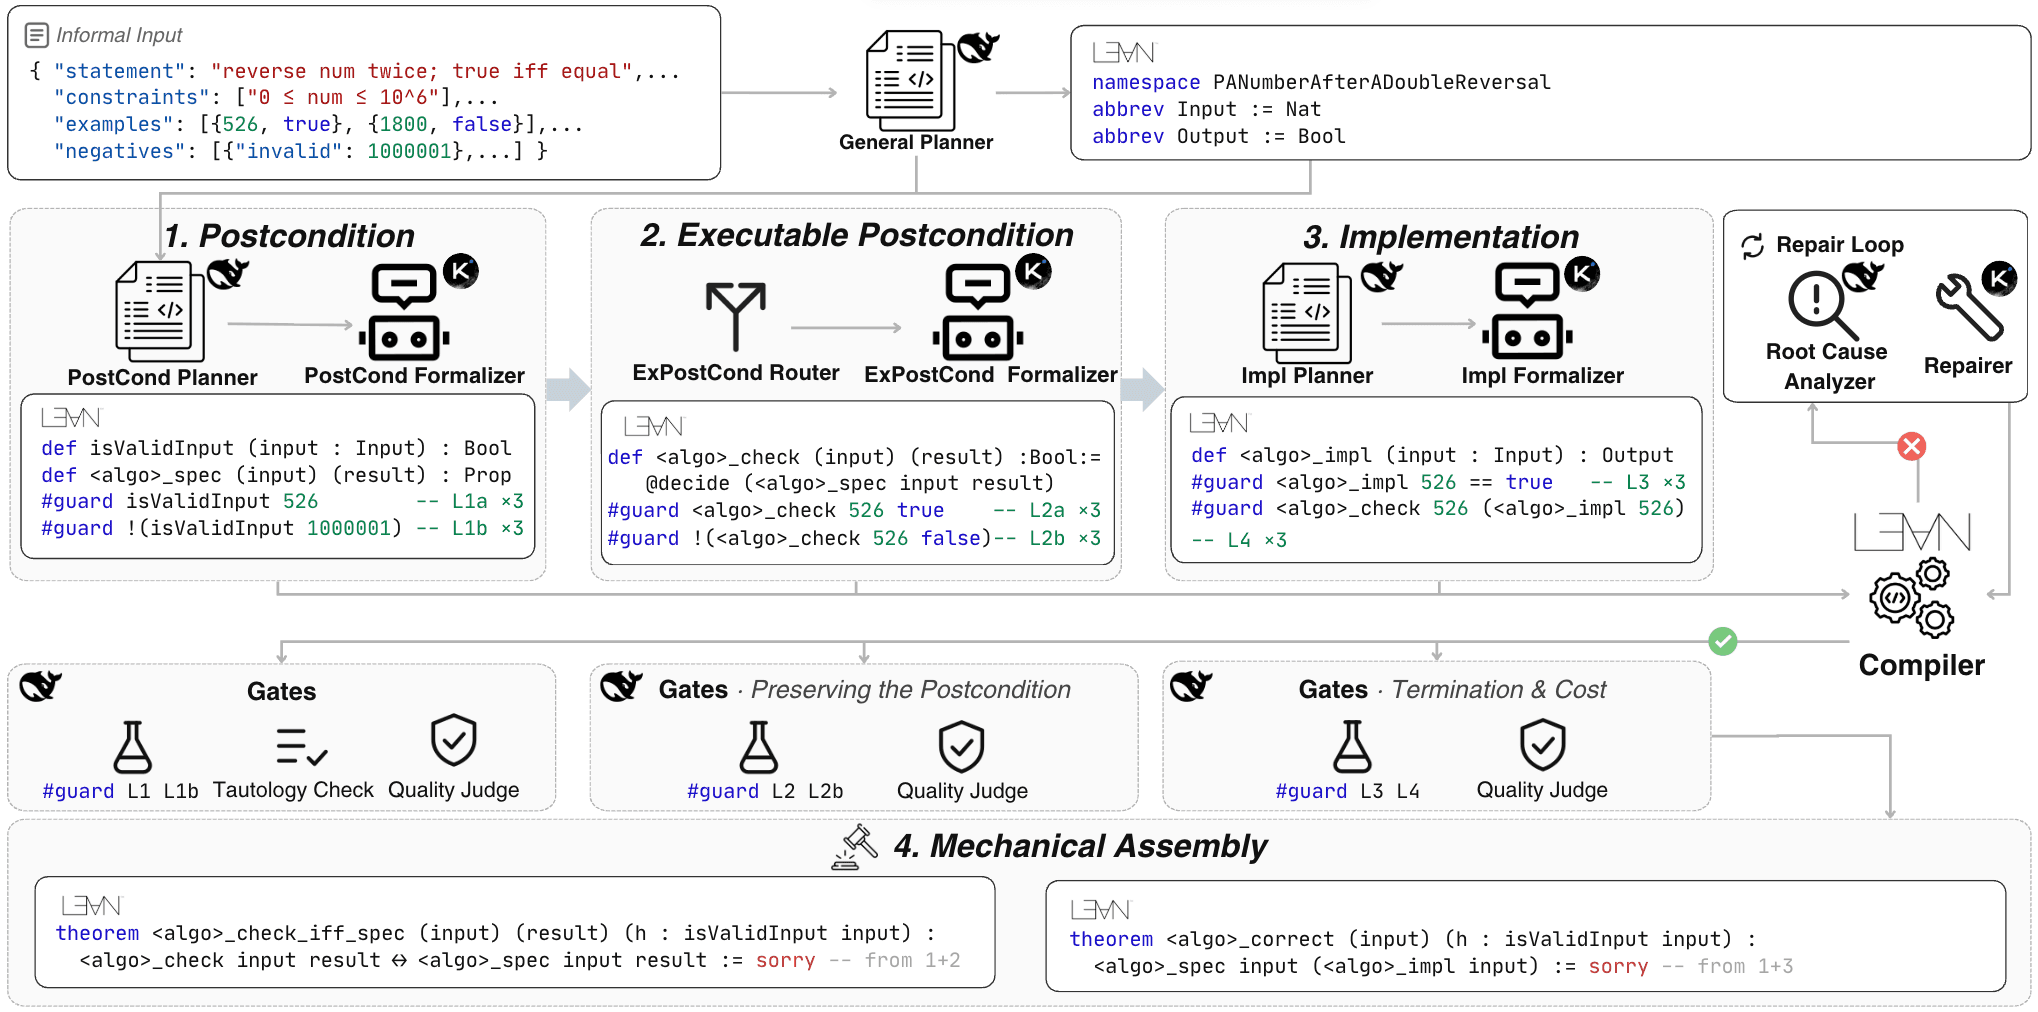
AuXSpec, program spesifikasyonlarını otomatik olarak formelleştirmek için çalıştırılabilir son koşullar kullanan bir Lean çerçevesidir. Doğal dildeki problemlerden formel spesifikasyon üretmek, doğrulama süreçlerindeki en büyük darboğazlardan biridir. Bu çalışma, spesifikasyonların davranışını test ederek geri bildirim sağlama yöntemiyle, formel doğrulama modellerinin eğitimini ölçeklenebilir hale getirir.
Heave-Ho, insansı robotların uzun vadeli işbirliğini merkezi ağ iletişimi olmadan yöneten dağıtık bir çerçevedir. Düşük seviyede çoklu ajan post-eğitimi, yüksek seviyede ise ses tabanlı lider-takipçi koordinasyonu kullanır. İki robotla eğitilen sistem, on robota kadar ölçeklenir ve HH-Bench'teki 12 görevde taban yöntemleri geride bırakır.
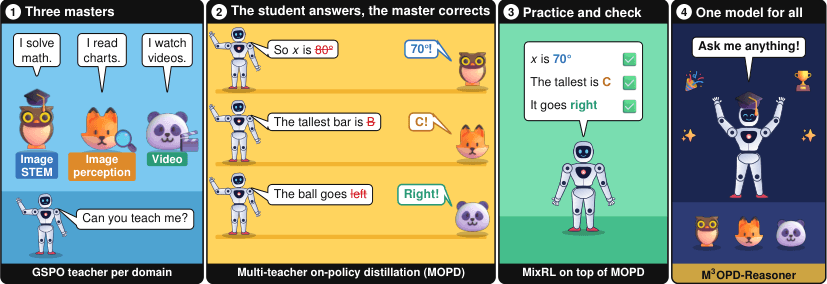
M3OPD-Reasoner, görsel-dil modelleri için çoklu öğretmen politikası içi damıtma (MOPD) tabanlı açık bir eğitim tarifi sunar. Qwen3.5-9B tabanlı model, görsel STEM, algı ve video alanlarında uzmanlaşmış öğretmenlerden öğrenir. MOPD sonrası MixRL uygulanarak M3OPD-Reasoner-9B elde edilir; tüm veriler ve kodlar açık kaynak olarak paylaşılmıştır.
Bu çalışma, Japonca klinik metinlerde ad varlığı tanıma (NER) için BERT tabanlı modelleri ve açık ağırlıklı LLM'leri karşılaştırıyor. 13B parametreden büyük LLM'ler, ince ayar ve yeterli çıktı token sınırıyla BERT'i geride bırakırken, sıfır atış performansları düşük kaldı.
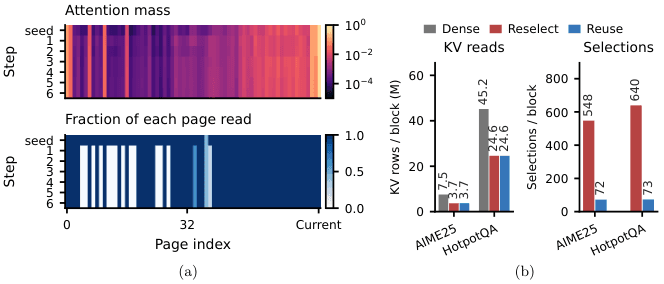
RISA, blok tabanlı difüzyon dil modellerinde uzun bağlam çıkarımını hızlandıran geri alınabilir seyrek dikkat yöntemidir. Geçmiş KV önbelleğinin blok içinde sabit kalmasını kullanarak okuma planlarını paylaşır ve tekrarlı destek inşasını azaltır. DreamReasoner-8B üzerinde görev performansını korurken dikkat hızını önemli ölçüde artırır.
arXiv'de yayımlanan çalışma, büyük dil modeli ajanlarının dışarıdan dayatılmış bir döngü olmadan kendi kendini iyileştirme algoritmalarını nasıl oluşturduğunu inceli. Oyun ortamında test edilen dondurulmuş bir LLM ajanı, temel kaynaklarla kendi öğrenme stratejisini geliştirir. Bu stratejiler klasik bilişsel çerçevelerle uyumludur ve farklı oyun mekaniklerine aktarılabilir.
arXiv1 dk okuma
49–60 / 166 yayın
Nasıl hazırlıyoruz?
Kaynağı belli. Sınırları açık.
Resmî duyuruları, araştırma makalelerini ve açık kaynak projelerinin sürüm notlarını yapay zekâ ile Türkçe özetliyoruz. Her haberde kaynak bağlantılarına, kullanım alanlarına ve açıklanmayan noktalara yer veriyoruz.
Doğrudan kaynak
Araştırma makalesine, model duyurusuna veya projenin deposuna haberden ulaşabilirsiniz.
Bulgular ve yorumlar
Kaynakta açıklanan sonuçları, olası kullanım alanları ve bilinmeyenlerden ayrı sunuyoruz.
Görsellerin kaynağı
Görsel ve videoların kaynağını belirtiyoruz. Konuyu anlatmak için kullanılan illüstrasyonları da işaretliyoruz.
Araştırma kaynakları
Makaleleri kendiniz keşfedin.
Yeni çalışmalar bulabileceğiniz dizinler ve araştırma laboratuvarları. Bir görsel özet ilginizi çekerse sonuçları özgün makaleden okuyun.

 Video