AscendGYM, Ascend NPU'lar üzerinde büyük dil modelleri için çekirdek optimizasyonunu ölçen yeni bir benchmark'tır. Gerçek dünya iş yüklerinden türetilen 48 çekirdek ve maliyet-farkındalıklı STS metriği ile ajanların mevcut implementasyonları iyileştirme yeteneğini değerlendirir.
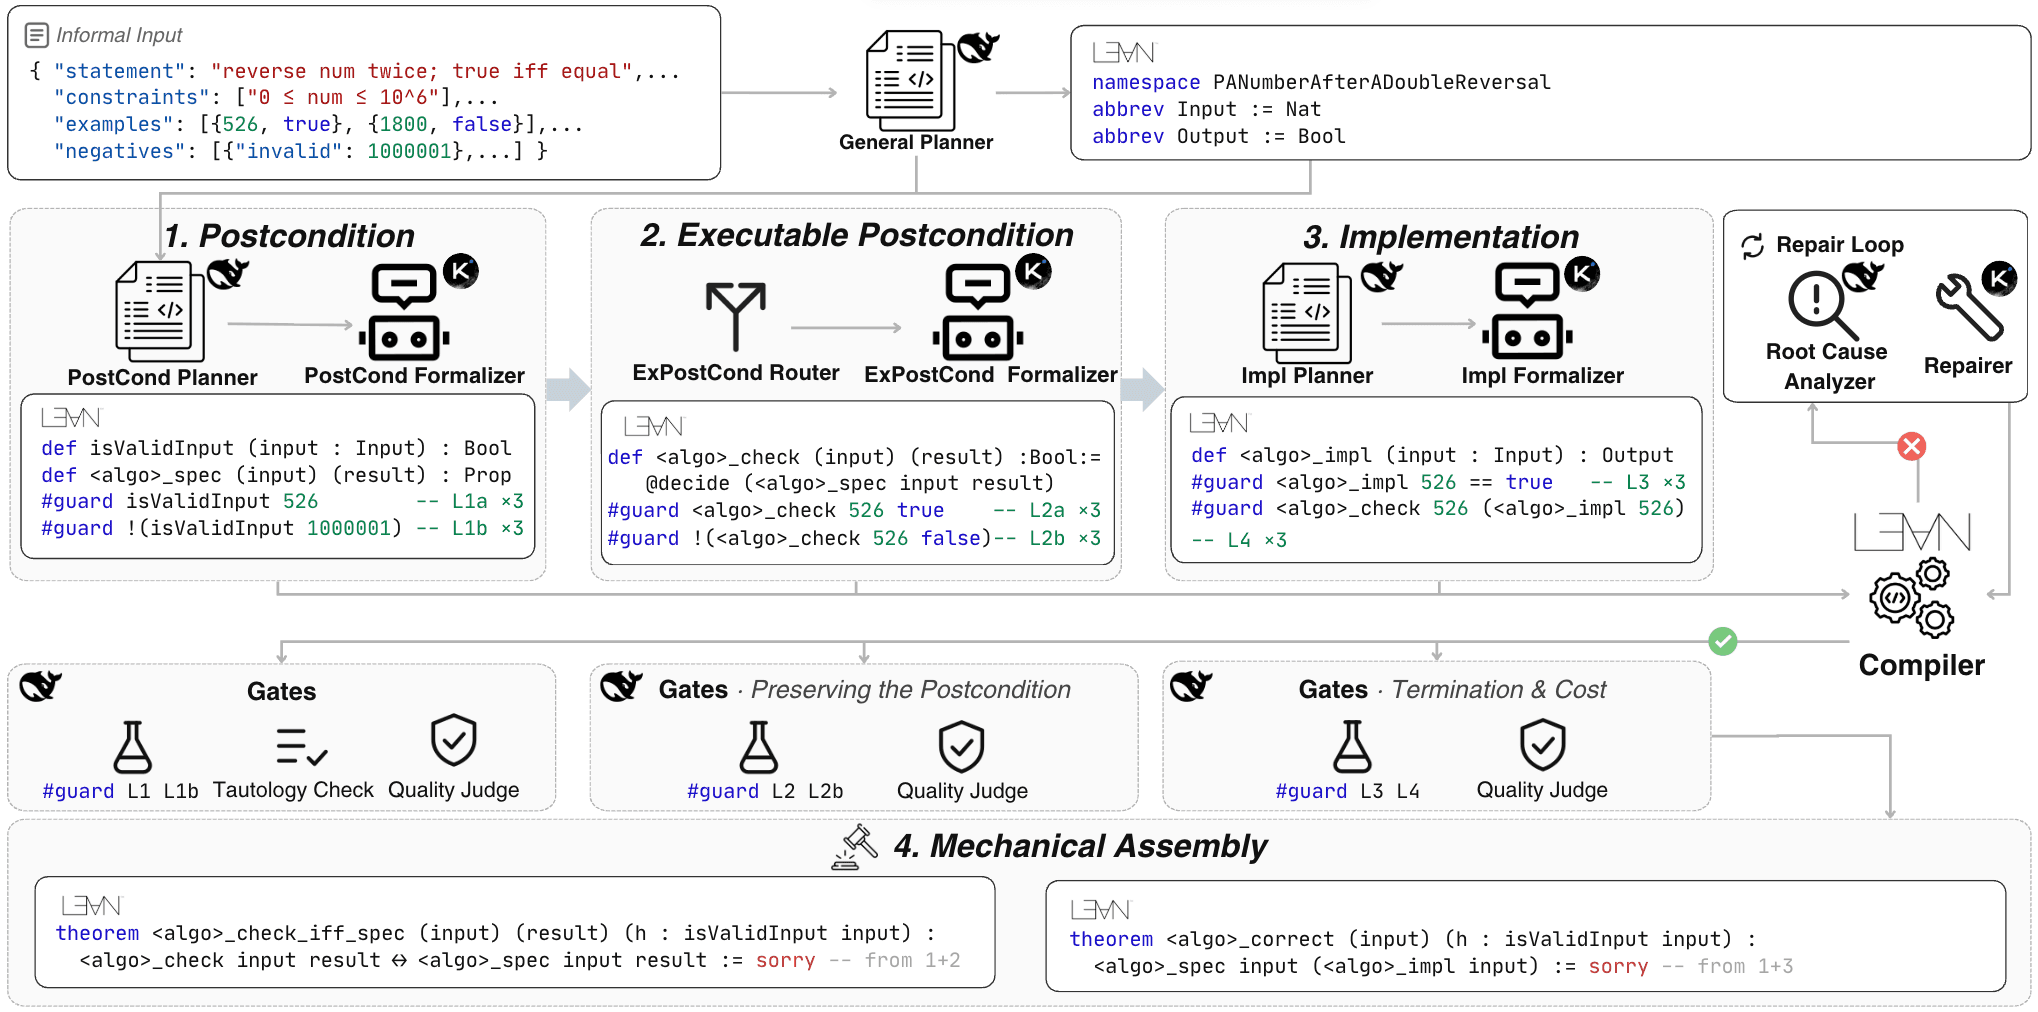
AuXSpec, program spesifikasyonlarını otomatik olarak formelleştirmek için çalıştırılabilir son koşullar kullanan bir Lean çerçevesidir. Doğal dildeki problemlerden formel spesifikasyon üretmek, doğrulama süreçlerindeki en büyük darboğazlardan biridir. Bu çalışma, spesifikasyonların davranışını test ederek geri bildirim sağlama yöntemiyle, formel doğrulama modellerinin eğitimini ölçeklenebilir hale getirir.
Heave-Ho, insansı robotların uzun vadeli işbirliğini merkezi ağ iletişimi olmadan yöneten dağıtık bir çerçevedir. Düşük seviyede çoklu ajan post-eğitimi, yüksek seviyede ise ses tabanlı lider-takipçi koordinasyonu kullanır. İki robotla eğitilen sistem, on robota kadar ölçeklenir ve HH-Bench'teki 12 görevde taban yöntemleri geride bırakır.
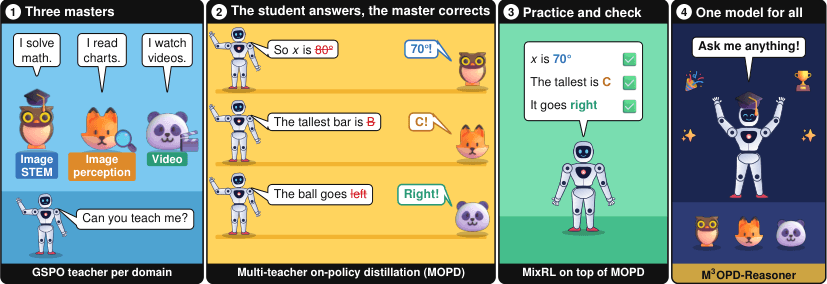
M3OPD-Reasoner, görsel-dil modelleri için çoklu öğretmen politikası içi damıtma (MOPD) tabanlı açık bir eğitim tarifi sunar. Qwen3.5-9B tabanlı model, görsel STEM, algı ve video alanlarında uzmanlaşmış öğretmenlerden öğrenir. MOPD sonrası MixRL uygulanarak M3OPD-Reasoner-9B elde edilir; tüm veriler ve kodlar açık kaynak olarak paylaşılmıştır.
Bu çalışma, Japonca klinik metinlerde ad varlığı tanıma (NER) için BERT tabanlı modelleri ve açık ağırlıklı LLM'leri karşılaştırıyor. 13B parametreden büyük LLM'ler, ince ayar ve yeterli çıktı token sınırıyla BERT'i geride bırakırken, sıfır atış performansları düşük kaldı.
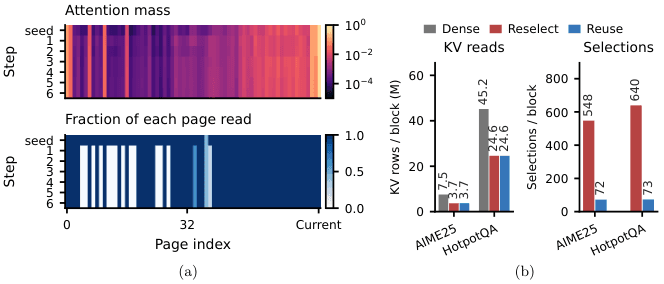
RISA, blok tabanlı difüzyon dil modellerinde uzun bağlam çıkarımını hızlandıran geri alınabilir seyrek dikkat yöntemidir. Geçmiş KV önbelleğinin blok içinde sabit kalmasını kullanarak okuma planlarını paylaşır ve tekrarlı destek inşasını azaltır. DreamReasoner-8B üzerinde görev performansını korurken dikkat hızını önemli ölçüde artırır.
arXiv'de yayımlanan çalışma, büyük dil modeli ajanlarının dışarıdan dayatılmış bir döngü olmadan kendi kendini iyileştirme algoritmalarını nasıl oluşturduğunu inceli. Oyun ortamında test edilen dondurulmuş bir LLM ajanı, temel kaynaklarla kendi öğrenme stratejisini geliştirir. Bu stratejiler klasik bilişsel çerçevelerle uyumludur ve farklı oyun mekaniklerine aktarılabilir.
Eğitim amaçlı büyük dil modellerinde güvenlik, yalnızca içerik engellemeyle sınırlı kalmamalıdır. EGS, öğrenci sorgularındaki belirsizlikleri yönetmek için sorgu moderasyonu, senaryo farkındalıklı pedagojik yönlendirme ve çıktı denetimi içeren model-agnostik bir çerçeve sunar. Bu yaklaşım, ikili reddetme mekanizmalarının ötesine geçerek bağlamsal rehberlik sağlar.
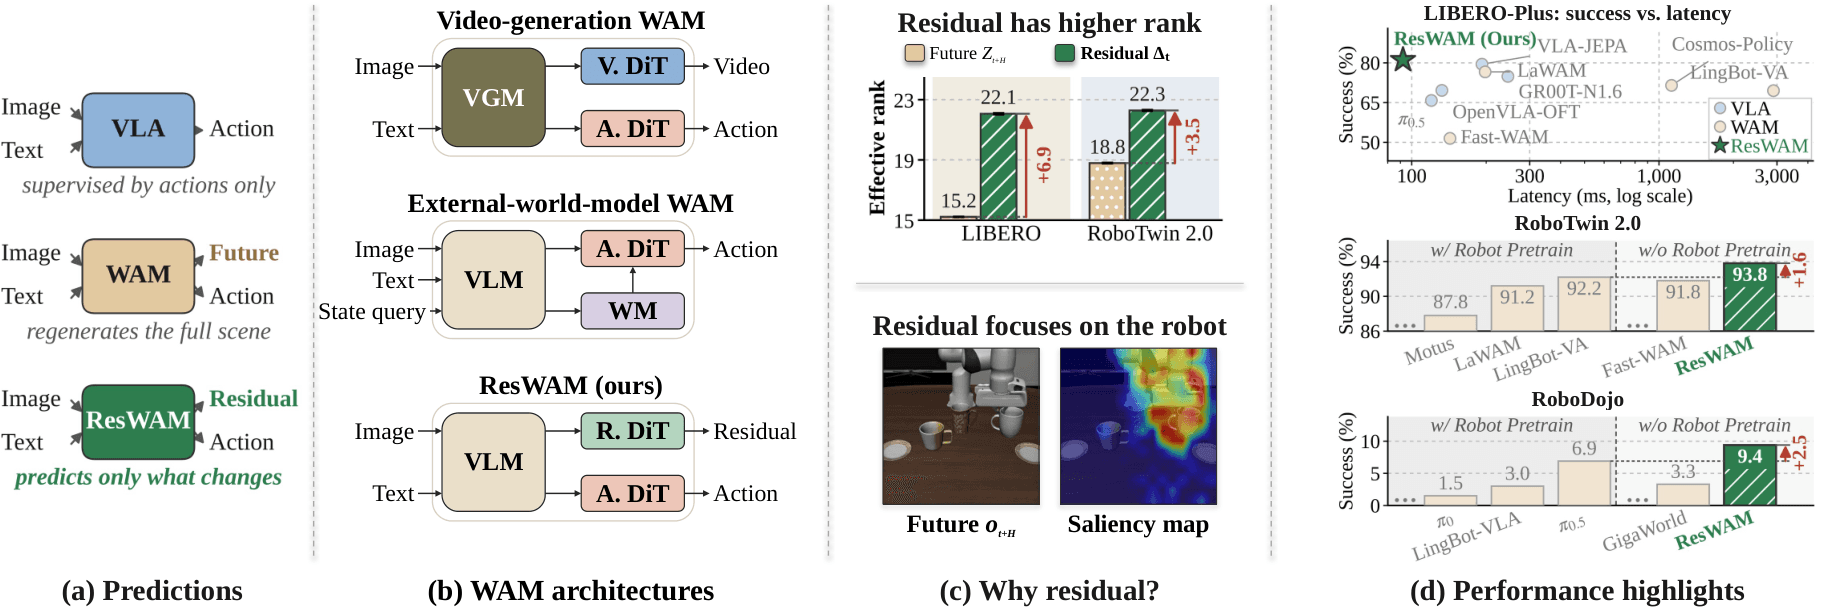
ResWAM, dünya-aksiyon modellerinde gelecekteki tam gözlemler yerine yalnızca değişen görsel artıkları öğrenir. Bu yaklaşım, statik arka plan gürültüsünü azaltır ve robotik görevlerde daha verimli temsil öğrenimini sağlar. 2.3B parametreli model, düşük hesaplama maliyetiyle simülasyon ve gerçek robot testlerinde yüksek başarı oranları gösterir.
Çalışma, çoklu ajan dil modellerinin tek geçişli temellerle karşılaştırılmasında koordinasyon, örnek çoğulluğu ve çıkarım hesaplama kaynaklarının karıştığını gösterir. Dokuz ampirik değerlendirmenin sentezinde, örnek sayısı eşitlendiğinde çoklu ajan sistemlerinin doğruluğu ortalama -0.042 olarak ölçülmüştür. İletişimin faydası, ajanların aynı kanıtları paylaşması durumunda ortadan kalkar; pozitif sonuçlar için kanıt bölünmesi veya hata çeşitliliği gereklidir.
Marimba, dondurulmuş Qwen3-ASR 0.6B özellikleri üzerine inşa edilmiş, konuşma uygulamaları için tiplemiş kararlar sunan bir arayüzdür. Sistem, sözlük dışı sorular için soru koşullu bir başlık ve ayrı bir katman-18 tur sonu okuması kullanır. Dil tanımlama ise ASR modelinin kendi dil skorlarına dayanır. Özel konuşma test setlerinde decoder AUROC değeri 0.80-0.92 arasında değişirken, kamuya açık okunmuş konuşmalarda bu değer 0.92-0.97 aralığındadır.
Jacky Kumar, SMEFT operatör uzayını keşfetmek için pekiştirmeli öğrenme yöntemini kullanıyor. 40K parametreli actor-critic mimari, 132 gözlemlenebilir üzerinde çok operatörlü teoriler üretiyor. RL politikası, rastgele aramalara kıyasla daha verimli sonuçlar veriyor ve yeni fizik etkileşimlerini sistematik olarak keşfetmeyi sağlıyor.
arXiv1 dk okuma
49–60 / 150 yayın
Nasıl hazırlıyoruz?
Kaynağı belli. Sınırları açık.
Resmî duyuruları, araştırma makalelerini ve açık kaynak projelerinin sürüm notlarını yapay zekâ ile Türkçe özetliyoruz. Her haberde kaynak bağlantılarına, kullanım alanlarına ve açıklanmayan noktalara yer veriyoruz.
Doğrudan kaynak
Araştırma makalesine, model duyurusuna veya projenin deposuna haberden ulaşabilirsiniz.
Bulgular ve yorumlar
Kaynakta açıklanan sonuçları, olası kullanım alanları ve bilinmeyenlerden ayrı sunuyoruz.
Görsellerin kaynağı
Görsel ve videoların kaynağını belirtiyoruz. Konuyu anlatmak için kullanılan illüstrasyonları da işaretliyoruz.
Araştırma kaynakları
Makaleleri kendiniz keşfedin.
Yeni çalışmalar bulabileceğiniz dizinler ve araştırma laboratuvarları. Bir görsel özet ilginizi çekerse sonuçları özgün makaleden okuyun.