TurnWise, akışkan video anlayışında GRPO'yu turn-level kredi atamasıyla geliştirir. Yöntem, sessizlikle tamamlanan önek puanlamasıyla her kararın kalan getirisinden grup-göreceli avantajlar oluşturur. Turn-ortalama politika optimizasyonu, çıktı uzunluğundan bağımsız olarak yanıt ve bekleme kararlarına eşit ağırlık verir. Bu tasarım, öğrenme sinyalini önceki ödüllerden ayırarak gereksiz tekrarları azaltır ve bilgilendirici yanıtları teşvik eder. Ekstra rollout veya öğrenilmiş kritik gerektir.
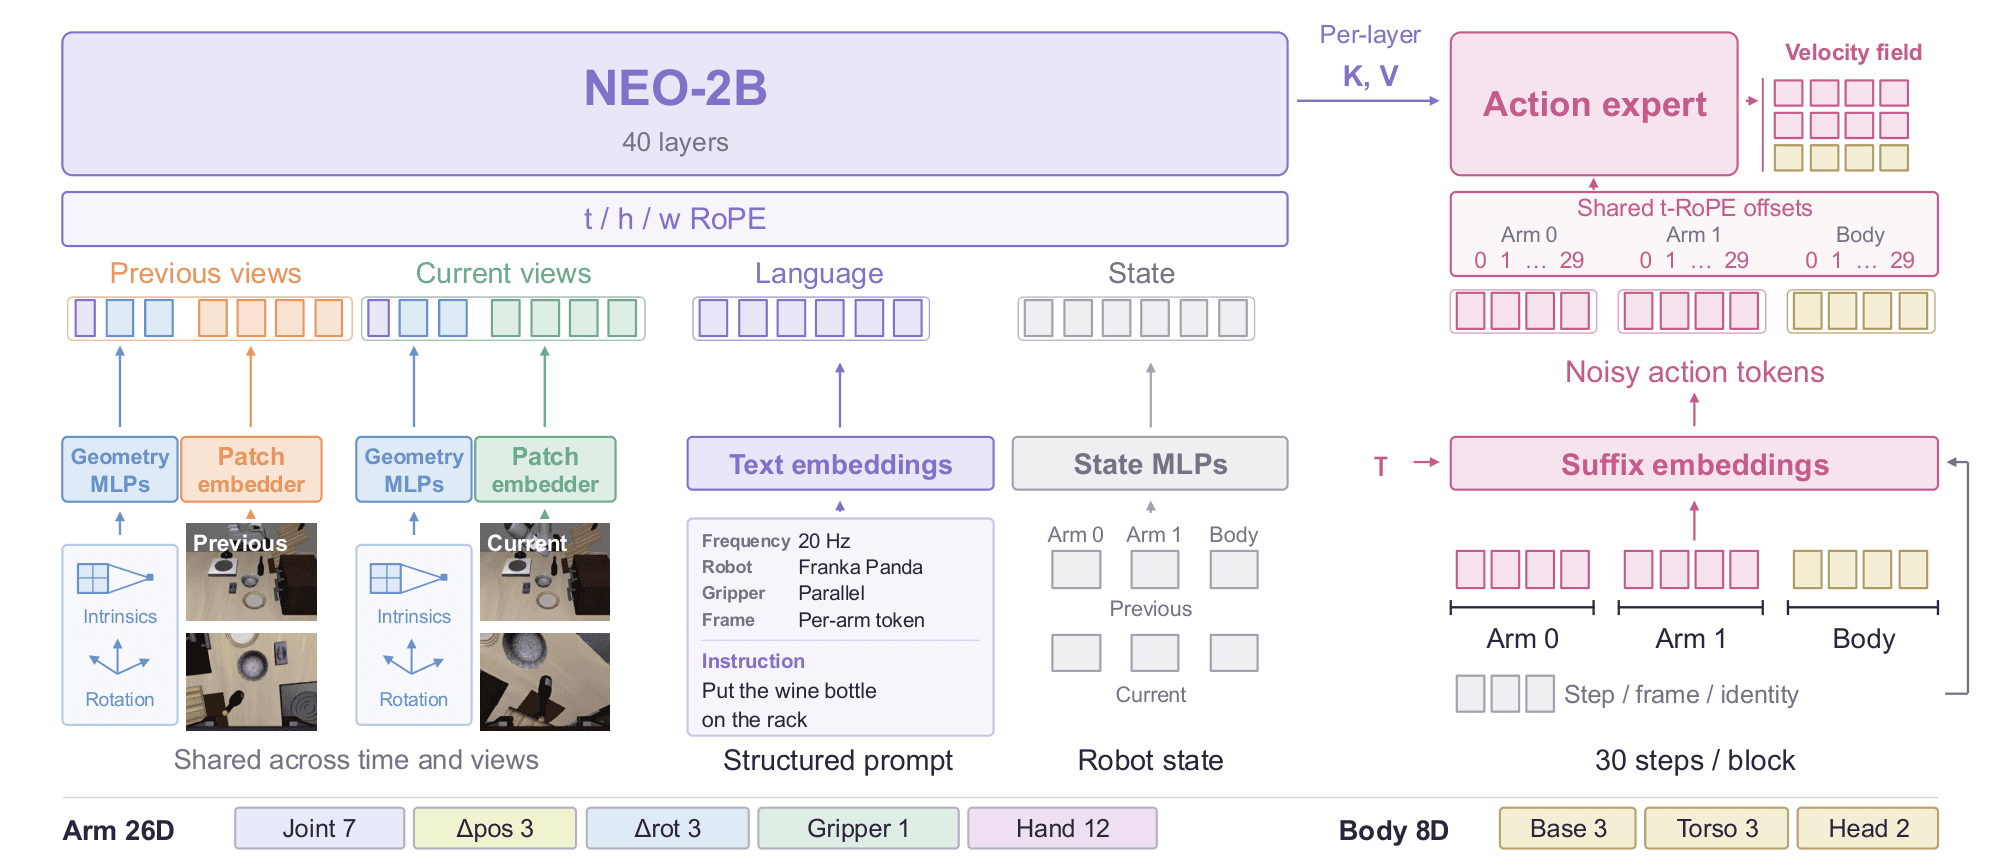
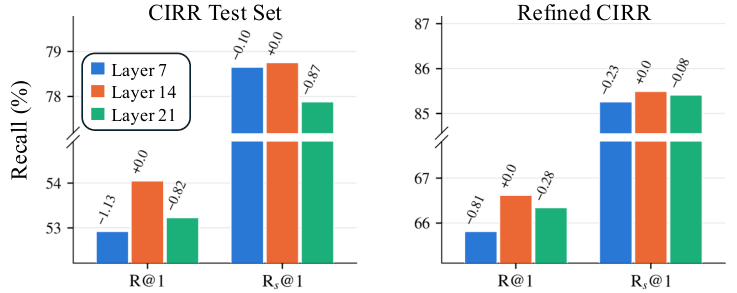
NEO-VLA, görsel kodlayıcıları atlayarak görüntüleri hafif konvolüsyon katmanlarıyla tokenize eder ve bunları dil ile birlikte omurga boyunca evrilmesine izin verir. Bu yapı, eylem uzmanının farklı derinliklerdeki görsel temsillere erişmesini sağlar. Kontrollü testlerde kodlayıcı tabanlı modellerden üstün performans gösterir ve dağıtım kaymalarında daha sağlam kontrol sunar.
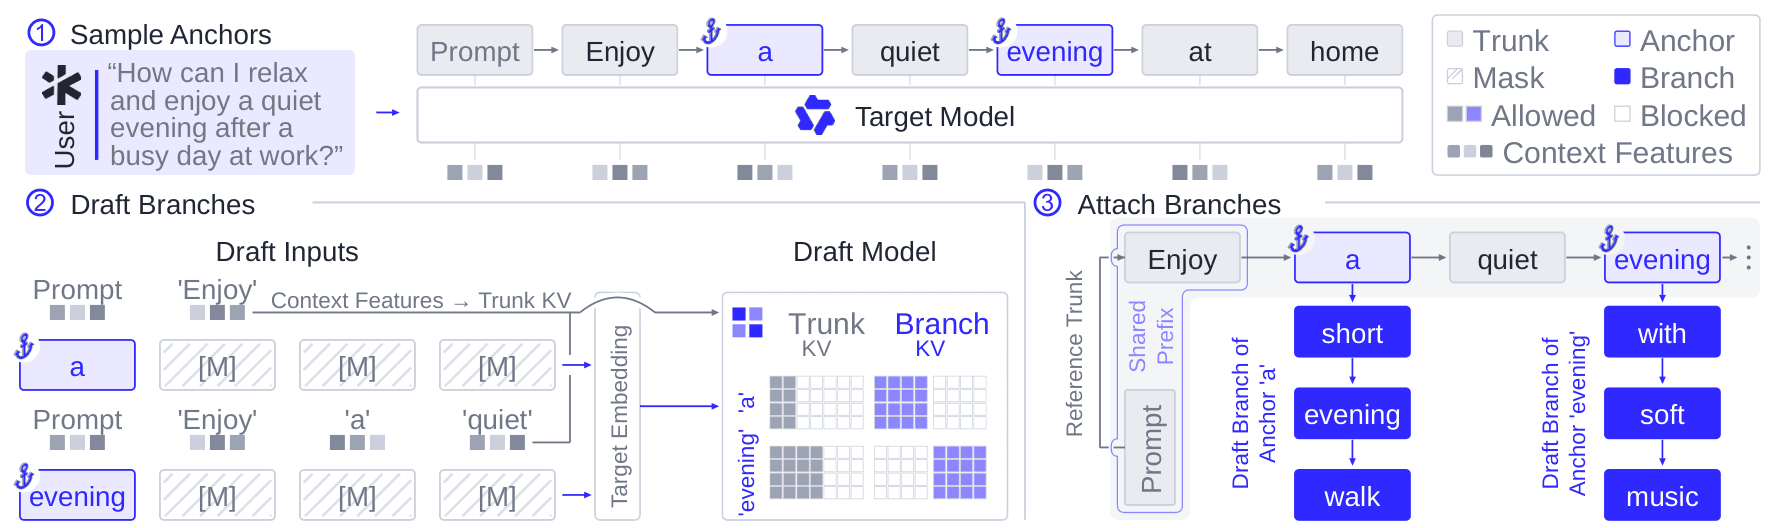
SpecOPD, spekülatif çözümlendirmede taslak model eğitimi için dallar arası paralel on-policy damıtma sunar. Sıralı denetim bağımlılıklarını kırarak eğitim verimliliğini artırır. 8B-125B hedef modellerde test edilmiş, kabul uzunluğunu ve üretim hızını önemli ölçüde iyileştirmiştir.
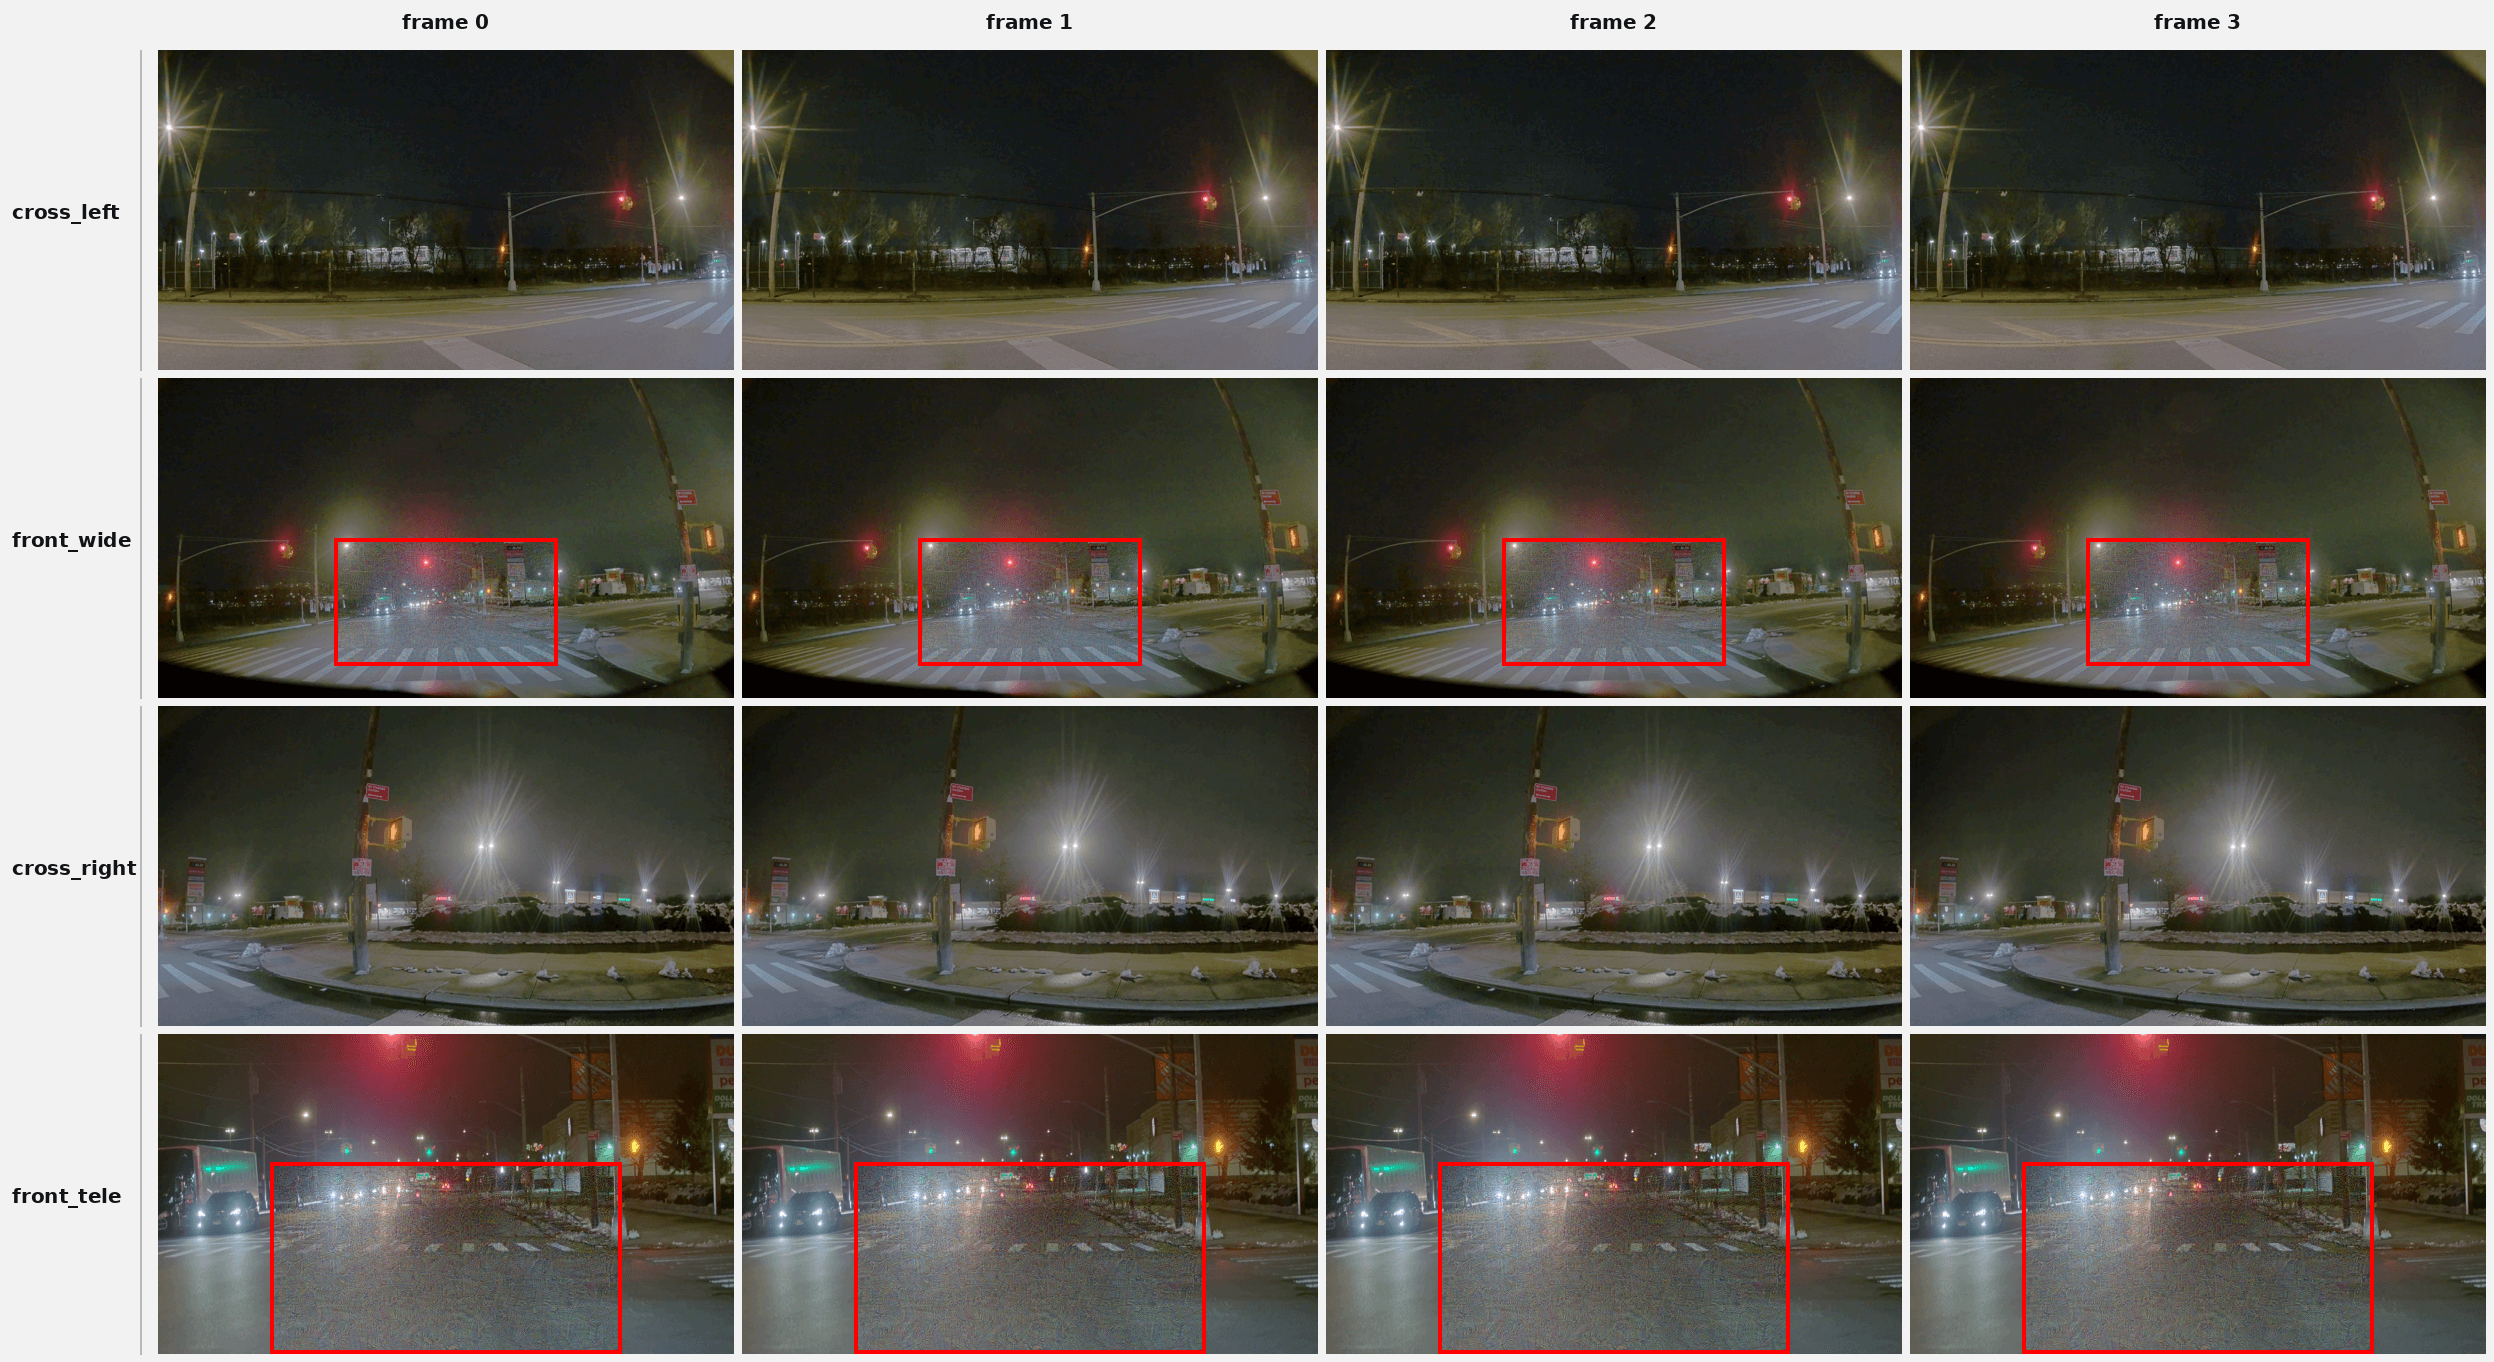
Bu çalışma, akıl yürütme VLA modellerinde görsel perturbasyonların, üretilen metin gerekçesini kelimesi kelimesine aynı tutarken fiziksel eylemi değiştirebildiğini gösterir. TNAS tanısı, eylem duyarlılığının metin gradyanlarından bağımsız olduğunu ortaya koyar. Alpamayo ve InstructVLA üzerinde yapılan testlerde, bu yönde yapılan müdahaleler metin kaymasını azaltırken eylem sapmasını önemli ölçüde artırır.
FinForesight, finansal derin araştırma sistemlerini değerlendirmek için tasarlanmış tanılama amaçlı bir geriye dönük test benchmark'idir. Çin, ABD ve Hong Kong piyasalarını kapsayan bu çalışma, tahmin performansını ve yetkinlikleri ayrı ayrı ölçer. Çalışma, geçmiş verilerden sızan bilgiyi kontrol ederek daha dürüst bir değerlendirme zemini sunar.
Kev-Bio, tıbbi ultrason biyometrisinde manuel kaliper yerleştirme sorununu çözmek için tasarlanmış bir görme-dil modelidir. Sistem Bir karar modellerinden ilham alan model, klinik ölçüm sorularını kullanarak anatomik işaret noktalarını tespit eder. Dokuz görünümlük FU/GU Biometry 2026 veri setinde test edilen model, karşılaştırılan taban çizgilerine göre daha düşük ortalama radyal hata ve klinik ölçüm hatası değerleri elde etti.
Bu çalışma, büyük dil modellerinin eğitiminde öğretmen modelinin sabit kalmasının yetersiz olduğunu savunarak, her token için dinamik olarak en uygun öğretmenin seçilmesini önerir. MTA-OPSD yöntemi, aday öğretmen havuzundan token bazlı seçim yaparak denetim kalitesini artırır. Qwen3 modelleri üzerinde matematiksel akıl yürütme görevlerinde test edilen yöntem, mevcut OPSD yaklaşımlarına göre ortalama +5.9 puanlık bir iyileşme göstermiştir.
FactEmbed, bileşik görsel arama (CIR) görevinde MLLM'lerin kompozisyonel anlayışını etkinleştirmek için faktörize gizli değişkenler kullanır. Model, görsel değişiklikleri ara bir hedef hayal etme hedefiyle çözümler ve bu temsilleri ayırt edici gömme vektörlerine dönüştürür. Bu yaklaşım, doğrudan projeksiyonun sınırlamalarını aşarak arama performansını iyileştirir.
MoviEdit, uzun metrajlı ve çoklu sahneli video düzenleme için uçtan uca bir çerçeve sunar. Otomatik veri üretimi ve kademeli mimari ile sahne geçişlerinde tutarlılığı hedefler. Yeni MoviEdit-Bench ile sistematik değerlendirme imkanı sağlar ve açık kaynak modelleri geride bırakır.
Axion 1.0, karmaşık orta eğitim aşamaları olmadan güçlü ajan yetenekleri sunan açık kaynak bir temel modeldir. Model, iki hafif denetimli ince ayar ve pekiştirmeli öğrenme aşamalarından oluşan sade bir tarifle eğitilmiştir. Ekip, model ağırlıklarının ötesinde veri inşası ve eğitim kodunu da paylaşarak sürecin yeniden üretilebilirliğini sağlamıştır.
SeMo3D, 3D üretimi, düzenleme ve tamamlama görevlerini 'Seçici Modelleme' paradigmasıyla birleştirir. Bu yaklaşım, yalnızca hedef bölgeyi sentezleyerek değişmeyen içeriği korur ve görev bazlı eşleşen veri seti ihtiyacını ortadan kaldırır. Omni3DiT mimarisi, çoklu modal rehberlik ile ince ayarlı kontrol sağlar.
Kling ekibi, video üretiminde darboğazın renderdan semantik kontrole kaydığını savunuyor. Rapor, veri, koşullandırma, hizalama ve değerlendirme zincirini modül bazında inceli. Kling-MLLM gibi ortak çok modlu modellerin, üretim kalitesinin çok modlu anlama projeksiyonu olduğunu gösteren içgörüler sunar.
arXiv1 dk okuma
49–60 / 101 yayın
Nasıl hazırlıyoruz?
Kaynağı belli. Sınırları açık.
Resmî duyuruları, araştırma makalelerini ve açık kaynak projelerinin sürüm notlarını yapay zekâ ile Türkçe özetliyoruz. Her haberde kaynak bağlantılarına, kullanım alanlarına ve açıklanmayan noktalara yer veriyoruz.
Doğrudan kaynak
Araştırma makalesine, model duyurusuna veya projenin deposuna haberden ulaşabilirsiniz.
Bulgular ve yorumlar
Kaynakta açıklanan sonuçları, olası kullanım alanları ve bilinmeyenlerden ayrı sunuyoruz.
Görsellerin kaynağı
Görsel ve videoların kaynağını belirtiyoruz. Konuyu anlatmak için kullanılan illüstrasyonları da işaretliyoruz.
Araştırma kaynakları
Makaleleri kendiniz keşfedin.
Yeni çalışmalar bulabileceğiniz dizinler ve araştırma laboratuvarları. Bir görsel özet ilginizi çekerse sonuçları özgün makaleden okuyun.