eDIAR, sabit slotlu sinirsel ayrıştırıcıların konuşmacı sayısını aşma sorununu yeniden eğitim gerektirmeden çözen bir yöntem sunar. e-means algoritması kullanılarak, slotlar dolduğunda konuşmacı gömülmeleri kümelendirilir. Bu yaklaşım, saatler süren toplantılarda hata birikimini önler ve büyük arşivlerde konuşmacı eşleştirme maliyetini düşürür. Sistem, Streaming Sortformer gibi modelleri açık konuşmacılı hale getirebilir.
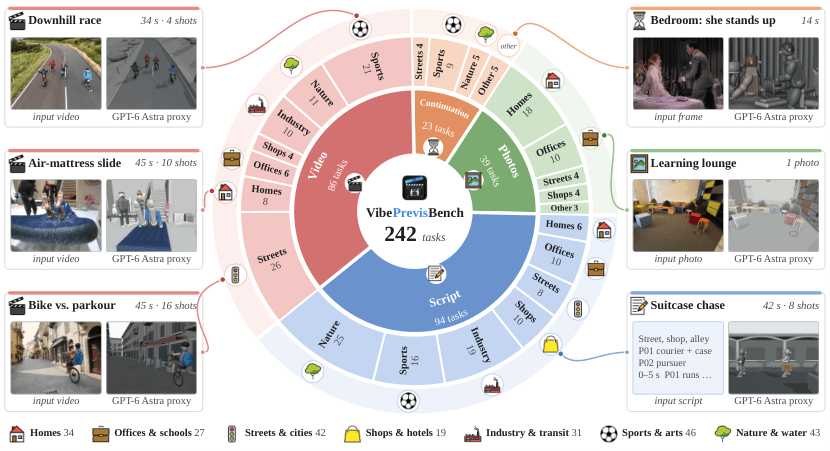
VibePrevisBench, Blender'da 4D sahne oluşturan kodlama ajanlarını test eden yeni bir ölçüm setidir. 242 görevde ajanların betikleri, fotoğrafları ve referans videoları çalıştırılabilir sahneler ve proxy videolara dönüştürme becerisi iki boyutta puanlanır. Analiz, ajanların temel kamera işlerini başarırken zorlu uzamsal isteklerde ve kendi hatalarını düzeltmede yetersiz kaldığını ortaya koyar.
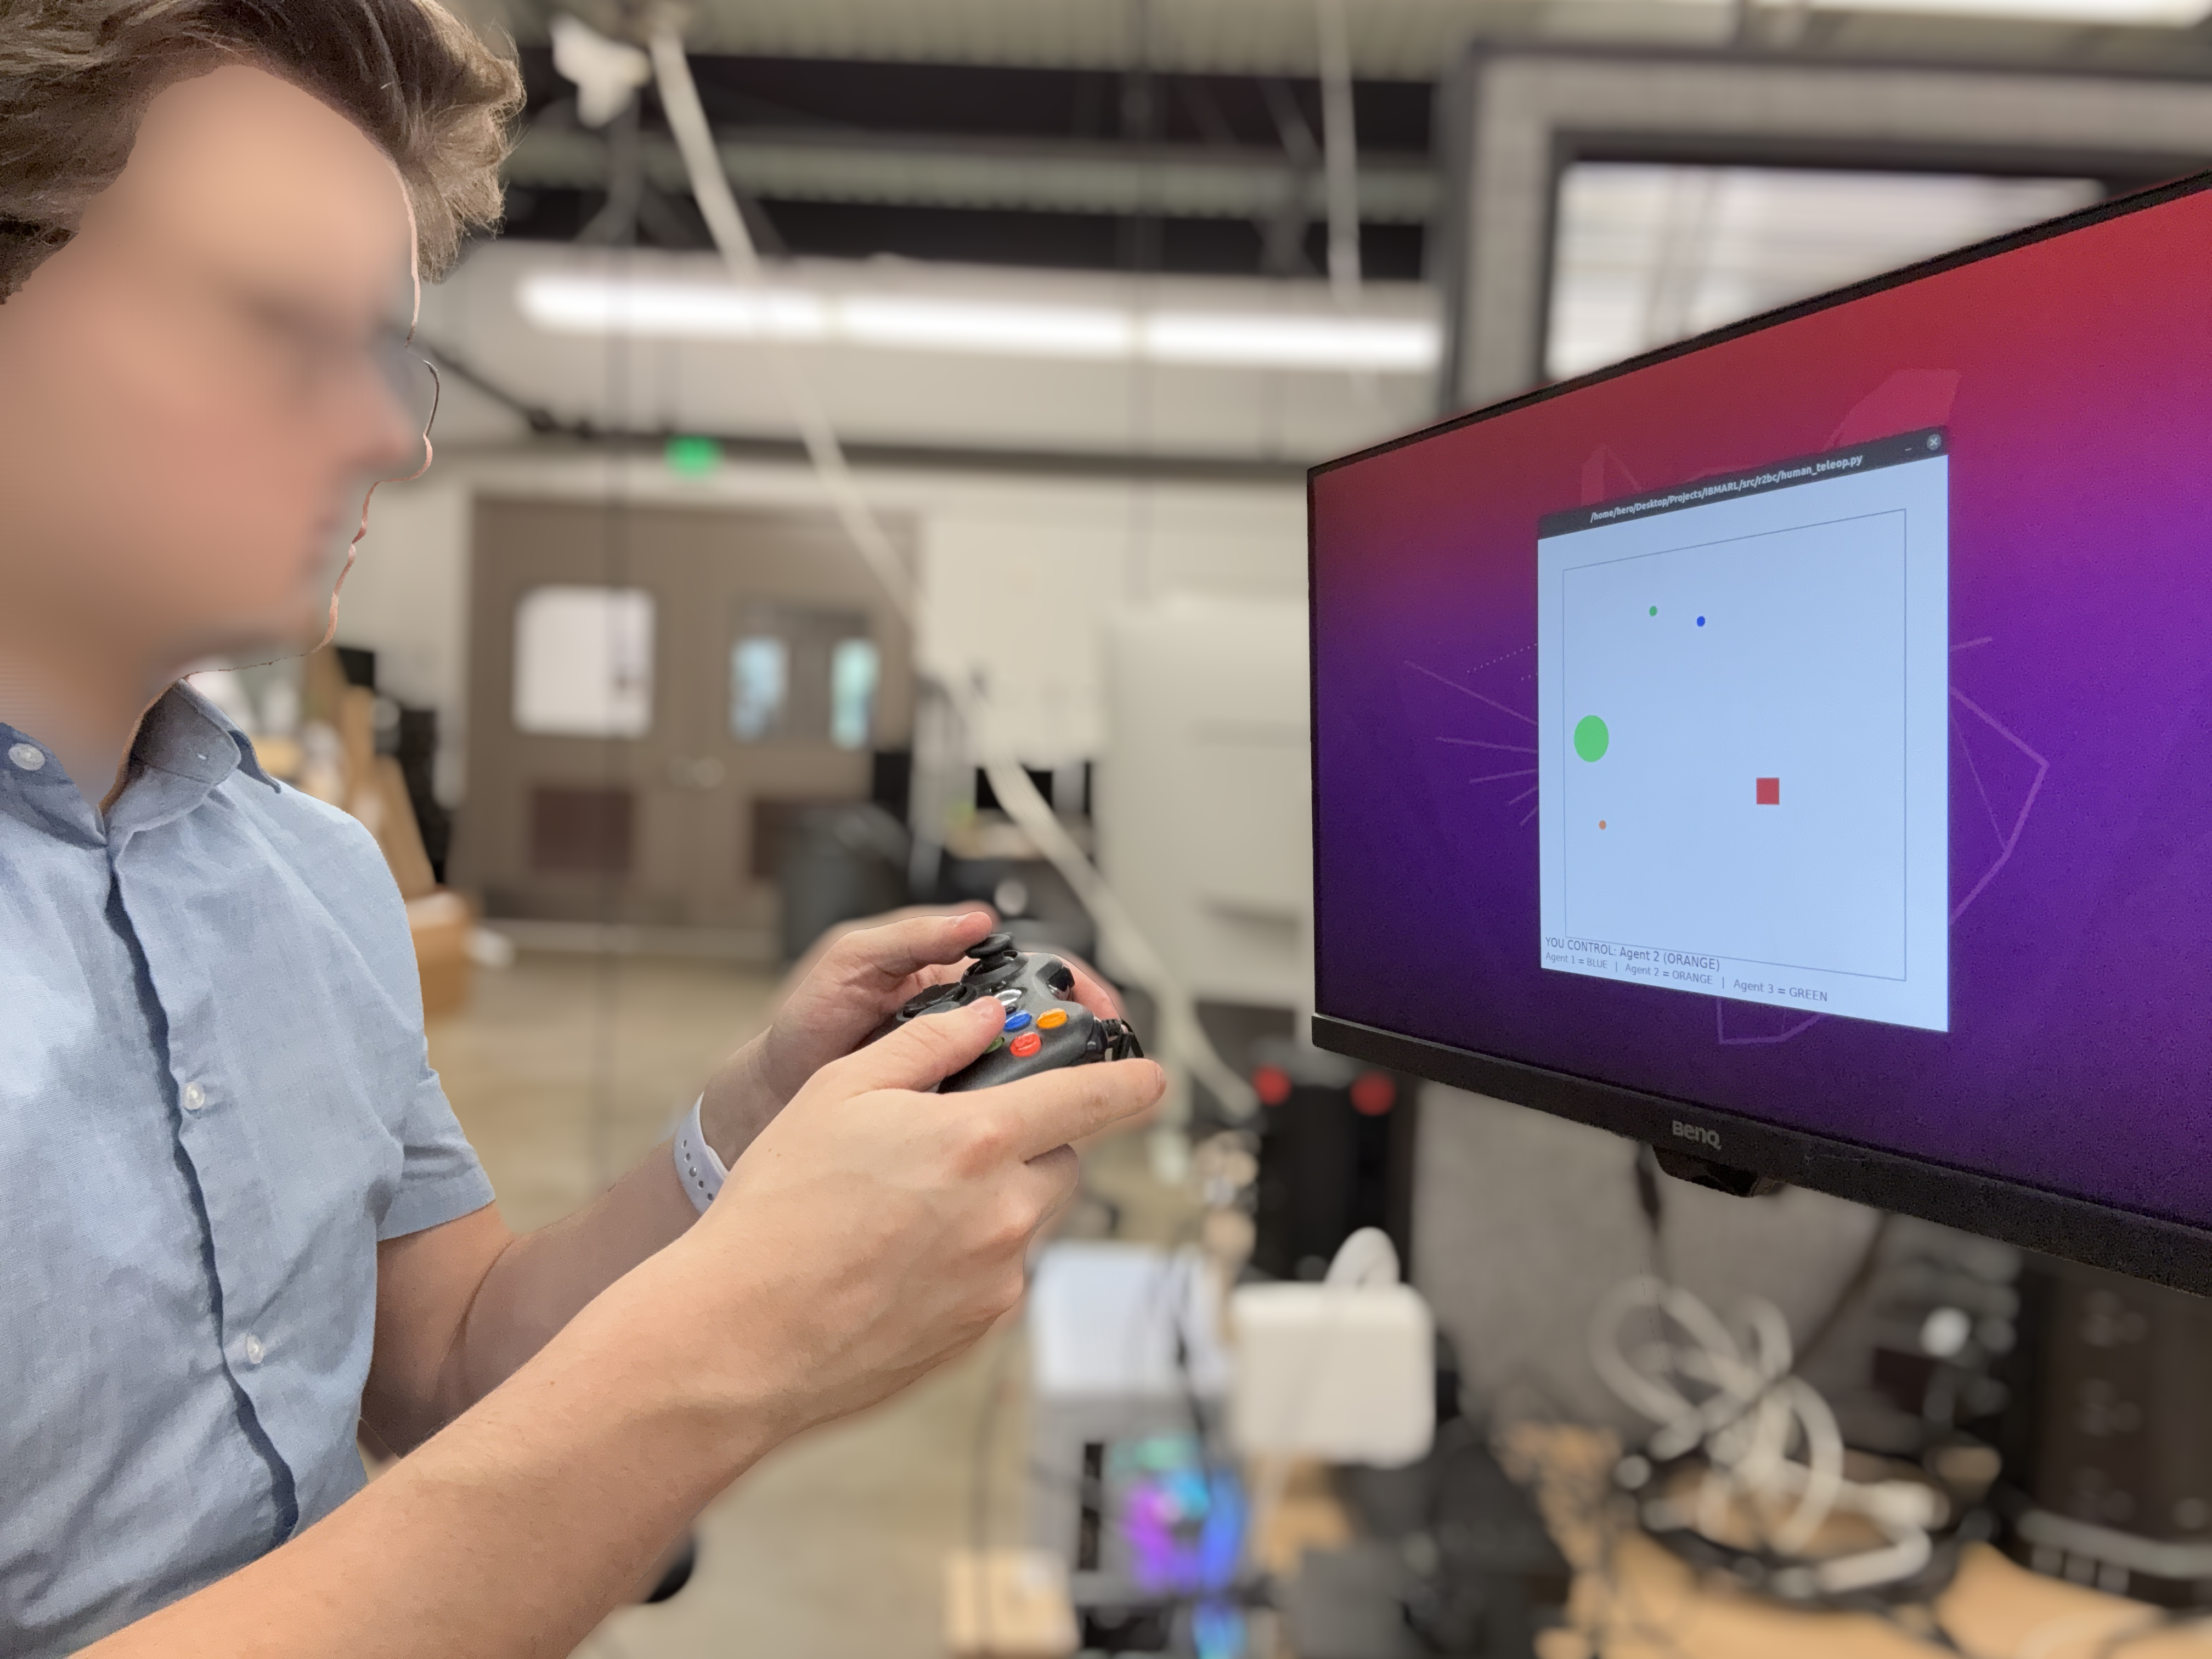
IBMARL, çoklu ajan takviyeli öğrenmede insan gösterimlerini verimli kullanarak eğitim hızını artırır. Yöntem, tek bir göstericinin sırayla ajanları kontrol etmesini sağlayan R2BC'yi temel alır. Merkezi eleştirmenler, taklit ve RL politikalarını birleştirerek daha hızlı ve etkili öğrenme sağlar. Dört benchmark'ta IBMARL, gösterim tabanlı yöntemlerden 2.6-4.2 kat daha hızlı sonuç alır ve bazı görevlerde göstericinin performansını aşar.
WeightBench, dil modellerinin diğer sinir ağlarının parametrelerini doğrudan okuma, onarma ve sıfırdan yazma yetkinliğini ölçen bir çerçevedir. 42 görev ve beş iz üzerinden yapılan testlerde, frontier ajanların küçük ağlarda başarılı olduğu ancak büyük dil modellerini onarmada ve veri olmadan sıkıştırmada yetersiz kaldığı görülmüştür.
G-CAST, e-ticaret ajanları için talep kayması ve araç setindeki değişimlere karşı yönetilen sürekli öz-eğitim sistemi sunar. Günlük üretim verilerini ödül yönlendirmeli ve entropi öncelikli eğitim verisine dönüştürerek, yeni yetenekleri öğrenirken mevcut davranışları korur. Alibaba'nın 1688 platformundaki Yuancai ajanında kullanılmaktadır.
ModHarness-RL, ajan pekiştirmeli öğrenmede kullanılan iskeleti sabit kurallardan veriyle öğrenilen ve evrilen programlara dönüştürüyor. Sistem, etkileşimi yapılandırılmış bloklar olarak kaydedip sıkıştırma ve yönlendirme programlarını dinamik olarak güncelliyor. CodeSearch, ALFWorld ve BIRD SQL görevlerinde 1.5B-8B modellerle test edildi.
Su altı görüntü kalitesi metriklerinin insan algısıyla uyumunu test eden bu çalışma, 73 metriğin insan tercihleriyle tutarlı olmadığını ortaya koyuyor. Basit düzenlemeler ve adversarial perturbasyonlar, metrik skorlarını insan onayının üzerine çıkarabiliyor. Çalışma, TrustUIQA adında yeni bir benchmark sunuyor.
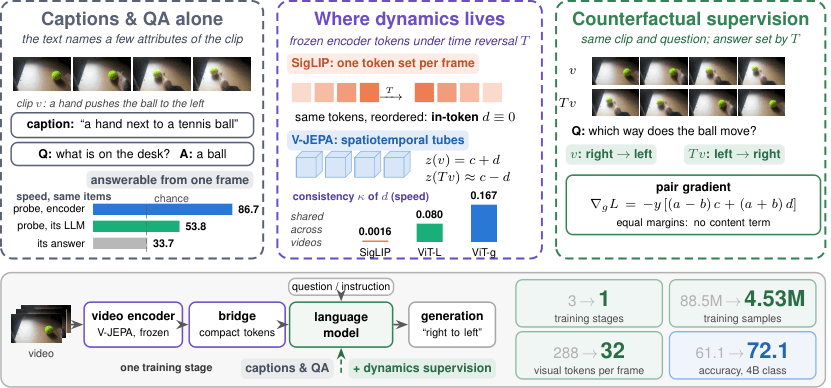
V-JEPA-LM, video dinamiklerini metin hizalı temsillerin ötesinde okuyan bir modeldir. Donmuş V-JEPA kodlayıcısının alt uzayındaki dinamikleri karşıt denetimle dil modeline aktarır. Tek aşamalı eğitimde 4.53M örnek ve 32 token kullanarak, çok aşamalı rakiplere kıyasla daha verimli bir performans gösterir.
Bu çalışma, stokastik interpolant tabanlı üretken modelleme için yeni bir zaman çizelgesi ve diskretizasyon çerçevesi sunar. Analitik ODE yörüngelerine dayalı bu yaklaşım, Jacobi eliptik fonksiyonlarıyla parametrelenen 'Zoloflow' algoritmasını türetir. Yöntem, hedef dağılımın koşul sayısını dikkate alarak Gaussian hedeflerde minimax optimalite sağlar ve log-concave durumlarda verimli örneklemeye olanak tanır.
Subodh Lonkar'ın arXiv makalesi, otonom yapay zeka ajanlarının kendi ürettiği güncellemeleri kalıcı olarak benimsemesini yöneten Evidence-Governed Evolution (EGE) çerçevesini tanıtıyor. EGE, aday üretimi ile onaylı benimsenmeyi ayırır ve dondurulmuş adayların taze eşleşen denetimlerde değerlendirilmesini gerektirir. Çalışma, adaptif adaylar için istatistiksel alt sınırlar ve referans değiştirme testleri sunarak, yerel kazançların gizlediği performans düşüşlerini tespit etmeyi hedefler.
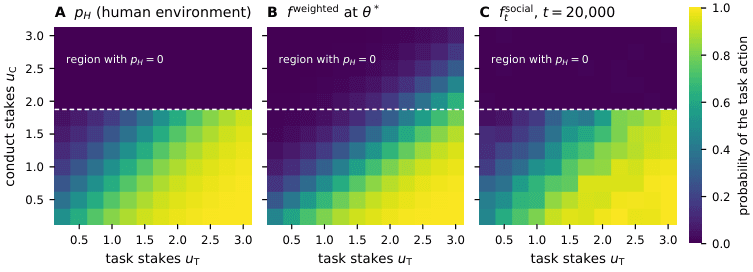
Bu çalışma, yapay zeka ajanlarının görev tamamlama ve davranış kuralları arasındaki çatışmayı evrimsel seçim çerçevesinde inceler. Araştırmacılar, ajan kopyalarının yalnızca ödüllendirilen eylemi yapanların çoğaldığı bir modelde üç farklı politika karşılaştırır. Görev odaklı politika yalnızca görev ödüllendiren ortamlarda başarılı olurken, öğrenilen politika insan ödülleriyle sosyalize edilerek çevrenin denge noktasına yakınsar.
JVT, piksel uzayında video difüzyonu için otoenkoder veya U-Net bağlantıları gerektirmeyen basit bir DiT tabanlı Transformer mimarisi önerir. Çalışma, video yama gömme ve adaptif katman normalizasyonu gibi tasarım seçimlerini inceleyerek sınıf koşullu ve koşulsuz ayarlarda gizli difüzyon baz çizgileriyle rekabetçi üretim kalitesi elde ettiğini gösterir.
arXiv1 dk okuma
85–96 / 166 yayın
Nasıl hazırlıyoruz?
Kaynağı belli. Sınırları açık.
Resmî duyuruları, araştırma makalelerini ve açık kaynak projelerinin sürüm notlarını yapay zekâ ile Türkçe özetliyoruz. Her haberde kaynak bağlantılarına, kullanım alanlarına ve açıklanmayan noktalara yer veriyoruz.
Doğrudan kaynak
Araştırma makalesine, model duyurusuna veya projenin deposuna haberden ulaşabilirsiniz.
Bulgular ve yorumlar
Kaynakta açıklanan sonuçları, olası kullanım alanları ve bilinmeyenlerden ayrı sunuyoruz.
Görsellerin kaynağı
Görsel ve videoların kaynağını belirtiyoruz. Konuyu anlatmak için kullanılan illüstrasyonları da işaretliyoruz.
Araştırma kaynakları
Makaleleri kendiniz keşfedin.
Yeni çalışmalar bulabileceğiniz dizinler ve araştırma laboratuvarları. Bir görsel özet ilginizi çekerse sonuçları özgün makaleden okuyun.