Tao Ren ve ekibi, uzun süreli LLM ajanları için Multiscale Policy Optimization (MPO) yöntemini tanıttı. MPO, turn ölçeğinde avantaj tahmini ve önem örneklemesi kullanarak kredi dağıtımını hizalar. 4B ve 30B-A3B modellerinde arama, araç kullanımı ve otomasyon görevlerinde güçlü RL baz çizgilerine karşı tutarlı kazanımlar gösterildi.
CodeRabbit, GPT‑6.1 Sol modelini güvenlik ajanının ana modeli olarak kullanarak karmaşık kod tabanlarındaki riskleri derinlemesine analiz ediyor. Sistem, pull request incelemesini tekil değişikliklerin ötesine taşıyarak bağımlılıklar ve bileşen etkileşimleri üzerinden güvenlik açıklarını tespit ediyor. Bulgular, mevcut geliştirici iş akışlarına entegre edilerek düzeltme önerileriyle destekleniyor.
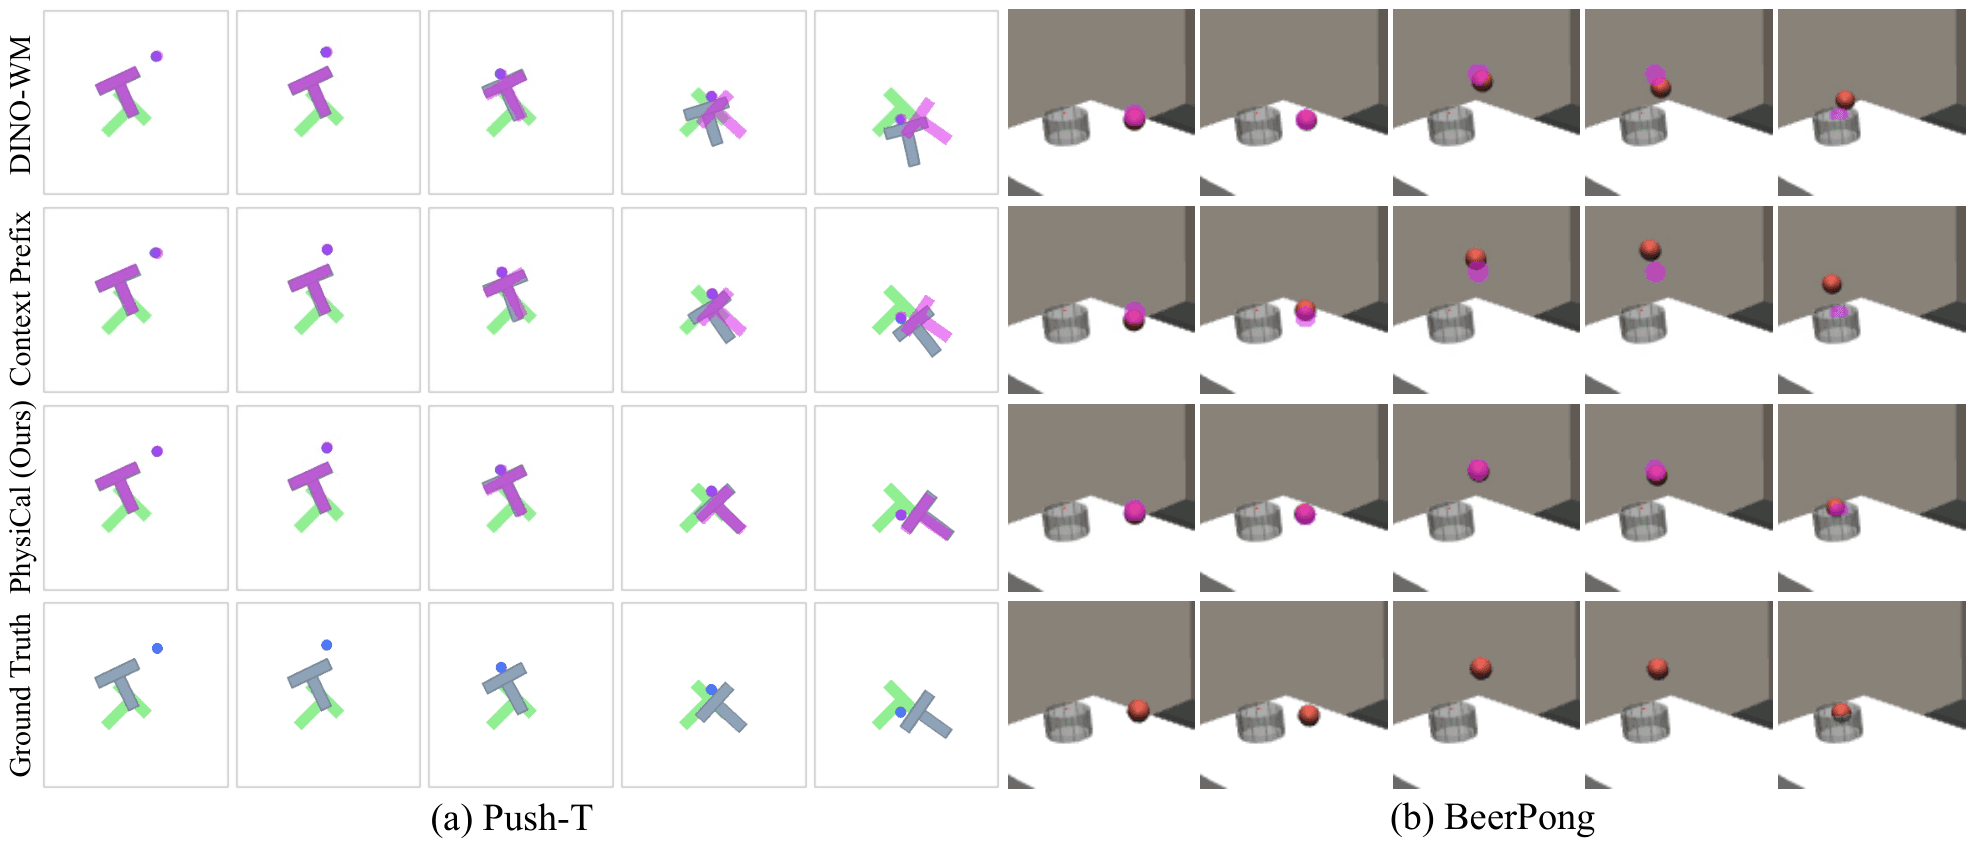
PhysiCalWorld, dünya modellerinin fiziksel dinamikleri kalibre etmesi için bağlam içi istemleme kullanır. Yöntem, ince ayar veya analitik fizik modelleme gerektirmeden, sahnede toplanan etkileşim kliplerini kompakt bir fizik tanımlayıcı belirteceye dönüştürür. Bu yaklaşım, yeni test sahnelerindeki tahmin sapmasını azaltarak görsel planlama başarı oranını artırır ve fizik etiketi olmadan uçtan uca eğitim yapılmasını sağlar.
LongZero, büyük dil modellerinin uzun bağlam akıl yürütme yeteneğini harici veri kullanmadan geliştirmek için bir pekiştirmeli öğrenme yöntemi sunar. Model, kendi ürettiği çok adımlı akıl yürütme ve çok turlu arama görevleriyle eğitim görür. Bu yaklaşım, uzun ve doğrulanabilir veri setlerinin pahalılığına alternatif oluşturur.
KronLSTM, Kronecker Delta Rule tabanlı yeni bir lineer dikkat mimarisidir. Bellek matrisini tek yönde düzelterek uzun bağlamda kararlılık sağlar. Ek normalizasyon gerektirmeden (Gated) DeltaNet ailesiyle rekabet eder ve açık kaynak olarak sunulmuştur.
SERO, uzun süreli ajan pekiştirmeli öğrenmede mevcut politikanın ulaşamadığı durumlar için orak kontrollü devamlar kullanır. Gerçek ortamda etkileşim kuran orak, eğitim için gözlem ve eylem üretir. Politika erişilebilirlik ağırlıklandırması, orak adımlarının denetim etkisini politika uyumuna göre ayarlar. ALFWorld ve WebShop'ta Qwen2.5 modelleriyle test edilen yöntem, çıkarım sırasında orak gerektirmez.
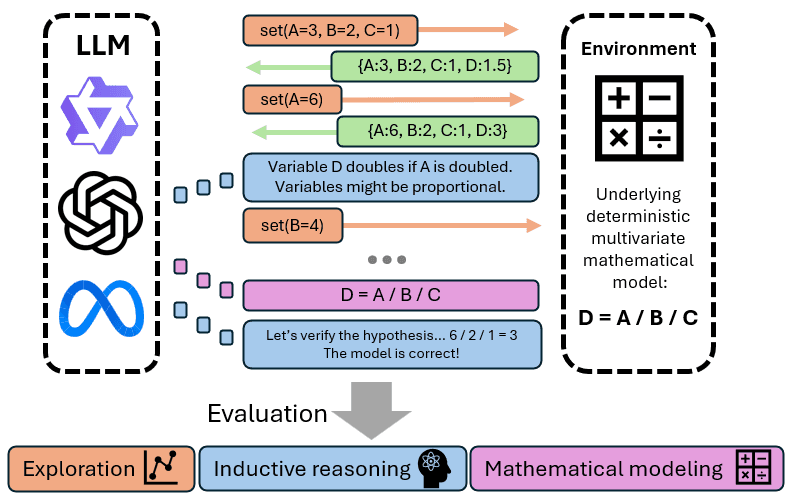
Bu çalışma, LLM tabanlı ajanların hipotez oluşturma, çıkarım ve keşif yeteneklerini birleştiren bir sorgulama çerçevesi sunar. Countdown görevinin matematiksel bir ortamda genişletilmesiyle, ajanların değişkenleri manipüle ederek ilişkileri keşfetme süreçleri analiz edilir. Yedi LLM üzerinde yapılan deneyler, modellerin stratejik keşif ve iteratif hipotez güncellemede sınırlı kaldığını, ancak eğitim iskelelerinden ilham alan yönlendirmenin performansı artırdığını ortaya koyar.
arXiv / cs.AI + cs.CL1 dk okuma
1–7 / 7 yayın
Nasıl hazırlıyoruz?
Kaynağı belli. Sınırları açık.
Resmî duyuruları, araştırma makalelerini ve açık kaynak projelerinin sürüm notlarını yapay zekâ ile Türkçe özetliyoruz. Her haberde kaynak bağlantılarına, kullanım alanlarına ve açıklanmayan noktalara yer veriyoruz.
Doğrudan kaynak
Araştırma makalesine, model duyurusuna veya projenin deposuna haberden ulaşabilirsiniz.
Bulgular ve yorumlar
Kaynakta açıklanan sonuçları, olası kullanım alanları ve bilinmeyenlerden ayrı sunuyoruz.
Görsellerin kaynağı
Görsel ve videoların kaynağını belirtiyoruz. Konuyu anlatmak için kullanılan illüstrasyonları da işaretliyoruz.
Araştırma kaynakları
Makaleleri kendiniz keşfedin.
Yeni çalışmalar bulabileceğiniz dizinler ve araştırma laboratuvarları. Bir görsel özet ilginizi çekerse sonuçları özgün makaleden okuyun.