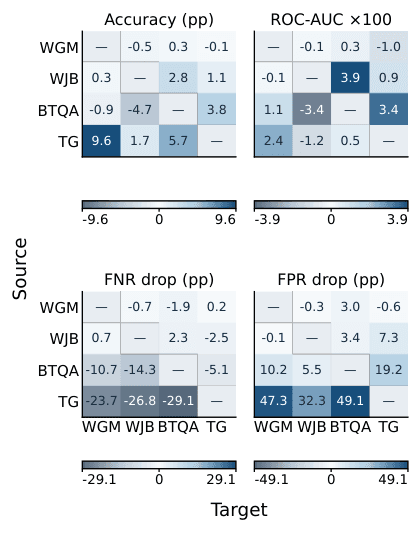
Yan Qiu ve Yuanyuan Li, büyük dil modellerinde jailbreak tespitini ek sınıflandırıcı eğitmeden gerçekleştiren JDPI yöntemini sunuyor. Yöntem, zararlı ve zararsız prototipler arasındaki mesafeye dayalı kararlar veriyor. Dört veri setinde test edilen model, karşıtlı ince ayarla doğruluğu artırıyor ve Llama Guard 3-8B'yi ROC-AUC metriklerinde geride bırakıyor.
arXiv / cs.AI + cs.CL1 dk okuma
1–1 / 1 yayın
Nasıl hazırlıyoruz?
Kaynağı belli. Sınırları açık.
Resmî duyuruları, araştırma makalelerini ve açık kaynak projelerinin sürüm notlarını yapay zekâ ile Türkçe özetliyoruz. Her haberde kaynak bağlantılarına, kullanım alanlarına ve açıklanmayan noktalara yer veriyoruz.
Doğrudan kaynak
Araştırma makalesine, model duyurusuna veya projenin deposuna haberden ulaşabilirsiniz.
Bulgular ve yorumlar
Kaynakta açıklanan sonuçları, olası kullanım alanları ve bilinmeyenlerden ayrı sunuyoruz.
Görsellerin kaynağı
Görsel ve videoların kaynağını belirtiyoruz. Konuyu anlatmak için kullanılan illüstrasyonları da işaretliyoruz.
Araştırma kaynakları
Makaleleri kendiniz keşfedin.
Yeni çalışmalar bulabileceğiniz dizinler ve araştırma laboratuvarları. Bir görsel özet ilginizi çekerse sonuçları özgün makaleden okuyun.