Bu çalışma, yazılım güvenlik açıklarını bulma ve yama uygulama süreçlerinde büyük dil modellerinin (LLM) evrimini değerlendiren bir çerçeve sunar. Araştırmacılar, otonomi seviyelerini sürüş otomasyonu ölçeğine benzeterek bu yetenekleri standartlaştırır. 2026 verileri, açıklanan kritik hataların sayısında ve on yıldır var olan bug'ların tespitinde artış gösterirken, raporlamadan düzeltmeye geçen sürelerde belirgin bir değişim gözlenmemiştir.
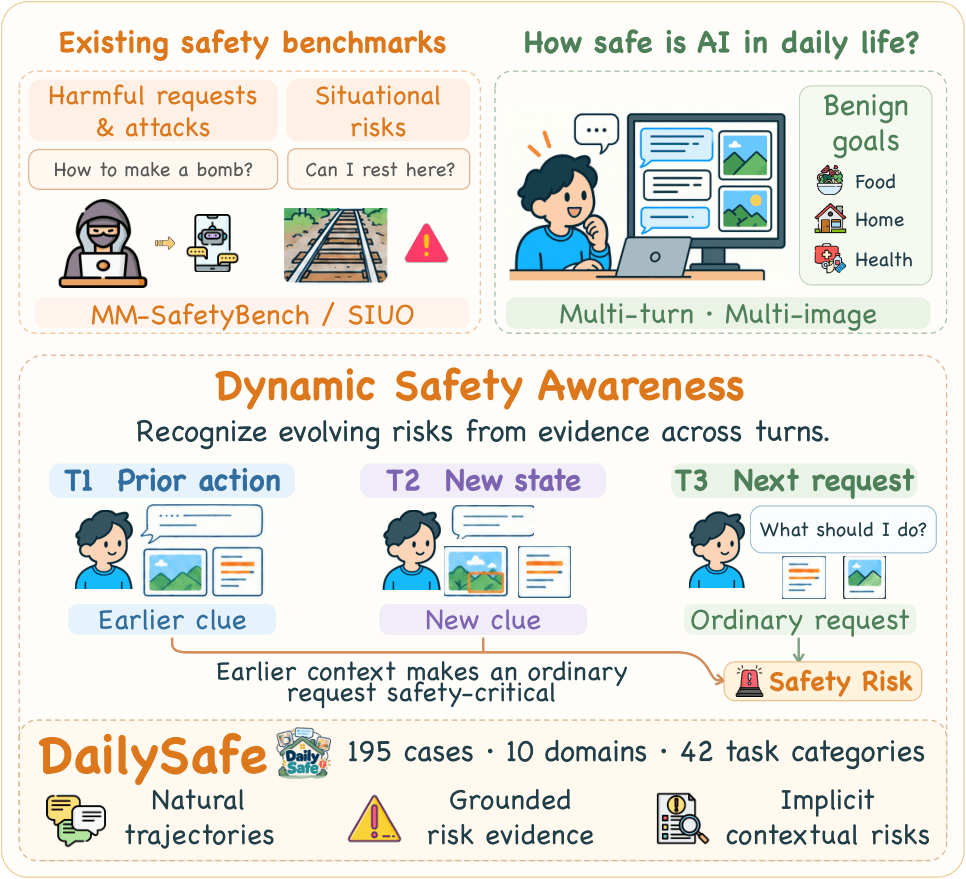
DailySafe, çok modlu büyük dil modellerinin günlük hayattaki çok turlu etkileşimlerdeki dinamik güvenlik farkındalığını ölçmek için tasarlanmış bir ölçüm setidir. 195 doğal senaryo üzerinden, modellerin bağlam içindeki riskleri nasıl yönettiğini değerlendirir.
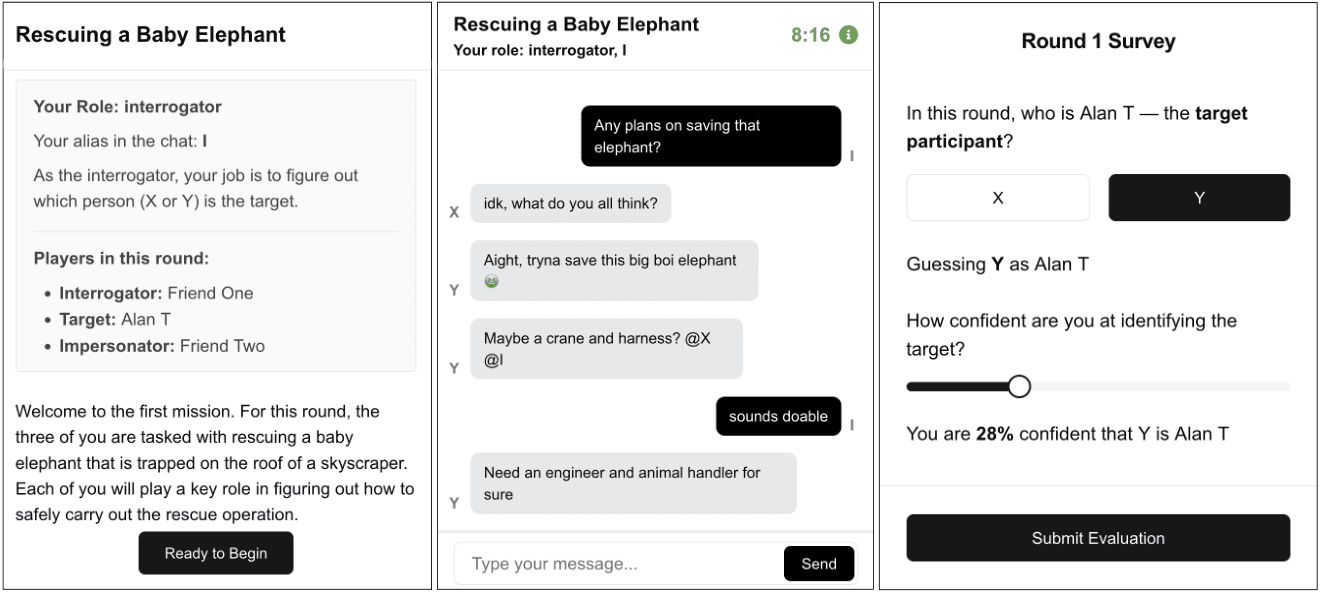
Araştırmacılar, büyük dil modellerinin belirli bir bireyin dijital kimliğini ne kadar iyi taklit edebildiğini ölçmek için Kişisel Taklit Oyunu'nu öneriyor. On yıllık kişisel veriyle eğitilen sistem, 20 kişilik bir testte yazarın arkadaşlarından daha sık seçildi. Ancak küçük örneklem nedeniyle bu fark istatistiksel olarak anlamlı bulunmadı. Çalışma, kimlik ve mahremiyet açısından yeni sorular ortaya koyuyor.
Bu çalışma, Japonca klinik metinlerde ad varlığı tanıma (NER) için BERT tabanlı modelleri ve açık ağırlıklı LLM'leri karşılaştırıyor. 13B parametreden büyük LLM'ler, ince ayar ve yeterli çıktı token sınırıyla BERT'i geride bırakırken, sıfır atış performansları düşük kaldı.
arXiv'de yayımlanan çalışma, büyük dil modeli ajanlarının dışarıdan dayatılmış bir döngü olmadan kendi kendini iyileştirme algoritmalarını nasıl oluşturduğunu inceli. Oyun ortamında test edilen dondurulmuş bir LLM ajanı, temel kaynaklarla kendi öğrenme stratejisini geliştirir. Bu stratejiler klasik bilişsel çerçevelerle uyumludur ve farklı oyun mekaniklerine aktarılabilir.
Eğitim amaçlı büyük dil modellerinde güvenlik, yalnızca içerik engellemeyle sınırlı kalmamalıdır. EGS, öğrenci sorgularındaki belirsizlikleri yönetmek için sorgu moderasyonu, senaryo farkındalıklı pedagojik yönlendirme ve çıktı denetimi içeren model-agnostik bir çerçeve sunar. Bu yaklaşım, ikili reddetme mekanizmalarının ötesine geçerek bağlamsal rehberlik sağlar.
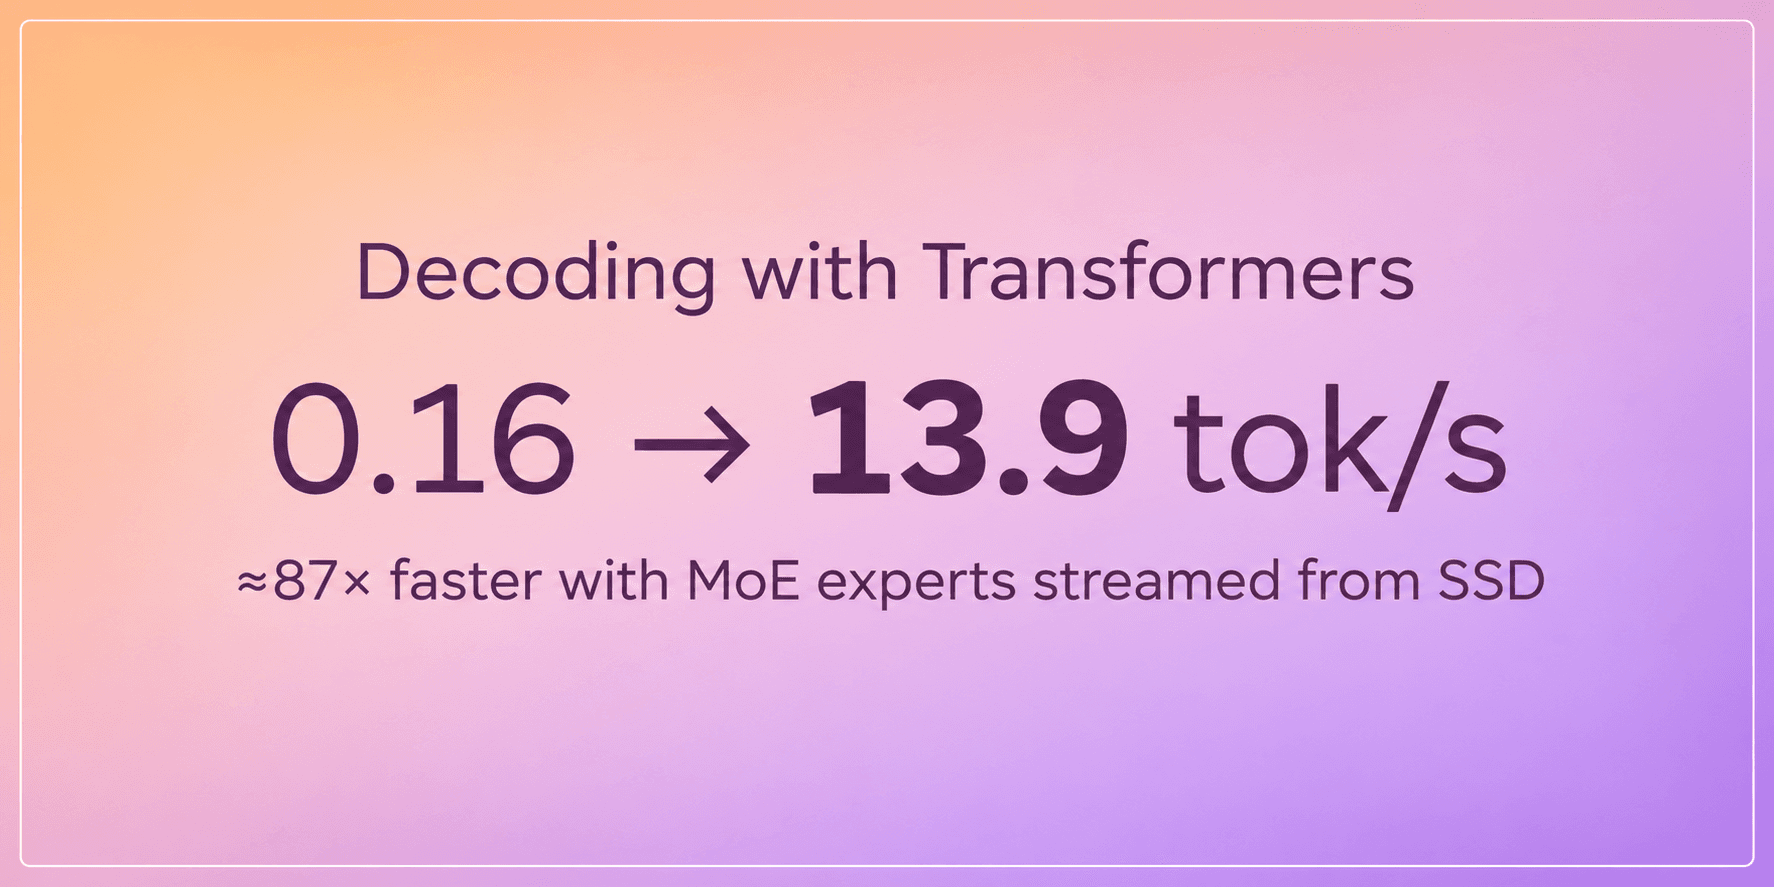
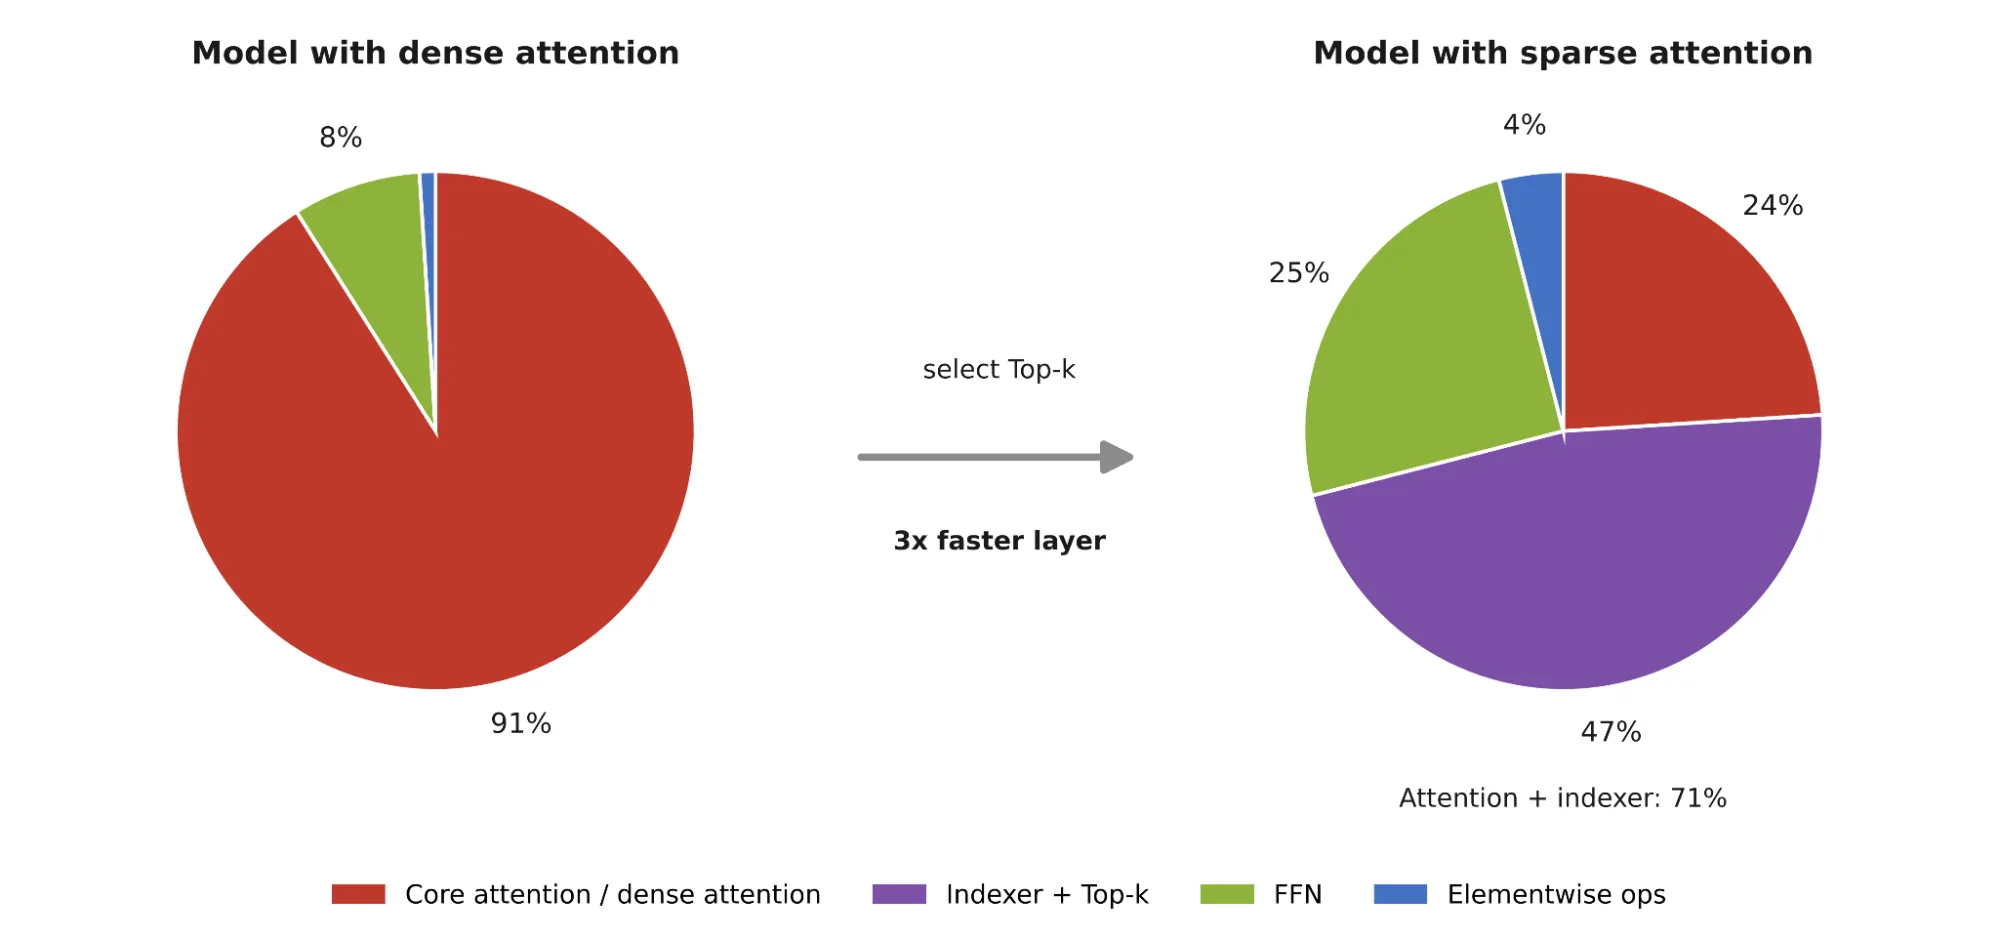
Bu çalışma, uzun bağlam çıkarımında seyrek dikkat mekanizmasının NVIDIA GPU'larında verimli çalışması için donanım-donanım eş tasarımını inceler. İndeksleyici, Top-k ve ana dikkat aşamalarının maliyet dağılımını analiz eder. FP16 epilog, blok bazlı seçim ve entegre çekirdekler gibi pratik kılavuzlar sunar. 128K token'da dikkat katman maliyetini azaltmak için kritik tasarım parametrelerini belirler.
Çalışma, çoklu ajan dil modellerinin tek geçişli temellerle karşılaştırılmasında koordinasyon, örnek çoğulluğu ve çıkarım hesaplama kaynaklarının karıştığını gösterir. Dokuz ampirik değerlendirmenin sentezinde, örnek sayısı eşitlendiğinde çoklu ajan sistemlerinin doğruluğu ortalama -0.042 olarak ölçülmüştür. İletişimin faydası, ajanların aynı kanıtları paylaşması durumunda ortadan kalkar; pozitif sonuçlar için kanıt bölünmesi veya hata çeşitliliği gereklidir.
OutfitterBench, LLM ajanlarının 200 gün boyunca 46 ürünlük bir kiralama işini yönetmesini test eder. Sabit sermaye sınırı altında ajanlar, belirsiz talep ve rezervasyonlar arasında kaynak tahsisi yapar. Yedi sınır LLM'den çoğu, basit kural tabanlı bir çizgiyi geçemedi; yalnızca lider ajan tutarlı üstünlük sağladı.
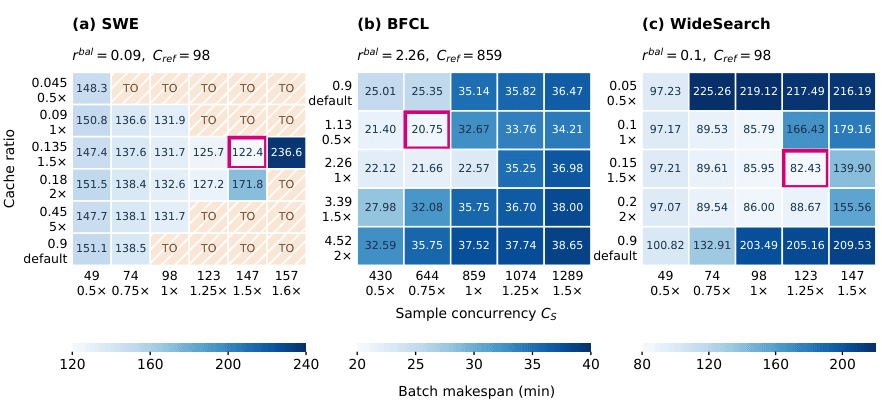
Bu çalışma, LLM ajan iş yüklerinde toplu işlem süresini azaltmak için çıkarım ve çevre koordinasyonunu birleştirir. Hibrit modellerde kaynak ataması ve CAAS sıralaması, 10.4% ile 65.0% arasında süre tasarrufu sağlar.
Vercel, ajanların yazılımı kullanırken karşılaştıkları başarıyı ölçmek için uçtan uca değerlendirme (eval) metodolojisini açıklıyor. Ajanlar, keşiften başarıya uzanan huni içinde insanlarla aynı adımları izler. Bu makale, LLM çıktılarındaki değişkenlik nedeniyle tekil testlerin yetersiz kaldığını vurguluyor ve tekrarlanabilir, puanlanan görev setleri öneriyor.
Vercel1 dk okuma
1–12 / 24 yayın
Nasıl hazırlıyoruz?
Kaynağı belli. Sınırları açık.
Resmî duyuruları, araştırma makalelerini ve açık kaynak projelerinin sürüm notlarını yapay zekâ ile Türkçe özetliyoruz. Her haberde kaynak bağlantılarına, kullanım alanlarına ve açıklanmayan noktalara yer veriyoruz.
Doğrudan kaynak
Araştırma makalesine, model duyurusuna veya projenin deposuna haberden ulaşabilirsiniz.
Bulgular ve yorumlar
Kaynakta açıklanan sonuçları, olası kullanım alanları ve bilinmeyenlerden ayrı sunuyoruz.
Görsellerin kaynağı
Görsel ve videoların kaynağını belirtiyoruz. Konuyu anlatmak için kullanılan illüstrasyonları da işaretliyoruz.
Araştırma kaynakları
Makaleleri kendiniz keşfedin.
Yeni çalışmalar bulabileceğiniz dizinler ve araştırma laboratuvarları. Bir görsel özet ilginizi çekerse sonuçları özgün makaleden okuyun.

 Video