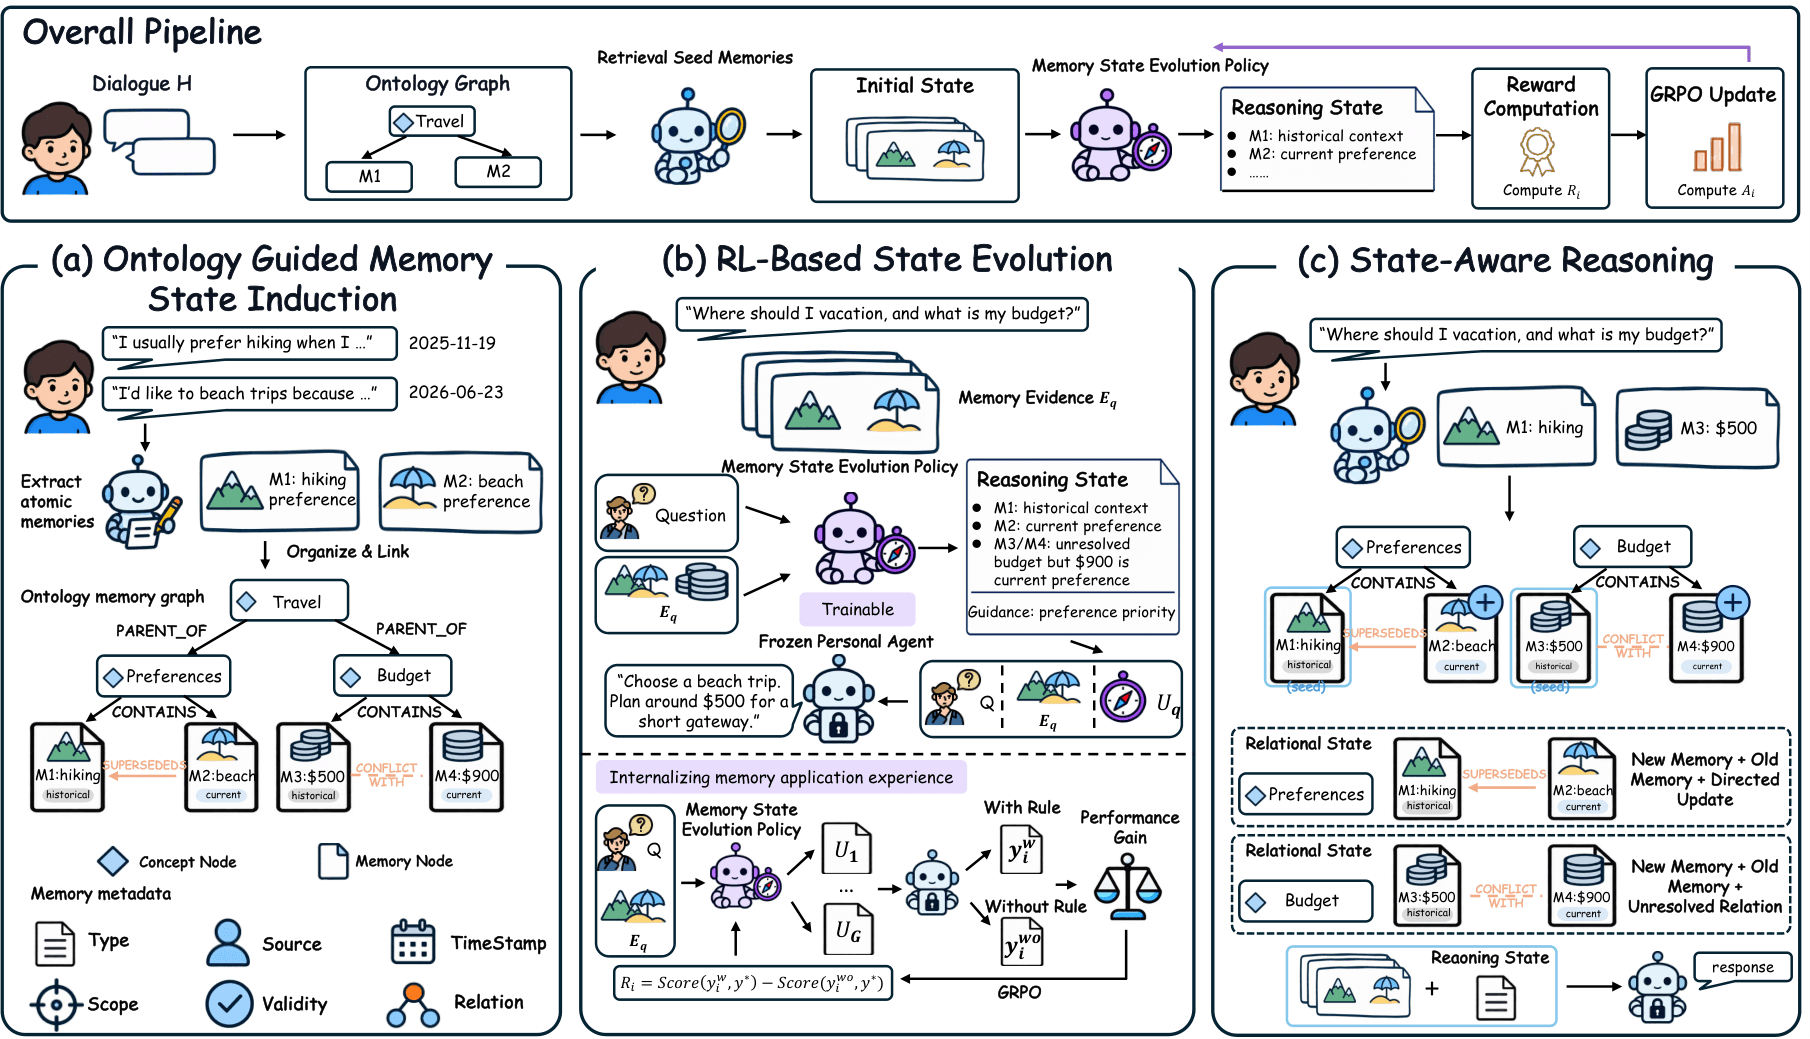
EvoMemState, LLM tabanlı kişisel asistanlar için uzun vadeli hafıza yönetimini bağımsız olgular yerine evrilen durumlar üzerinden ele alan yeni bir çerçevedir. Sistem, olguların geçerliliğini ve ilişkilerini koruyan İlişkisel Durumlar ile güncel isteğe özgü uygulama stratejisi üreten Akıl Yürütme Durumu bileşenlerini kullanır. Pekiştirmeli öğrenme ile desteklenen bu yaklaşım, uzun vadeli diyalog testlerinde mevcut sistemlere kıyasla tutarlı iyileşmeler sunmaktadır.
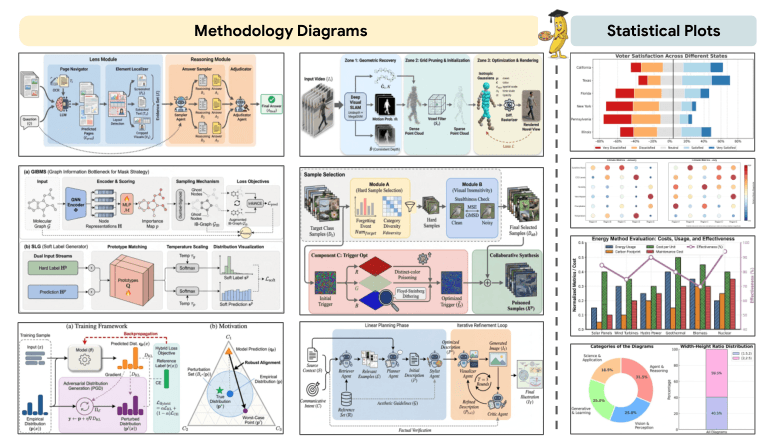
Bu çalışma, büyük dil modeli ajanlarının bilgisayar grafikleri kodu üretme ve iteratif olarak iyileştirme yeteneklerini inceleyen kapsamlı bir derlemedir. Ajan tabanlı grafik alanındaki hızlı büyüme, manuel literatür taramalarını zorlaştırdığı için birleşik bir taksonomi ve ajan tabanlı literatür sistemi önerilmektedir.
Tao Ren ve ekibi, uzun süreli LLM ajanları için Multiscale Policy Optimization (MPO) yöntemini tanıttı. MPO, turn ölçeğinde avantaj tahmini ve önem örneklemesi kullanarak kredi dağıtımını hizalar. 4B ve 30B-A3B modellerinde arama, araç kullanımı ve otomasyon görevlerinde güçlü RL baz çizgilerine karşı tutarlı kazanımlar gösterildi.
arXiv1 dk okuma
1–3 / 3 yayın
Nasıl hazırlıyoruz?
Kaynağı belli. Sınırları açık.
Resmî duyuruları, araştırma makalelerini ve açık kaynak projelerinin sürüm notlarını yapay zekâ ile Türkçe özetliyoruz. Her haberde kaynak bağlantılarına, kullanım alanlarına ve açıklanmayan noktalara yer veriyoruz.
Doğrudan kaynak
Araştırma makalesine, model duyurusuna veya projenin deposuna haberden ulaşabilirsiniz.
Bulgular ve yorumlar
Kaynakta açıklanan sonuçları, olası kullanım alanları ve bilinmeyenlerden ayrı sunuyoruz.
Görsellerin kaynağı
Görsel ve videoların kaynağını belirtiyoruz. Konuyu anlatmak için kullanılan illüstrasyonları da işaretliyoruz.
Araştırma kaynakları
Makaleleri kendiniz keşfedin.
Yeni çalışmalar bulabileceğiniz dizinler ve araştırma laboratuvarları. Bir görsel özet ilginizi çekerse sonuçları özgün makaleden okuyun.