Bu çalışma, yazılım güvenlik açıklarını bulma ve yama uygulama süreçlerinde büyük dil modellerinin (LLM) evrimini değerlendiren bir çerçeve sunar. Araştırmacılar, otonomi seviyelerini sürüş otomasyonu ölçeğine benzeterek bu yetenekleri standartlaştırır. 2026 verileri, açıklanan kritik hataların sayısında ve on yıldır var olan bug'ların tespitinde artış gösterirken, raporlamadan düzeltmeye geçen sürelerde belirgin bir değişim gözlenmemiştir.
Stanford Üniversitesi'nden araştırmacılar, yapay zeka tedarik zincirindeki bağımlılıkları ve pazar yoğunlaşmasını haritalayan çok katmanlı bir veri seti yayımladı. Çalışma, modellerden altyapıya uzanan aktörler arası ilişkileri sistematik olarak ölçerek ekosistemin kırılgan noktalarını ve güç dinamiklerini ortaya koyuyor.
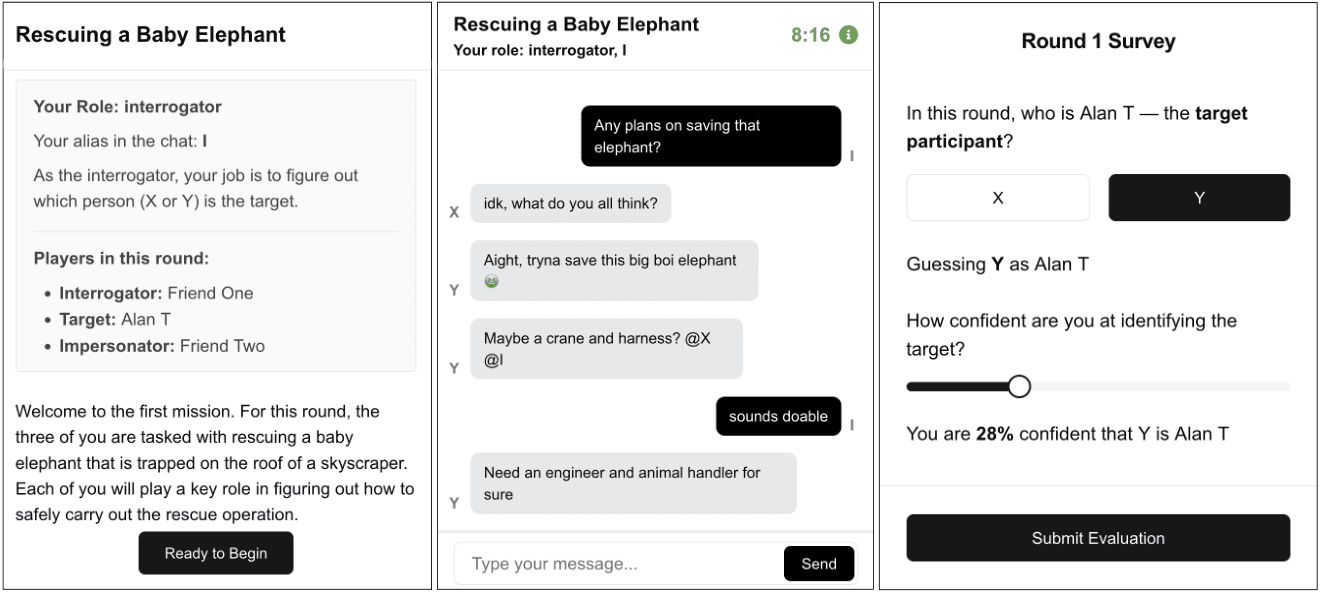
Araştırmacılar, büyük dil modellerinin belirli bir bireyin dijital kimliğini ne kadar iyi taklit edebildiğini ölçmek için Kişisel Taklit Oyunu'nu öneriyor. On yıllık kişisel veriyle eğitilen sistem, 20 kişilik bir testte yazarın arkadaşlarından daha sık seçildi. Ancak küçük örneklem nedeniyle bu fark istatistiksel olarak anlamlı bulunmadı. Çalışma, kimlik ve mahremiyet açısından yeni sorular ortaya koyuyor.
Yeni bir çalışma, RNN'lerdeki uzun bağımlılık sorunlarının yalnızca gradyan patlamasından değil, gizli durumun rank kısıtlamalarından da kaynaklandığını gösteriyor. Araştırmacılar, zaman kapasitesini koruyan yapılandırılmış yüksek boyutlu durum dinamikleri öneriyor. Bu yaklaşım, standart RNN formülasyonu içinde kalarak hızlı öğrenme sağlıyor ve gradyan istikrarı tek başına yeterli olmadığını kanıtlıyor.
Bu çalışma, görsel dil modellerinin bir görseli betimlerken nesneleri hangi sırayla listelediğini belirleyen içsel mekanizmayı ortaya koyar. Araştırmacılar, bağlama, seçme ve bakış başları olarak adlandırılan dört ana bileşenli bir planlama sürecini tanımlar. Bu mekanizma, Qwen3-VL modellerinde neden-sonuç yamaları ile doğrulanmış ve farklı girdi formatlarında tutarlılık göstermiştir.
Bu çalışma, nedensel öncü veri uyumlu ağlarda (PFN) gerçek ve karşı-faktüel dünyaların ortak öğrenilmesini önerir. Mevcut yaklaşımların tek dünya kısıtlamasını aşarak iki dünya arasındaki bağımlılığı korur. En iyi taşıma yöntemiyle ortalama tedavi etkisi yoğunluğunu yaklaşık olarak hesaplar ve belirsizlik ölçümünü iyileştirir.
eDIAR, sabit slotlu sinirsel ayrıştırıcıların konuşmacı sayısını aşma sorununu yeniden eğitim gerektirmeden çözen bir yöntem sunar. e-means algoritması kullanılarak, slotlar dolduğunda konuşmacı gömülmeleri kümelendirilir. Bu yaklaşım, saatler süren toplantılarda hata birikimini önler ve büyük arşivlerde konuşmacı eşleştirme maliyetini düşürür. Sistem, Streaming Sortformer gibi modelleri açık konuşmacılı hale getirebilir.
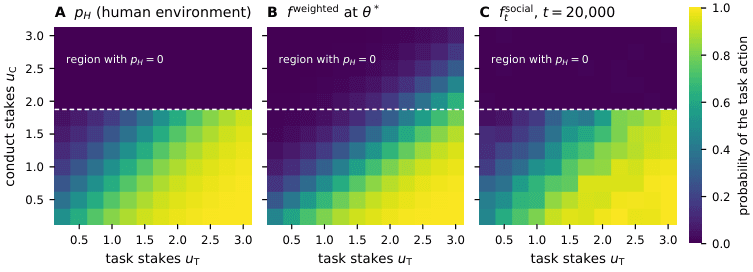
Bu çalışma, yapay zeka ajanlarının görev tamamlama ve davranış kuralları arasındaki çatışmayı evrimsel seçim çerçevesinde inceler. Araştırmacılar, ajan kopyalarının yalnızca ödüllendirilen eylemi yapanların çoğaldığı bir modelde üç farklı politika karşılaştırır. Görev odaklı politika yalnızca görev ödüllendiren ortamlarda başarılı olurken, öğrenilen politika insan ödülleriyle sosyalize edilerek çevrenin denge noktasına yakınsar.
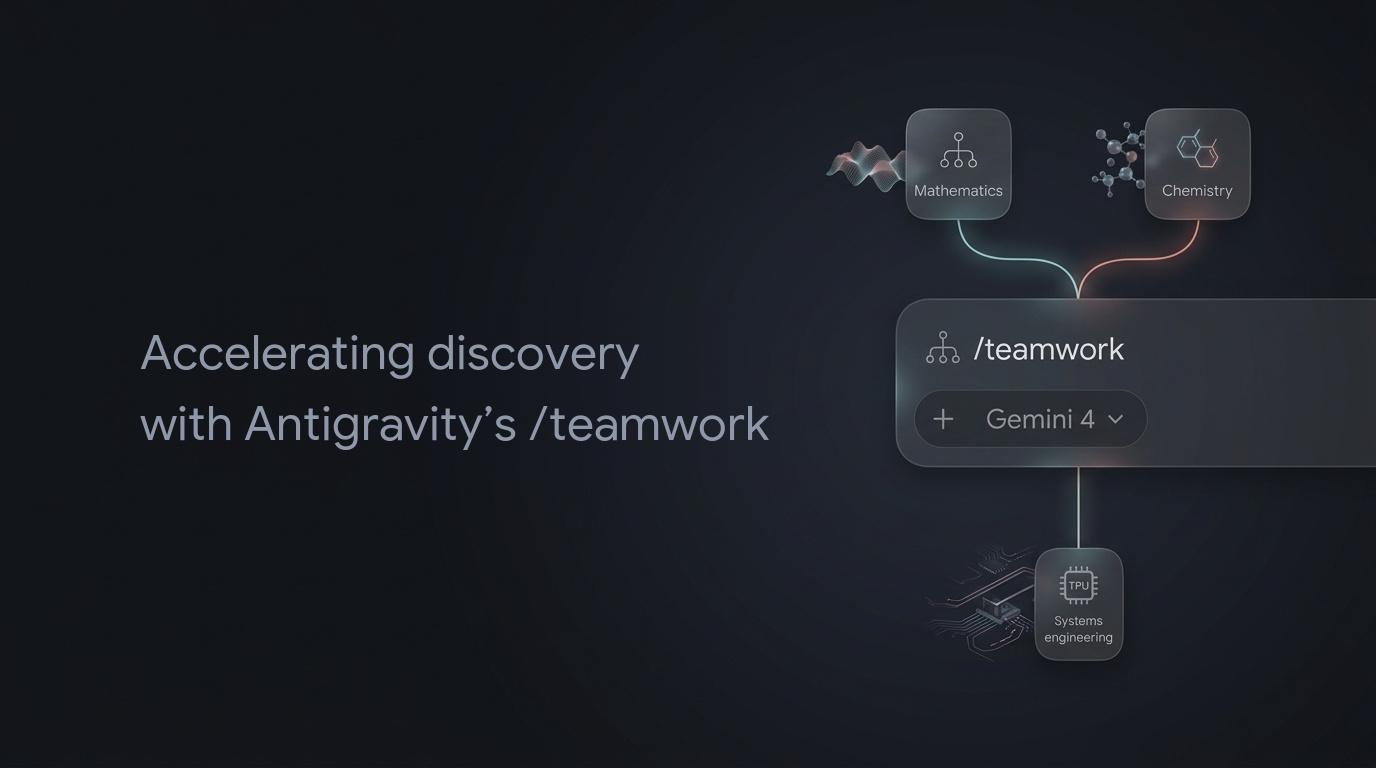
Google Research, Antigravity'nin /teamwork çoklu ajan sistemini kullanarak matematik, kimya ve yazılım mühendisliğindeki açık problemleri çözmek için Gemini 4 modellerini kullandı. Sistem, paralel keşif ve bağımsız doğrulama döngüleriyle uzun soluklu görevlerde tutarlılık sağlıyor. Bu araçlar, araştırmacılara karmaşık problemleri otomatikleştirilmiş iş akışlarıyla ele alma imkânı sunuyor.
Open Vision Banana, önceden eğitilmiş görüntü üreticilerini çok görevli algı sistemlerine dönüştüren tamamen açık ve yeniden üretilebilir bir tarife sunar. Çalışma, genelleyebilirlik için kritik tasarım seçimlerini analiz eder ve Cityscapes'te sıfır atış performansında Vision Banana'yı aşar. Ayrıca, yeniden eğitim gerektirmeyen test zamanı ölçeklendirme yöntemi olan legend ensembling'i tanıtır.
Bu çalışma, transformer modellerinin kompozisyonel genelleme yeteneğini sistematik olarak değerlendirir. Araştırmacılar, eğitim ve test dağılımlarındaki kompozisyon eşdeğerliği ile modül örtüşmesinin performans üzerindeki belirleyici rolünü ortaya koyar. Doğrudan modellerin başarısının büyük ölçüde eşdeğer kompozisyonlardan kaynaklandığı ve bu faktörlerin benchmark tasarımında dikkate alınmamasının yanıltıcı sonuçlara yol açtığı gösterilir.
arXiv / cs.AI + cs.CL1 dk okuma
1–12 / 15 yayın
Nasıl hazırlıyoruz?
Kaynağı belli. Sınırları açık.
Resmî duyuruları, araştırma makalelerini ve açık kaynak projelerinin sürüm notlarını yapay zekâ ile Türkçe özetliyoruz. Her haberde kaynak bağlantılarına, kullanım alanlarına ve açıklanmayan noktalara yer veriyoruz.
Doğrudan kaynak
Araştırma makalesine, model duyurusuna veya projenin deposuna haberden ulaşabilirsiniz.
Bulgular ve yorumlar
Kaynakta açıklanan sonuçları, olası kullanım alanları ve bilinmeyenlerden ayrı sunuyoruz.
Görsellerin kaynağı
Görsel ve videoların kaynağını belirtiyoruz. Konuyu anlatmak için kullanılan illüstrasyonları da işaretliyoruz.
Araştırma kaynakları
Makaleleri kendiniz keşfedin.
Yeni çalışmalar bulabileceğiniz dizinler ve araştırma laboratuvarları. Bir görsel özet ilginizi çekerse sonuçları özgün makaleden okuyun.

 Video