Bu çalışma, büyük dil modellerindeki n-gram arama tablolarını iki bitlik kodlarla sıkıştıran Conditional Program (CP) yöntemini tanıtıyor. CP, yalnızca istenen satırları yeniden oluşturarak tam tablo depolama ihtiyacını ortadan kaldırıyor. Gaussian trellis tabanlı bu yaklaşım, DeepSeek'te depolamayı 203GB'dan 51GB'a indiriyor.
OpenVLHarness, çok modlu büyük dil modelleri için araç kullanımı ve kalıcı görsel bellek sunan bir çerçevedir. Heterojen araç çıktılarını modelin okuyabileceği gözlemlere dönüştürerek 22 test setinde ortalama skorları 9.7-12.6 puan artırır. GPT-6 Luna ile orta çaba seviyesinde rakip sistemlere göre daha düşük token maliyetiyle üstün performans sağlar.
PremiseCheck, insan ve yapay zeka tarafından yazılan hakem değerlendirmelerindeki olgusal hataları tespit etmek için tasarlanmış verimli bir çerçevedir. ReviewFact veri seti, üç farklı alandaki hataları tek bir tanım altında etiketler. Sistem, LLM'lerin makaleyi okuma zorunluluğunu ortadan kaldırarak maliyeti ve gecikmeyi önemli ölçüde azaltır.
Mosaic, çok oturumlu ajan pekiştirmeli öğrenme için eleştirmansız hiyerarşik optimizasyon öneriyor. Yöntem, oturum katkılarını ayırt ederek avantaj tahminini şekillendiriyor. BrowseComp üzerinde Qwen3.5-4B ile test edilen model, yayınlama yöntemine göre daha az oturumla daha iyi sonuçlar aldı.
CalOn, varlık, ilişki ve olay çıkarımını tek bir 0.6B parametreli kodlayıcıda birleştiren yeni bir modeldir. Metin ve tip tanımlarını birlikte kodlayarak ortak olasılıksal bir formülasyon sunar. 40 referans setinde değerlendirilen model, ilişki çıkarımında liderlik ederken olay tetikleyicilerinde en yüksek ortalama F1 skoruna ulaşır. Kalibrasyon yöntemi, güven tahminlerini iyileştirirken performans kaybını en aza indirir.
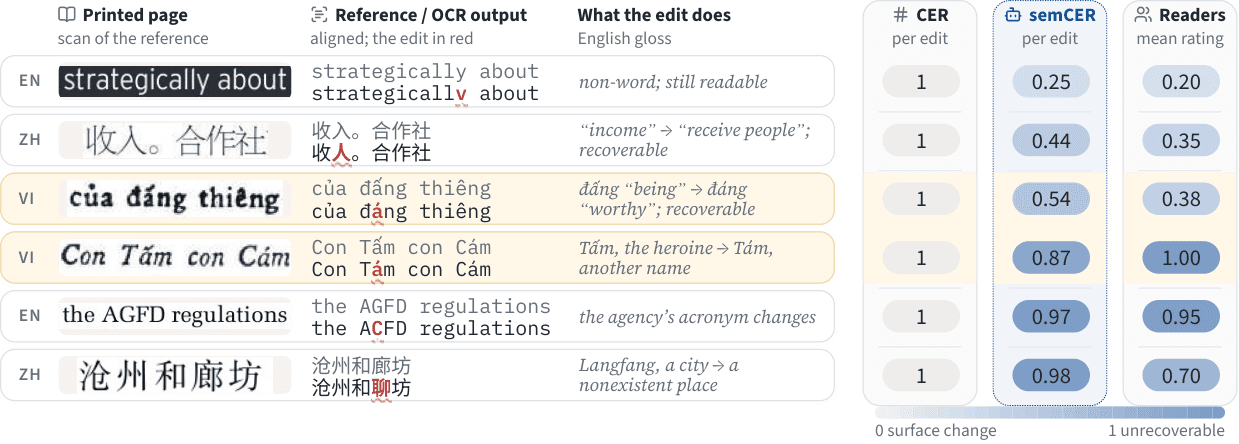
Bu çalışma, OCR ve görsel-dil modelleri için standart hata metriği olan CER'in sınırlılıklarını ele alır. Yazarlar, her karakter hatasına önem derecesi atayan semCER metrikini sunar. semCER, LLM tabanlı bir yargıç kullanarak hataları ağırlıklandırır ve okuyucu algısıyla daha iyi örtüşür. Çalışma, İngilizce, Vietnamca ve Çince dahil 16 dilde test edilmiştir.
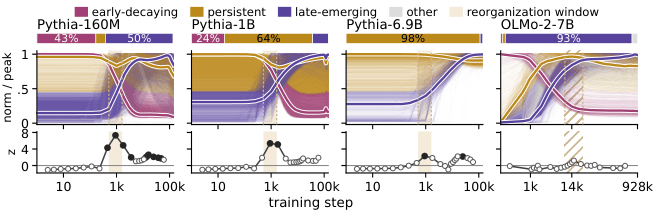
Bu çalışma, dil modellerinde yetkinlik kazanımının zamanlamasını okuma matrisi dinamikleri üzerinden inceler. Araştırmacılar, gizli durumların çıktıları ifade etmeden önce görev bilgisini kodlayabildiğini ve okuma hızının bu gecikmeyi belirlediğini gösterir.
Virtual Head Attention, uzun bağlam LLM'lerde KV önbellek boyutu, eğitim maliyeti ve model kalitesi arasındaki dengeyi iki hafif doğrusal işlemle iyileştirir. Yöntem, fiziksel sorgu başlarını yarıya indirirken sanal baş çeşitliliğini korur ve çıkarım sırasında standart GQA-2 mimarisine dönüşerek mevcut optimizasyonları yeniden kullanır.
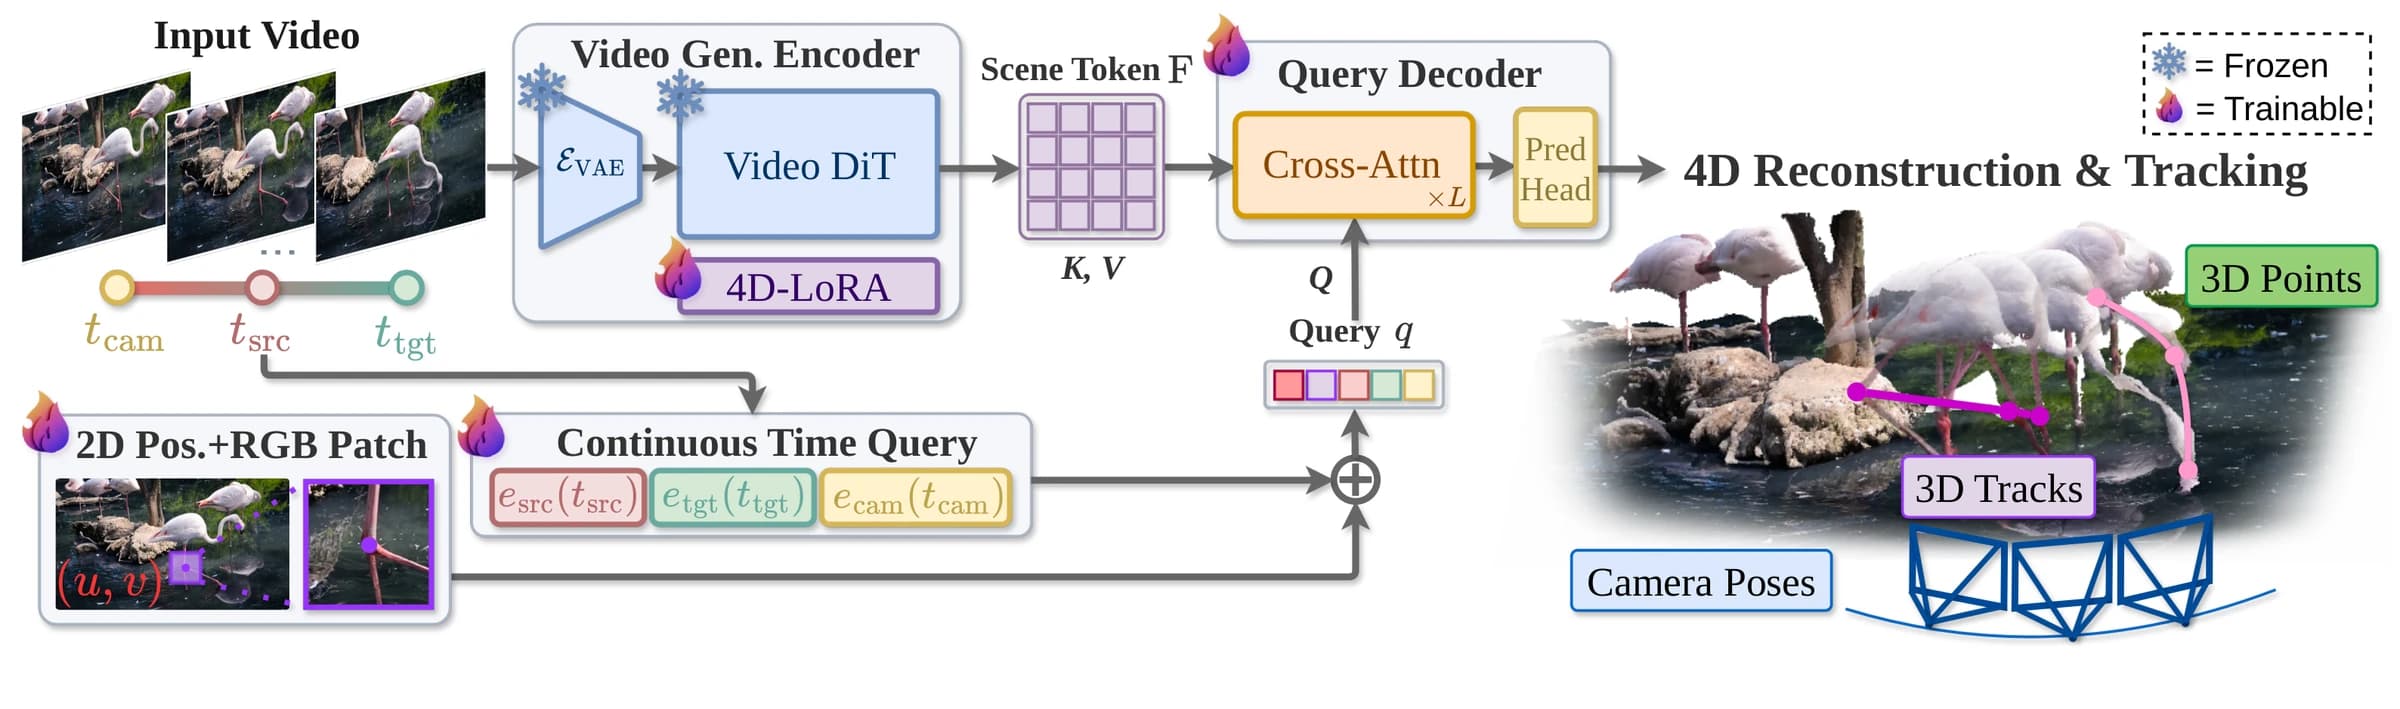
Gen4P, monoküler videodan 4D geometri ve hareketi kurtarmak için video üreticilerini ileri beslemeli algılayıcıya çeviren bir çerçevedir. Tek kodlayıcı geçişinde temiz gizli değişkenleri işler ve video derinlik LoRA'sı ile geometrik bilgiyi güçlendirir. 3D nokta takibi ve kamera duruşu tahmininde rekabetçi sonuçlar sunar.
StreamErase, video nesne silme işlemlerindeki yüksek gecikme sorununu çözmek için tasarlanmış bir akışkan üretim modelidir. Tek GPU üzerinde saniyeden az gecikme ve 26 FPS'e kadar hız sunarak gerçek zamanlı etkileşim imkanı sağlar. Model, çift yönlü bir temel modelden tek yönlü bir akışkan silgiye yetenek aktarımı gerçekleştirir. Bu yaklaşım, uzun vadeli video işlemlerinde görsel sadakati korurken işlem maliyetini sabit tutar.
GTP, çevrim içi karar vermede verimli çıkarım ile uzun ufuklu akıl yürütme arasındaki gerilimi çözmek için difüzyon önceliğinden örneklenen aksiyon dizilerini öğrenilmiş dinamik ve ödül modelleriyle rafine eder. Bu model tabanlı çerçeve, yüksek boyutlu optimizasyon maliyetini azaltırken uzun vadeli bilgi yayılımını destekler.
SwarmRSI, bilimsel ajan sürülerinin kendi deneyimlerinden öğrenerek kendini geliştirmesini sağlayan bir çerçevedir. Ajanlar arası geri bildirim ve bileşen yeniden kullanımı ile hipotezleri iyileştirir. OpenProblems ve NatureBench gibi veri setlerinde en iyi performansı gösterdiği iddia edilmektedir.
arXiv1 dk okuma
1–12 / 29 yayın
Nasıl hazırlıyoruz?
Kaynağı belli. Sınırları açık.
Resmî duyuruları, araştırma makalelerini ve açık kaynak projelerinin sürüm notlarını yapay zekâ ile Türkçe özetliyoruz. Her haberde kaynak bağlantılarına, kullanım alanlarına ve açıklanmayan noktalara yer veriyoruz.
Doğrudan kaynak
Araştırma makalesine, model duyurusuna veya projenin deposuna haberden ulaşabilirsiniz.
Bulgular ve yorumlar
Kaynakta açıklanan sonuçları, olası kullanım alanları ve bilinmeyenlerden ayrı sunuyoruz.
Görsellerin kaynağı
Görsel ve videoların kaynağını belirtiyoruz. Konuyu anlatmak için kullanılan illüstrasyonları da işaretliyoruz.
Araştırma kaynakları
Makaleleri kendiniz keşfedin.
Yeni çalışmalar bulabileceğiniz dizinler ve araştırma laboratuvarları. Bir görsel özet ilginizi çekerse sonuçları özgün makaleden okuyun.