O2LaF, önceden eğitilmiş video difüzyon dönüştürücülerini gizli eylem öğrenmesi için yeniden kullanarak, etiketsiz videolardan aktarılabilir eylem temsilleri çıkarır. Model, aynı önceden eğitilmiş ağı hem ters hem de ileri dinamikler için uyarlayarak, az örnekli ve sıfır atışlı görevlerde güçlü performans gösterir. Bu yaklaşım, robotik ve navigasyon alanlarında yeni bir paradigma sunar.
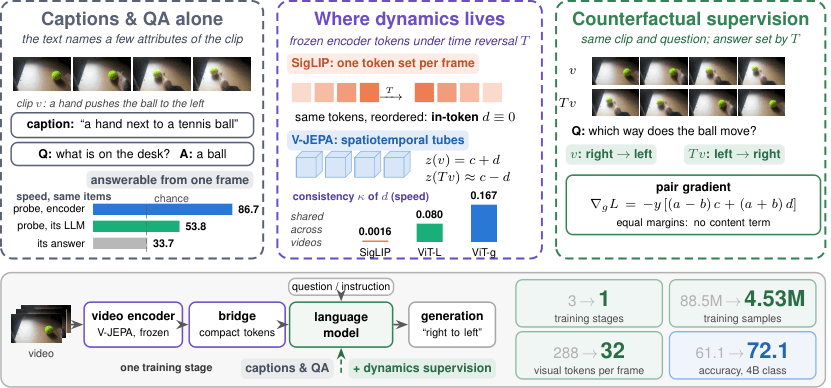
V-JEPA-LM, video dinamiklerini metin hizalı temsillerin ötesinde okuyan bir modeldir. Donmuş V-JEPA kodlayıcısının alt uzayındaki dinamikleri karşıt denetimle dil modeline aktarır. Tek aşamalı eğitimde 4.53M örnek ve 32 token kullanarak, çok aşamalı rakiplere kıyasla daha verimli bir performans gösterir.
arXiv1 dk okuma
1–2 / 2 yayın
Nasıl hazırlıyoruz?
Kaynağı belli. Sınırları açık.
Resmî duyuruları, araştırma makalelerini ve açık kaynak projelerinin sürüm notlarını yapay zekâ ile Türkçe özetliyoruz. Her haberde kaynak bağlantılarına, kullanım alanlarına ve açıklanmayan noktalara yer veriyoruz.
Doğrudan kaynak
Araştırma makalesine, model duyurusuna veya projenin deposuna haberden ulaşabilirsiniz.
Bulgular ve yorumlar
Kaynakta açıklanan sonuçları, olası kullanım alanları ve bilinmeyenlerden ayrı sunuyoruz.
Görsellerin kaynağı
Görsel ve videoların kaynağını belirtiyoruz. Konuyu anlatmak için kullanılan illüstrasyonları da işaretliyoruz.
Araştırma kaynakları
Makaleleri kendiniz keşfedin.
Yeni çalışmalar bulabileceğiniz dizinler ve araştırma laboratuvarları. Bir görsel özet ilginizi çekerse sonuçları özgün makaleden okuyun.