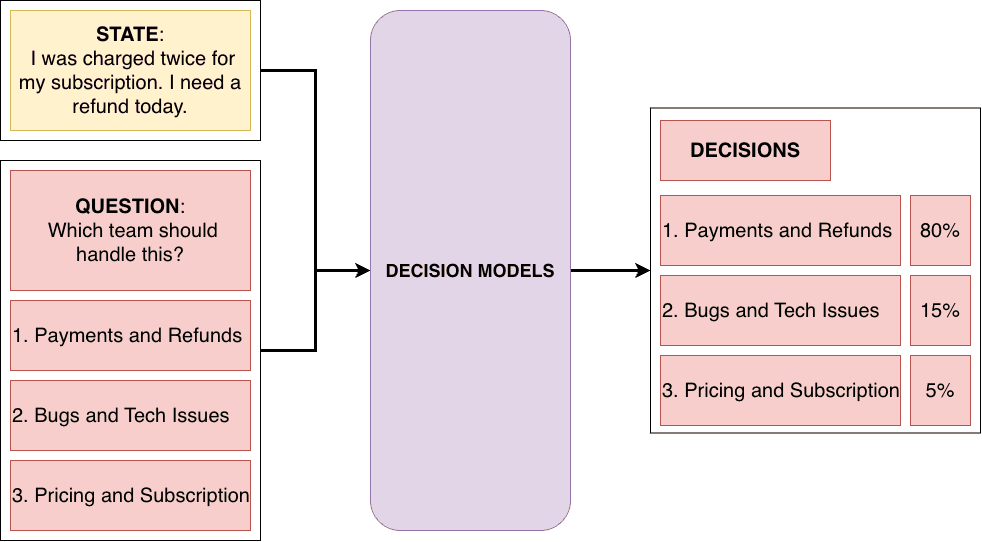
Hugging Face, metin üretimi yerine yapılandırılmış kararlar veren 'decision model' kavramını tanıttı. Bu modeller, belirli seçenekler üzerinde olasılık dağılımları döndürerek LLM'lerin şema uyumsuzluğu sorununu çözer. Transformers kütüphanesi, bu modeller için özel pipeline ve API uçları sunarak ekosistemde standart bir arayüz oluşturmayı hedefliyor.
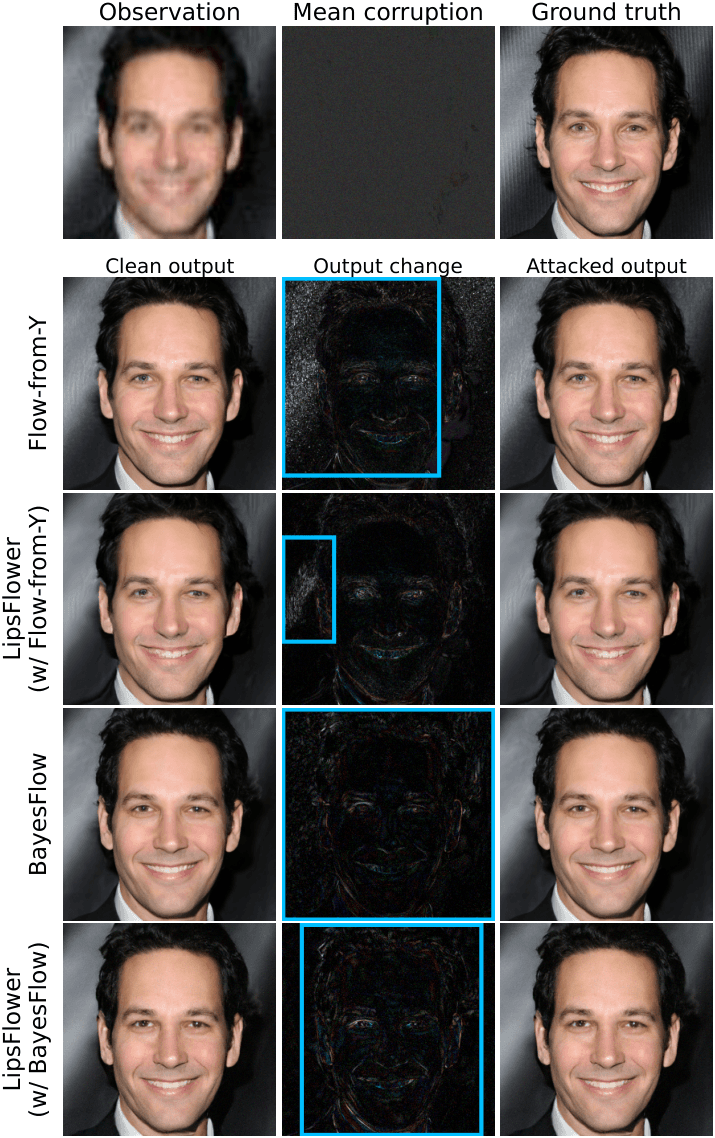
LipsFlower, akış eşleştirme modellerindeki giriş sapmalarının büyütülmesini azaltmak için Lipschitz sınırları türeten bir çerçevedir. LipHDiT mimarisi, stabilize spektral normalizasyon ve sınırlı modülasyon kullanarak bu sınırları uygular. Kör yüz onarımı testlerinde, model adversarial dayanıklılığı artırırken algısal kaliteyi rakiplerle rekabetçi düzeyde korur.
MC-JEPA, finansal zaman serilerinde piyasa şoklarını öngörülemez gürültü olarak değil, koşullu bir girdi olarak ele alan yeni bir mimaridir. Çin A-hisse verisi üzerinde yapılan testlerde, varlık bazlı öğrenmeye kıyasla risk, likidite ve piyasa maruziyeti tahminlerinde belirgin iyileşmeler sağladığı gösterilmiştir.
ProTEUS, protein evrimini sanal ortamda modelleyen kapalı döngü bir sistemdir. MutationFormer mimarisi ve fiziksel kısıtlı tahmin edici ile mutasyon etkilerini hızla analiz eder. Deneysel geri bildirimle aldehyde dehydrogenase ve levansucrase üzerinde 10 kat aktif varyantlar üretmiştir.
ExRL, robotik politikalarda uzun eylem parçacıklarının çevrim içi uyarlanmasında örnek verimliliğini artırmak için geliştirilmiş bir yaklaşımdır. Mevcut pekiştirmeli öğrenme yöntemleri, yüksek boyutlu eylem uzayı nedeniyle pahalı veri gerektirir. ExRL, bu sorunu eylem optimizasyonu yerine parçacık uygulama süresini tahmin eden hafif bir adaptörle çözer. Bu sayede adaptasyon uzayı düşük boyutlu kalır ve ifade gücü parçacık boyutuyla artar.
InfraRSI, dağıtık LLM eğitim altyapısını otomatik optimize eden ajan tabanlı bir çerçevedir. Beş aşamalı iş akışıyla bellek sınırlarını ve derleyici çakışmalarını yöneterek eğitim verimliliğini artırır. Dört iş yükünde 2.75 kat hızlanma ve MFU'da 17.4'ten 30.0'a iyileşme göstermiştir.
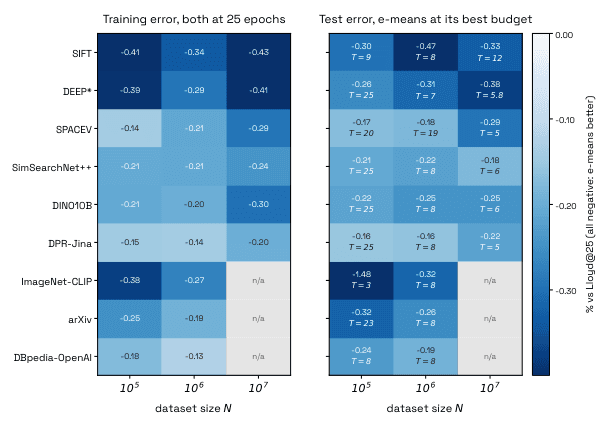
e-means, k-means için üstel hareketli ortalama optimizasyonu sunarak Lloyd algoritmasından daha hızlı ve düşük hata değerli sonuçlar üretir. Yazarlar, çökme oranı ve parti boyutu için formül tabanlı bir kural geliştirerek hiperparametre taraması gereksinimini ortadan kaldırır. Bu yaklaşım, büyük ölçekli gömme veri setlerinde önemli GPU hızlanmaları sağlar.
LingBot-Touch, farklı fiziksel prensiplere sahip dokunma sensörlerinden gelen verileri tek bir temsilde birleştiren bir temel modeldir. Bu model, difüzyon politikasından VLA modellerine kadar çeşitli mimarilere entegre edilebilir. Simülasyon ve gerçek robot testlerinde, karmaşık manipülasyon görevlerinde dokunma temsili sayesinde önemli iyileşmeler gözlemlenmiştir.
Siris, yapay zeka ajanlarının simülatör hatalarının tasarım kararlarını ne zaman etkilediğini ayırt edip edemediğini test eden bir çerçevedir. On üç sınır modelin değerlendirildiği çalışmada, sınırlamayı bilmek doğru seçimi garanti etmediği ve inceleme turunun yeni hatalar doğurabildiği görülmüştür.
onóna, dil modellerinde ağırlık bağlama maliyetini azaltırken çıktı ifadesini artıran iki tablolu bir parametrelendirme sunar. Transformer, iki gömme tablosunun ortalamasını girdi olarak alır ve çıktı kafası aynı tablolarla tanımlanan softmax dağılımlarını birleştirir. Mevcut gövdeyi değiştirmeden 142M, 330M ve 1B ölçeklerde çeşitli mimarilerde değerlendirilmiştir.
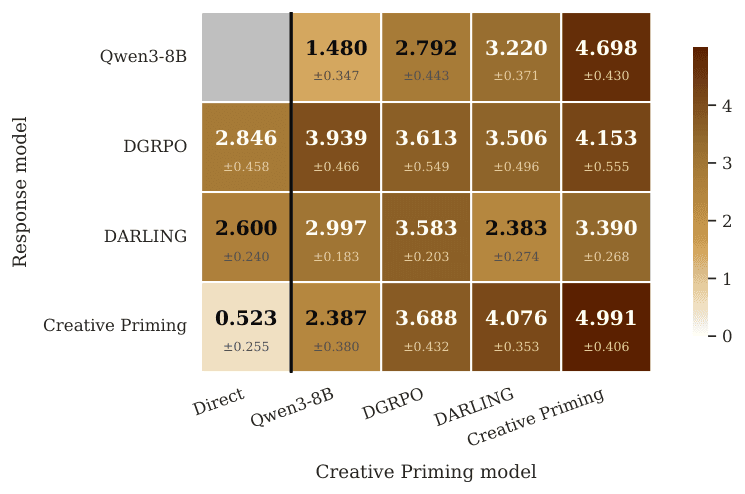
Bu çalışma, yapay zekada yaratıcılığın tekrar eden örneklerden öğrenilmesinin yarattığı paradoksu aşmak için 'yaratıcı priming' yöntemini önerir. Yaklaşım, yaratıcı süreci nihai üründen ayırarak bir priming modelinin GRPO ile eğitilmesini sağlar. Bu model, yeni ve çeşitli yanıtları teşvik eden primerler üretir; böylece model belirli sonuçları ezberlemek yerine yaratıcı üretimin altındaki ilkeleri öğrenir.
FewStepRL, az adımlı difüzyon modellerini pekiştirmeli öğrenme ile ince ayarlamak için mevcut RL hedeflerini sistematik olarak uyarlar. Çalışma, dönüşüm, ayrıştırma ve adaptasyon adımlarıyla bu modelleri ortak bir çerçeveye oturtur. Deneyler, ödül gradyanının uygunluğuna göre en iyi yöntemin değiştiğini ve ek çıkarım adımlarının genel performansta belirgin bir artış sağlamadığını gösterir.
arXiv1 dk okuma
1–12 / 99 yayın
Nasıl hazırlıyoruz?
Kaynağı belli. Sınırları açık.
Resmî duyuruları, araştırma makalelerini ve açık kaynak projelerinin sürüm notlarını yapay zekâ ile Türkçe özetliyoruz. Her haberde kaynak bağlantılarına, kullanım alanlarına ve açıklanmayan noktalara yer veriyoruz.
Doğrudan kaynak
Araştırma makalesine, model duyurusuna veya projenin deposuna haberden ulaşabilirsiniz.
Bulgular ve yorumlar
Kaynakta açıklanan sonuçları, olası kullanım alanları ve bilinmeyenlerden ayrı sunuyoruz.
Görsellerin kaynağı
Görsel ve videoların kaynağını belirtiyoruz. Konuyu anlatmak için kullanılan illüstrasyonları da işaretliyoruz.
Araştırma kaynakları
Makaleleri kendiniz keşfedin.
Yeni çalışmalar bulabileceğiniz dizinler ve araştırma laboratuvarları. Bir görsel özet ilginizi çekerse sonuçları özgün makaleden okuyun.