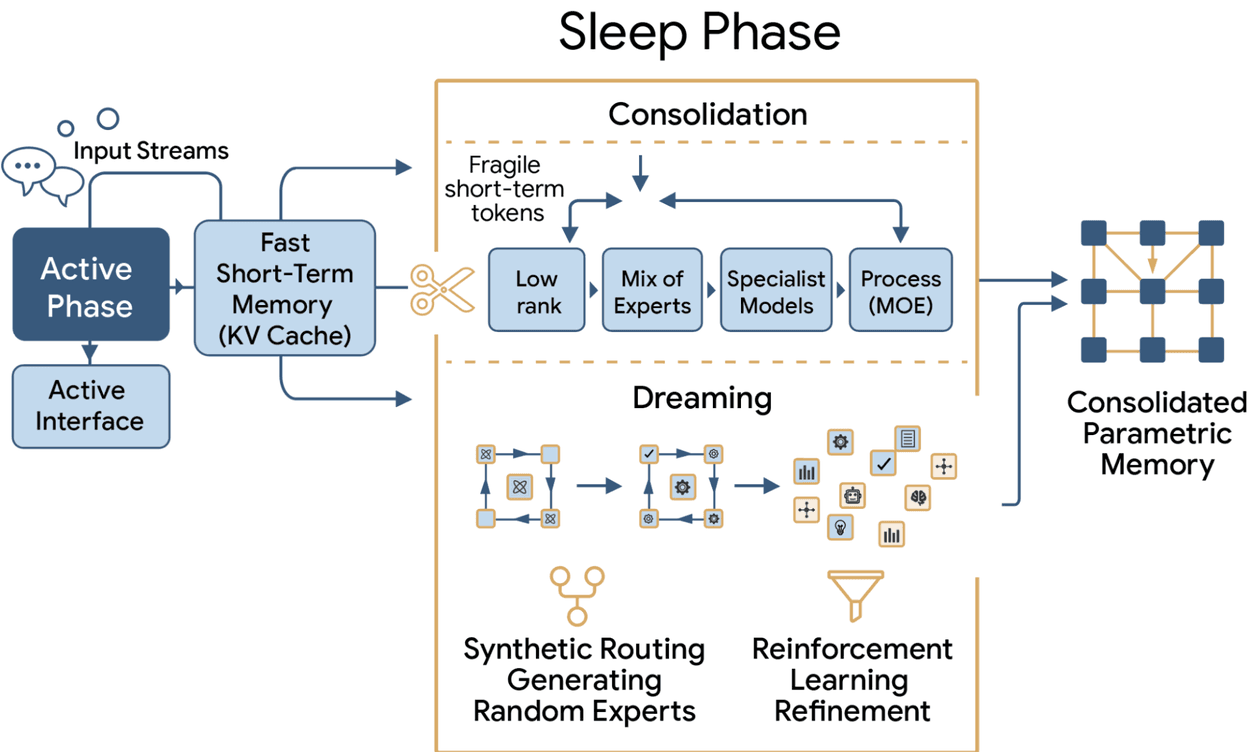
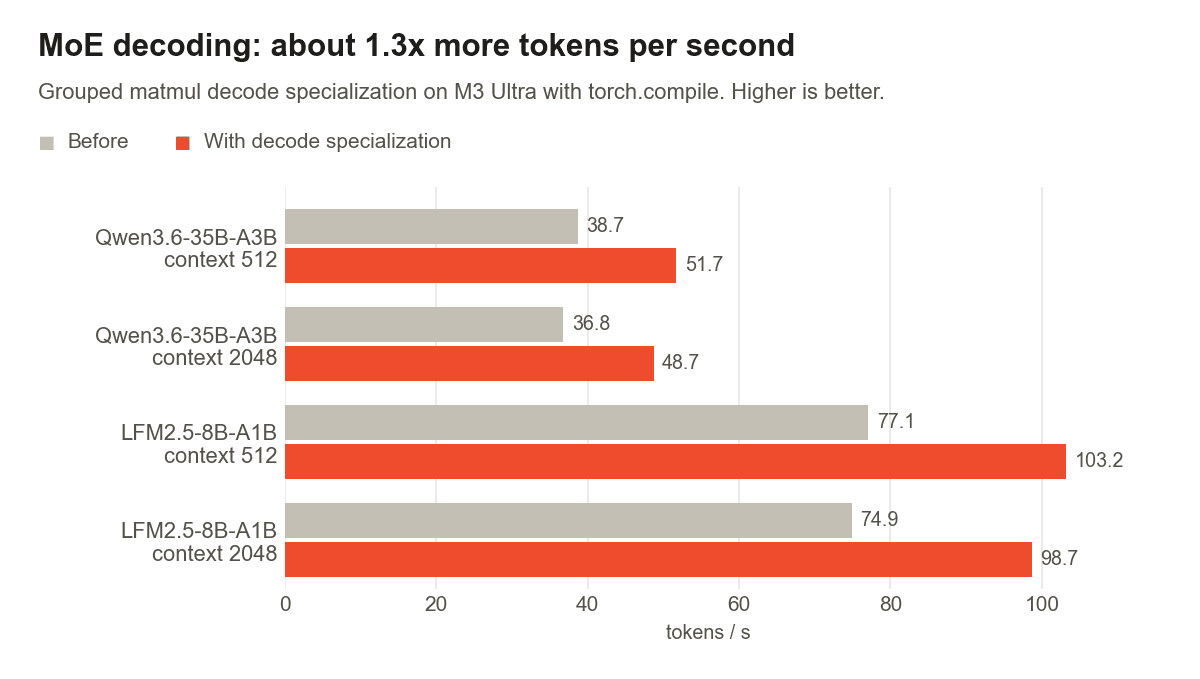Google Research, LLM'lerin sürekli öğrenmede felç edici unutmayı önlemek için 'uyku' çerçevesini tanıttı. Bu yöntem, aktif etkileşim ve çevrimdışı bellek konsolidasyonu arasında geçiş yaparak yeni bilgileri kalıcı parametrelere aktarır. MoE tabanlı genişleme ve rüya aşaması, modelin 10M token'a kadar uzun bağlamı ve karmaşık akıl yürütmeyi korumasını sağlar.
IQuest-Q1, 320B toplam ve 15B aktif parametreye sahip seyrek MoE mimarili bir ajan temel modelidir. Stable SplitNorm, Muon ve muP tekniklerini kullanan üç aşamalı eğitim süreciyle geliştirilmiştir. Model, kodlama ve genel görevlerde yetkinlik gösterir ve topluluk araştırması için açık kaynak olarak yayımlanmıştır.
PyTorch 2.15, Mac için MPS backend'ine FP8 desteği, MoE modellerde 5-6.5 kat hızlanan çözüm ve Wan2.2 video VAE'de 270 GiB'dan 8 GiB'a düşen bellek kullanımı getirir. Yeni Metal çekirdekleri, MPSGraph bağımlılığını azaltarak yerel model çalıştırma verimliliğini artırır.
Reflection, 501B parametreli ve 23B aktif MoE mimarili Beam modelini Apache 2.0 lisansıyla yayımladı. 1M token bağlam penceresi ve kodlama odaklı tasarım, kendi altyapınızda ölçeklenebilir ajan görevleri için güçlü bir temel oluşturur.
Transformers v5.20.0, Meta'nın Muse Spark Open ve InclusionAI'nin Ling 3.0 Flash gibi yeni MoE modellerini yerel olarak destekliyor. Dağıtık eğitimde FSDP ve TP kontrol noktalarının taşınabilirliği iyileştirilirken, eski önbellek yöntemleri kaldırıldı ve minimum kernels sürümü 0.17.2'ye yükseltildi.
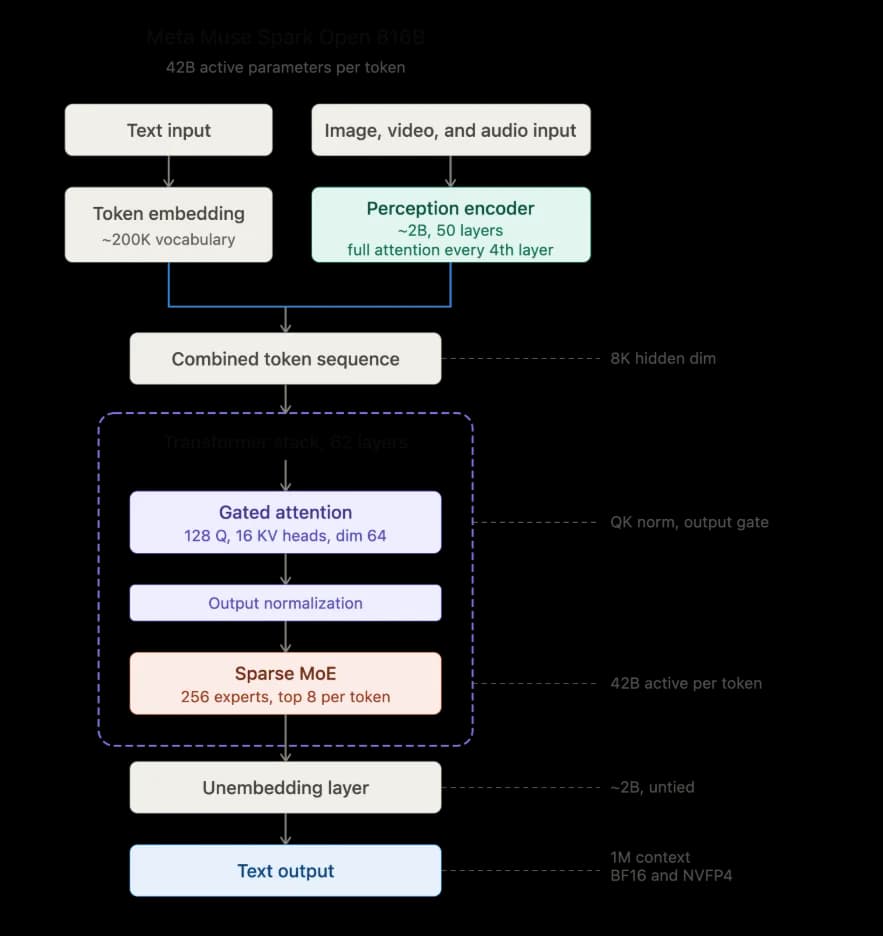
Meta, 816B parametreli ve 1M token bağlam penceresine sahip Muse Spark Open modelini yayımladı. NVIDIA GB300 NVL72 üzerinde eğitilen bu MoE mimarisi, agentic kodlama iş akışları için tasarlandı. Model, 42B aktif parametre ile çalışarak yüksek doğruluk ve güvenilir araç çağrısı sunar. NVFP4 optimizasyonu, bellek ayak izini küçültür ve üretim ortamında yüksek verimlilik sağlar.
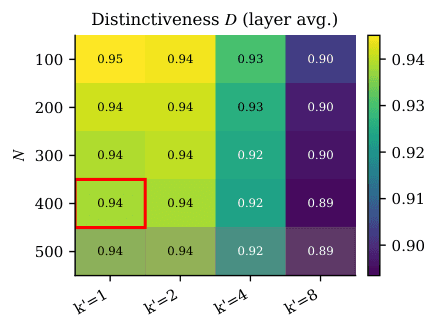
Araştırma, MoE tabanlı LLM'lerin kişiselleştirme süreçlerinde uzmanların rolünü açıklıyor. Yoğun modellere kıyasla MoE'ler, token'ları uzmanlara yönlendirerek çok anlamlılığı azaltıyor. Bu yapı, kişiselleştirme özelliklerinin hangi uzmanlarda kodlandığını izole etmeyi ve kontrol etmeyi mümkün kılıyor. Çalışma, üç açık ağırlıklı model üzerinde bu yaklaşımın etkinliğini test ediyor.
Transformers v5.20.1 sürümü, Reflection AI'ın kodlama ve ajan odaklı Beam modelini ekler. Ayrıca eski torch sürümlerindeki yükleme hataları ve HunYuan-VL ile DeepGEMM Mega MoE'deki çeşitli hata düzeltmeleri içerir.
Meta, Muse Spark Open adlı açık ağırlıklı, çok modlu MoE modelini yayınladı. 816B toplam parametre ve 42B aktif parametre ile metin, görüntü, ses ve video girdilerini işler. 1M token bağlam penceresi ve ajanik kodlama odaklı eğitim, uzun görevlerde planlama ve hata düzeltme kapasitesi sunar. BF16 ve NVFP4 checkpoint formatları mevcuttur.
Hugging Face1 dk okuma
1–9 / 9 yayın
Nasıl hazırlıyoruz?
Kaynağı belli. Sınırları açık.
Resmî duyuruları, araştırma makalelerini ve açık kaynak projelerinin sürüm notlarını yapay zekâ ile Türkçe özetliyoruz. Her haberde kaynak bağlantılarına, kullanım alanlarına ve açıklanmayan noktalara yer veriyoruz.
Doğrudan kaynak
Araştırma makalesine, model duyurusuna veya projenin deposuna haberden ulaşabilirsiniz.
Bulgular ve yorumlar
Kaynakta açıklanan sonuçları, olası kullanım alanları ve bilinmeyenlerden ayrı sunuyoruz.
Görsellerin kaynağı
Görsel ve videoların kaynağını belirtiyoruz. Konuyu anlatmak için kullanılan illüstrasyonları da işaretliyoruz.
Araştırma kaynakları
Makaleleri kendiniz keşfedin.
Yeni çalışmalar bulabileceğiniz dizinler ve araştırma laboratuvarları. Bir görsel özet ilginizi çekerse sonuçları özgün makaleden okuyun.