3D Gaussian Splatting tabanlı segmentasyon yöntemleri genellikle render edilmiş görünümler üzerinden eğitilir ve değerlendirilir. Bu durum, alfa karışımı özellik denetimi nedeniyle öğrenmenin baskın katkıcılara yoğunlaşmasına ve gizli veya düşük katkılı Gaussların zayıf denetlenmesine yol açar. VODA, bu uyumsuzluğu gidermek için yerel derinlik yapısını kullanan tak-çalıştır bir denetim hedefi önerir.
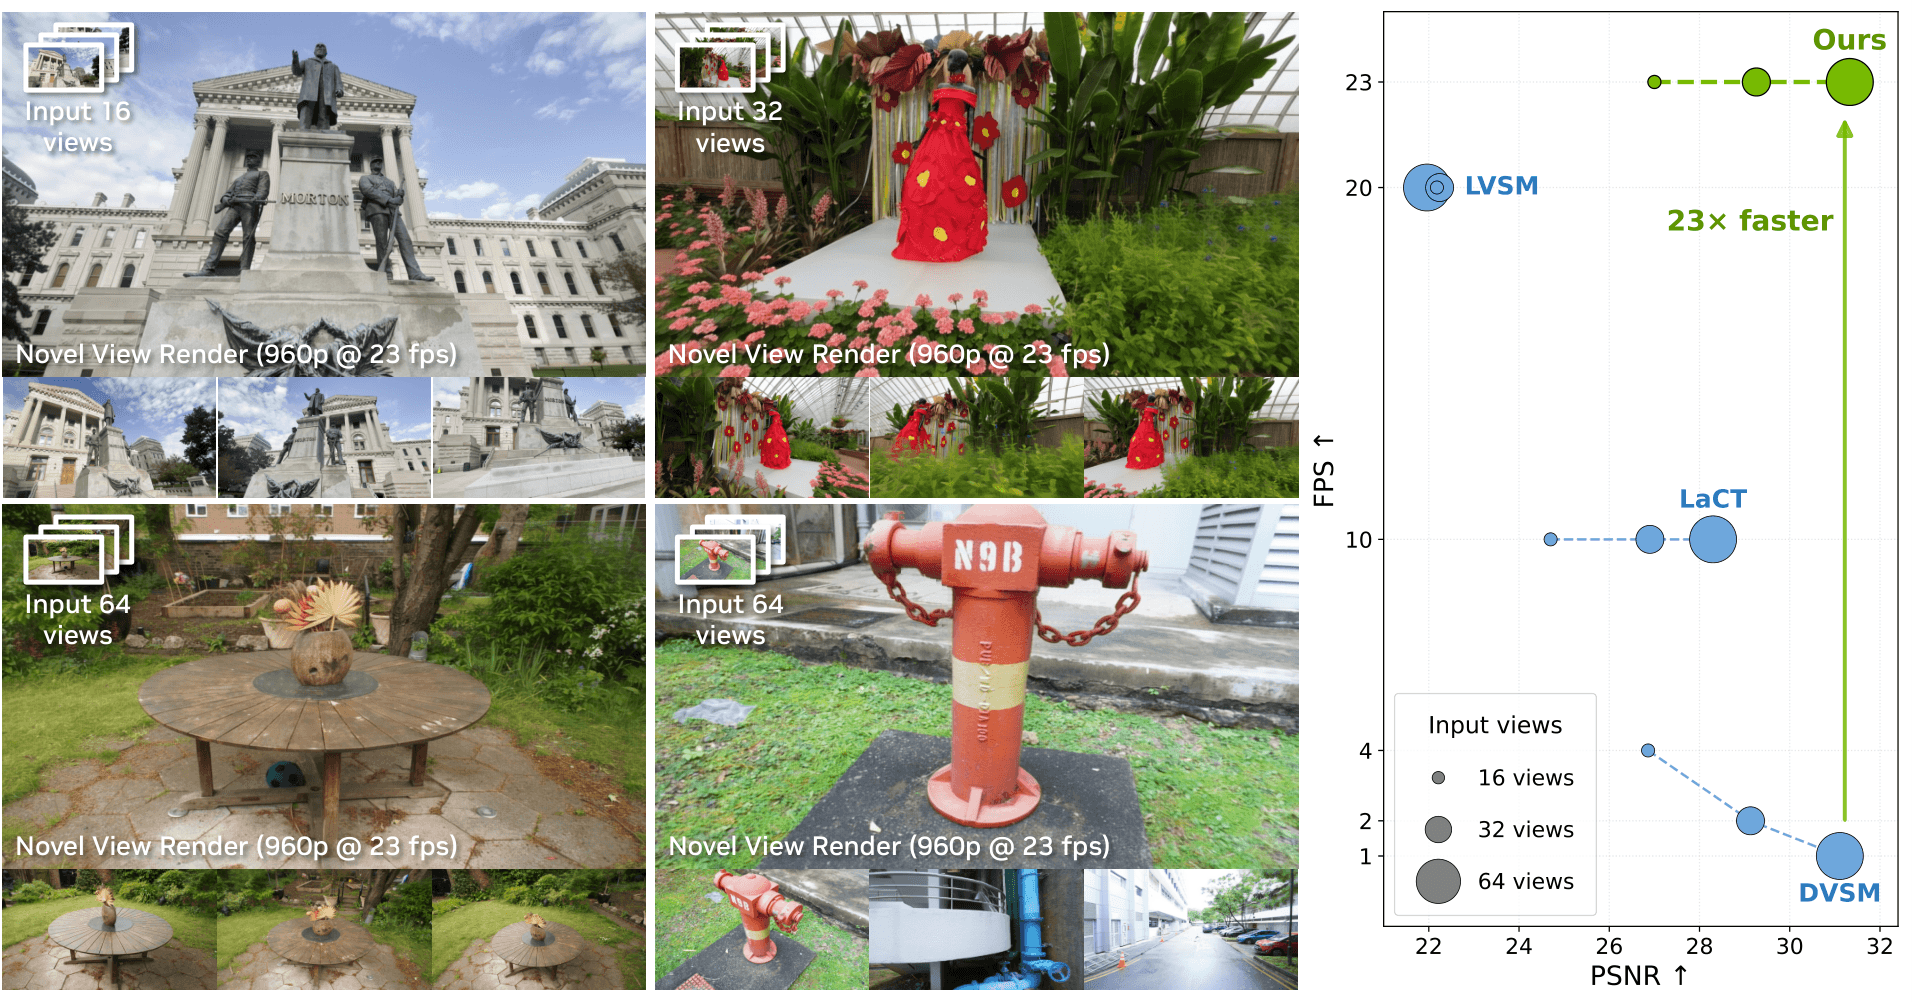
TTB, decoder-only Large View Synthesis Models için test zamanında pişirme stratejisi sunar. Cross-view attention bilgisini hafif bir MLP'ye aktararak render hızını artırır. Bu yöntem, TTT'nin kalite kaybını telafi ederken 3D geometri yeniden inşası gerektirmeden yeni görüş açılarını üretir.
FOAM, SOAP optimizörünün maliyetli bileşenlerini sadeleştirerek AdamW verimliliğine yakın bir performans sunar. Çıktı tarafı ön koşullandırmayı atar ve yoğun ikinci an yerine satır-sütun istatistiklerine dayalı bir tahminci kullanır. 124M-760M parametreli LLM ön eğitiminde SOAP ve Muon ile eşdeğer doğrulama kaybı elde edilir.
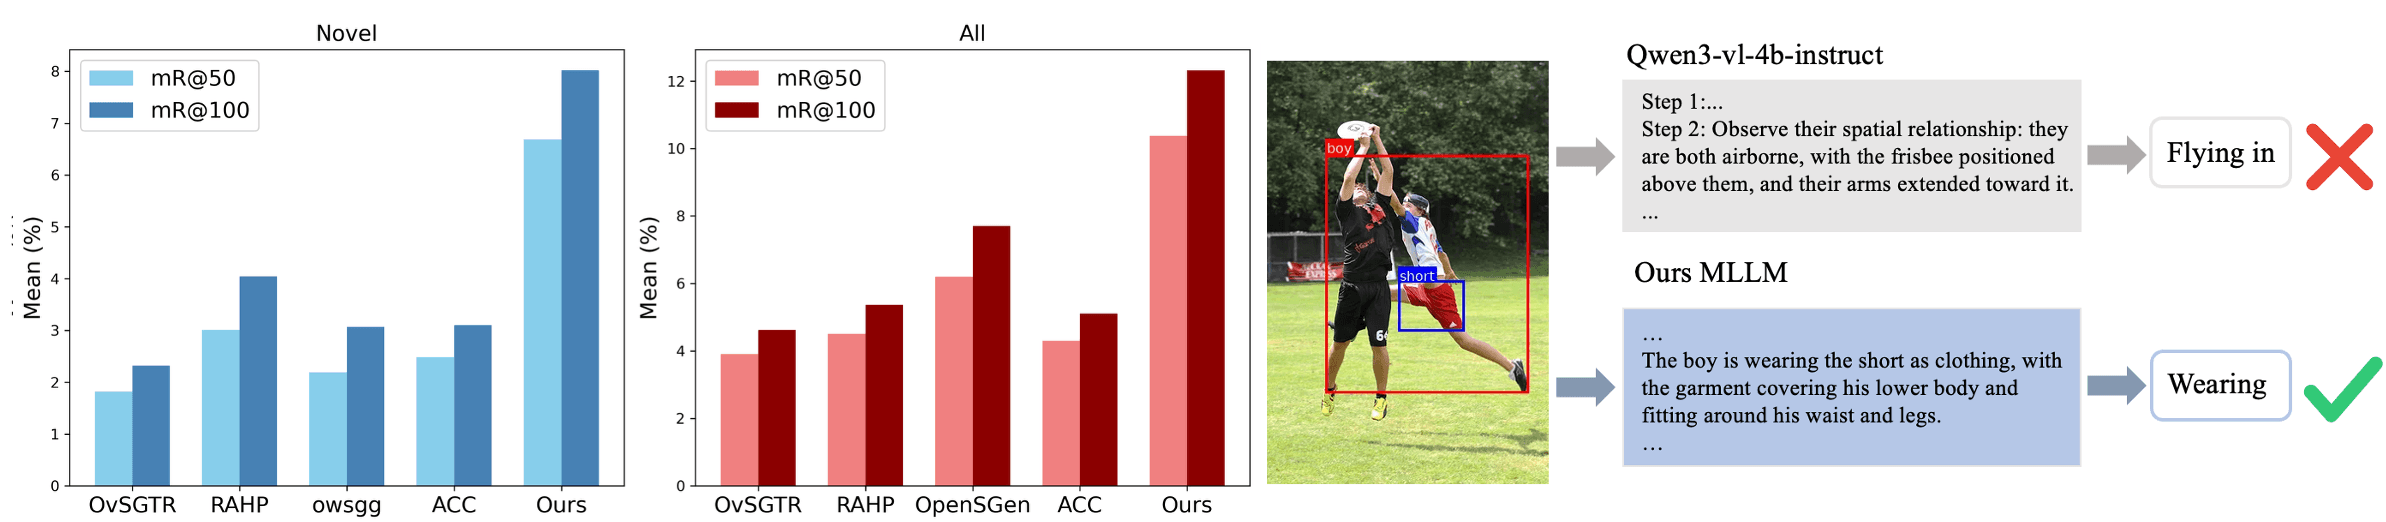
RaRe, açık sözlük sahne grafiği üretiminde MLLM zincirleme düşünce çıktılarını yapılandırılmış ilişki gömme uzayına dönüştürür. Kendi kendine denetimli karşıtlık öğrenmesi ve spesifiklik odaklı pekiştirmeli öğrenme ile nadir ilişkilerin ayırt edilebilirliğini artırır.
Bu çalışma, transformer modellerinin kompozisyonel genelleme yeteneğini sistematik olarak değerlendirir. Araştırmacılar, eğitim ve test dağılımlarındaki kompozisyon eşdeğerliği ile modül örtüşmesinin performans üzerindeki belirleyici rolünü ortaya koyar. Doğrudan modellerin başarısının büyük ölçüde eşdeğer kompozisyonlardan kaynaklandığı ve bu faktörlerin benchmark tasarımında dikkate alınmamasının yanıltıcı sonuçlara yol açtığı gösterilir.
Contrastive Discovery, LLM ajanlarının bilimsel keşiflerde hipotezleri tek tek test etmek yerine, birbirini dışlayan ve tümevarımla kapsayan rakip açıklamalar kümesiyle değerlendirmesini önerir. Bu yöntem, kanıtların inanç dağılımını nasıl yeniden şekillendirdiğine odaklanarak ajanların daha fazla soruyu aynı deneysel bütçeyle çözmesini sağlar. Altı alanda yapılan testlerde, noktasal yaklaşımın reddettiği adayların yüzde 73'ü bu kümeyle belirli bir alternatife indirgenmiştir.
WaveGen, Spectral Forcing mimarisiyle metinden doğrudan ses dalgası üreten uçtan uca bir difüzyon çerçevesidir. Model, dış ses kodlayıcılar veya süre tahmincileri gerektirmez. 0.1B ile 0.6B parametre aralığında ölçeklenerek Emilia veri setinde en iyi performansı göstermiştir.
Araştırmacılar, DINO gibi Vision Transformer modellerindeki belirsiz algısal temsilleri çözmek için iki yeni görsel odaklanma kaybı öneriyor. Bu kayıplar, çok başlı dikkat mekanizmasını kullanarak dikkat başlarının uzamsal olarak uzmanlaşmasını sağlıyor. Etiketsiz öğrenme yaklaşımı, sıfır atış görüntü segmentasyonu gibi yoğun tahmin görevlerinde hem yorumlanabilirliği hem de performansı artırıyor.
arXiv1 dk okuma
1–8 / 8 yayın
Nasıl hazırlıyoruz?
Kaynağı belli. Sınırları açık.
Resmî duyuruları, araştırma makalelerini ve açık kaynak projelerinin sürüm notlarını yapay zekâ ile Türkçe özetliyoruz. Her haberde kaynak bağlantılarına, kullanım alanlarına ve açıklanmayan noktalara yer veriyoruz.
Doğrudan kaynak
Araştırma makalesine, model duyurusuna veya projenin deposuna haberden ulaşabilirsiniz.
Bulgular ve yorumlar
Kaynakta açıklanan sonuçları, olası kullanım alanları ve bilinmeyenlerden ayrı sunuyoruz.
Görsellerin kaynağı
Görsel ve videoların kaynağını belirtiyoruz. Konuyu anlatmak için kullanılan illüstrasyonları da işaretliyoruz.
Araştırma kaynakları
Makaleleri kendiniz keşfedin.
Yeni çalışmalar bulabileceğiniz dizinler ve araştırma laboratuvarları. Bir görsel özet ilginizi çekerse sonuçları özgün makaleden okuyun.