
Araştırma
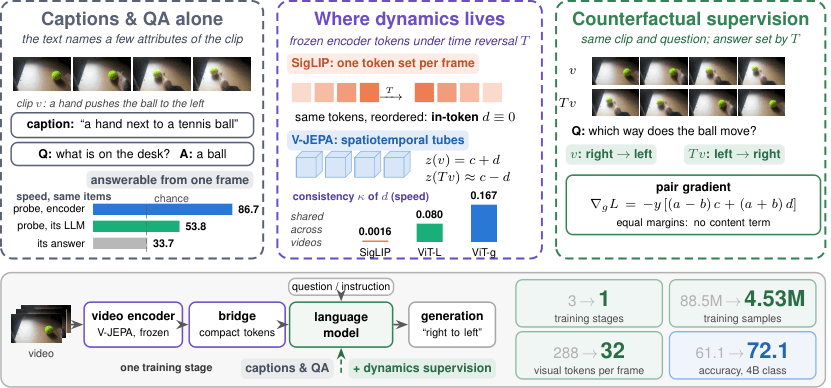
V-JEPA-LM: Video dinamiklerini metin hizalı temsillerin ötesinde okuyan model
V-JEPA-LM, video dinamiklerini metin hizalı temsillerin ötesinde okuyan bir modeldir. Donmuş V-JEPA kodlayıcısının alt uzayındaki dinamikleri karşıt denetimle dil modeline aktarır. Tek aşamalı eğitimde 4.53M örnek ve 32 token kullanarak, çok aşamalı rakiplere kıyasla daha verimli bir performans gösterir.
arXiv1 dk okuma
