Araştırmacılar, DINO gibi Vision Transformer modellerindeki belirsiz algısal temsilleri çözmek için iki yeni görsel odaklanma kaybı öneriyor. Bu kayıplar, çok başlı dikkat mekanizmasını kullanarak dikkat başlarının uzamsal olarak uzmanlaşmasını sağlıyor. Etiketsiz öğrenme yaklaşımı, sıfır atış görüntü segmentasyonu gibi yoğun tahmin görevlerinde hem yorumlanabilirliği hem de performansı artırıyor.
Bu çalışma, on-policy distillation'da eğitim ve çıkarım arasındaki uyumsuzluğun ne kadar tolere edilebildiğini inceler. Kuantizasyon ve asenkron dağıtımın etkilerini ölçen araştırma, OPD'nin RL yöntemlerine kıyasla daha kararlı olduğunu gösterir. FP8 kullanımı, KV önbelleği kapasitesini artırırken eğitim kalitesini korur.
Sergey Volkov, planar vektörlü regresyonda üç noktalı ağırlıklı seçim için minimum Frobenius normu en küçük kareler yönteminde üst sınırı 15/8'den 11/6'ya düşüren bir kanıt sunar. Çalışma, evrensel bir epsilon_0 değeri için T_3 <= (5/6 - epsilon_0)E eşitsizliğini kanıtlar ve bu sayede 13/8 <= F_weighted(2,2,3) < 11/6 aralığını belirler. Kanıt, skaler sertifika, eşitlik rijitliği ve kompaktlık argümanlarını birleştirir.
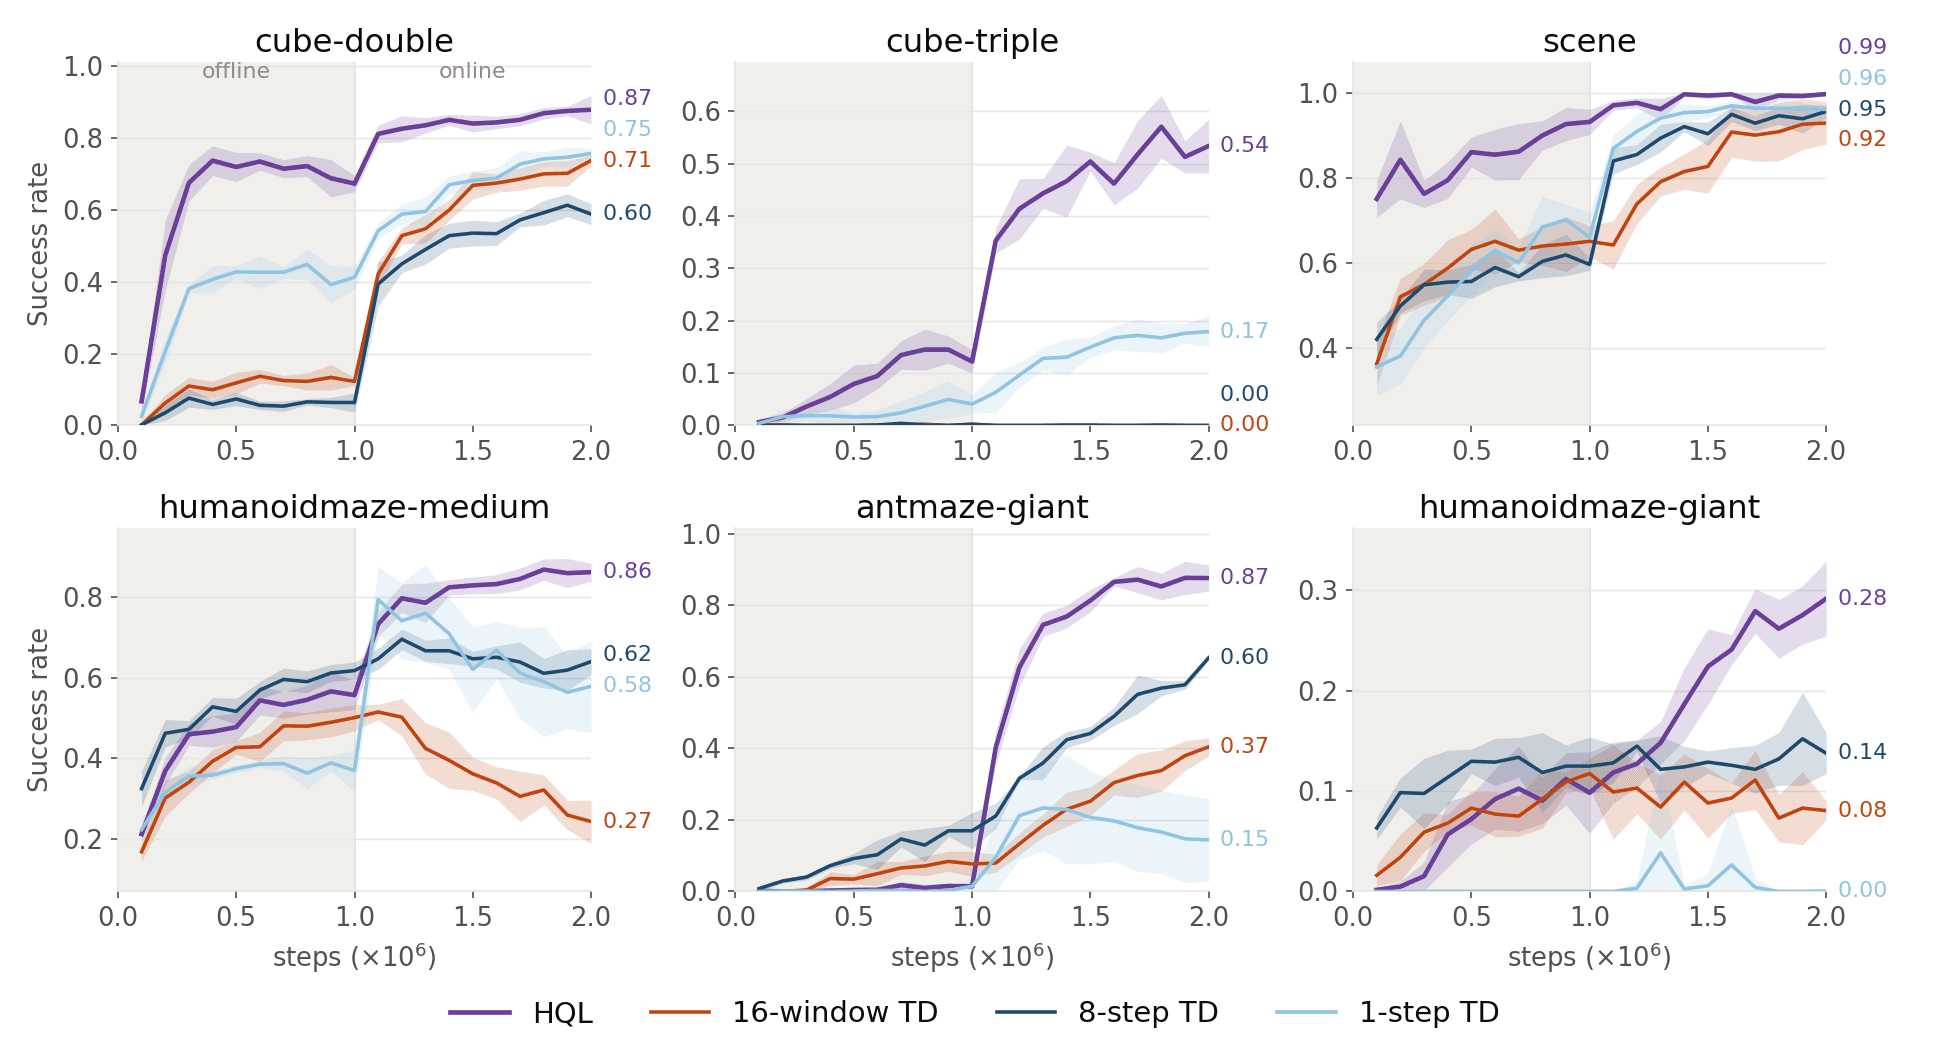
HQL, uzun ufuklu görevlerde değer öğrenimini iyileştirmek için tek adımlı ve çok adımlı hedefler arasında otomatik denge kuran basit bir yöntemdir. Eleştirmenin değerlendirmesine göre hedefi seçer ve eylem yoğunluğu gerektirmez. Bu sayede akış ve difüzyon politikalarıyla uyumlu hale gelir ve uzun ufuklu görevlerde önceki yöntemlere göre daha iyi performans gösterir.
Nano Banana gibi genel amaçlı üretken yapay zeka modelleri, tıbbi görüntüleme modelleri için sentetik eğitim verisi kaynağı olarak değerlendirildi. Dört modalitede yapılan geriye dönük çalışmada, sentetik veriyle eğitilen modeller gerçek veriyle benzer performans gösterdi. Ancak kalibrasyon ve net klinik fayda açısından tutarlı üstünlük sağlanmadı. Çalışma, sentetik verinin model denetimi ve alt grup temsilinde de kullanılabileceğini gösterdi.
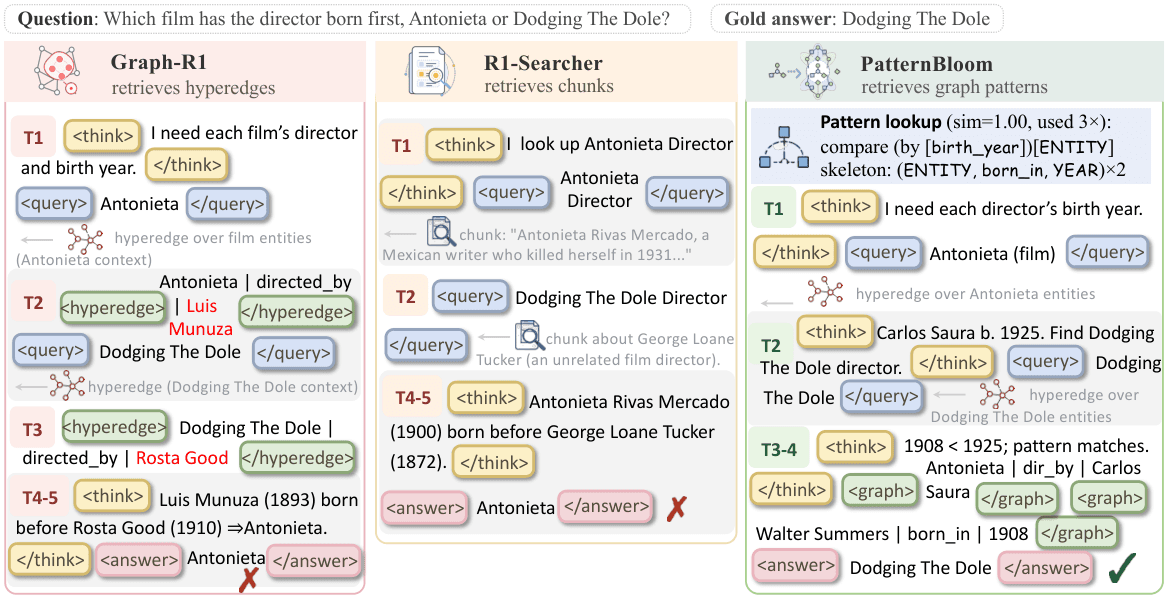
PatternBloom, RAG ajanlarında içerik yerine mantık kalıplarını dışsallaştırarak tekrarlayan akıl yürütme süreçlerini verimli hale getiriyor. İki aşamalı RL eğitimiyle oluşturulan grafik kalıp hafızası, 7B modelde 27 taban çizgisine karşı belirgin bir performans artışı sağlıyor.
arXiv / cs.AI + cs.CL1 dk okuma
145–150 / 150 yayın
Nasıl hazırlıyoruz?
Kaynağı belli. Sınırları açık.
Resmî duyuruları, araştırma makalelerini ve açık kaynak projelerinin sürüm notlarını yapay zekâ ile Türkçe özetliyoruz. Her haberde kaynak bağlantılarına, kullanım alanlarına ve açıklanmayan noktalara yer veriyoruz.
Doğrudan kaynak
Araştırma makalesine, model duyurusuna veya projenin deposuna haberden ulaşabilirsiniz.
Bulgular ve yorumlar
Kaynakta açıklanan sonuçları, olası kullanım alanları ve bilinmeyenlerden ayrı sunuyoruz.
Görsellerin kaynağı
Görsel ve videoların kaynağını belirtiyoruz. Konuyu anlatmak için kullanılan illüstrasyonları da işaretliyoruz.
Araştırma kaynakları
Makaleleri kendiniz keşfedin.
Yeni çalışmalar bulabileceğiniz dizinler ve araştırma laboratuvarları. Bir görsel özet ilginizi çekerse sonuçları özgün makaleden okuyun.