Bu çalışma, büyük dil modellerinin (LLM) statik metin yerine gerçek fiziksel ortamlarda nasıl davrandığını ölçen yeni bir benchmark sunar. Model, robotik kollar ve sensörlerle etkileşime girerek kapalı döngü kararlar alır. Araştırma, LLM'lerin fiziksel dünyada eyleme geçme yeteneklerini ve sınırlarını sistematik olarak analiz eder.
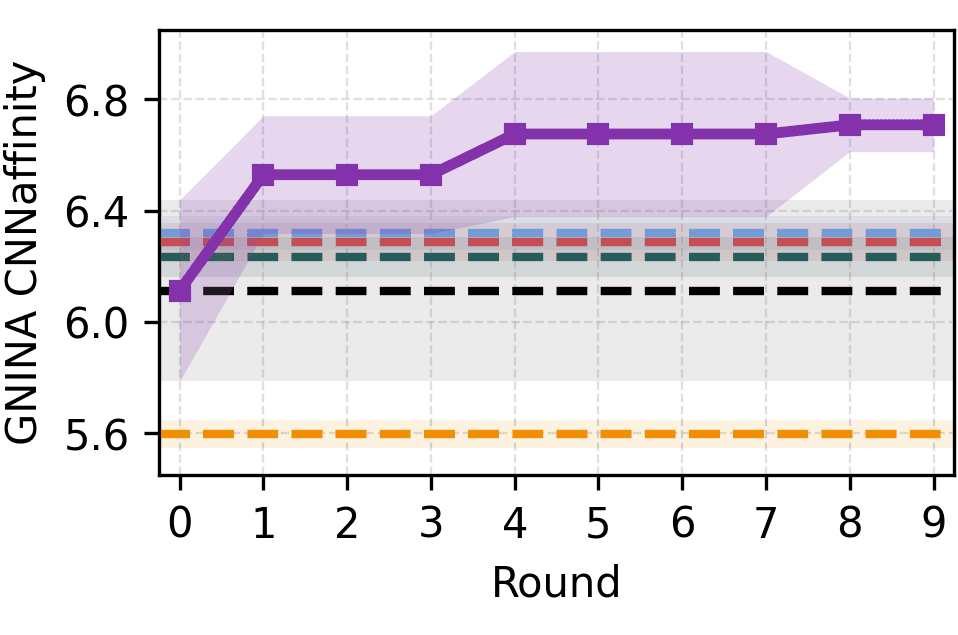
LLM-to-Flow Distillation, donmuş bir LLM'i bilimsel üreticiler için adaptif öğretmen olarak kullanarak doğal dil hedeflerini akış tabanlı modellere aktarır. Bu yöntem, açık ödül fonksiyonu gerektirmeden terapötik peptit ve küçük molekül tasarımında yeni bir üretim kontrolü biçimi sunar.
SwarmRSI, bilimsel ajan sürülerinin kendi deneyimlerinden öğrenerek kendini geliştirmesini sağlayan bir çerçevedir. Ajanlar arası geri bildirim ve bileşen yeniden kullanımı ile hipotezleri iyileştirir. OpenProblems ve NatureBench gibi veri setlerinde en iyi performansı gösterdiği iddia edilmektedir.
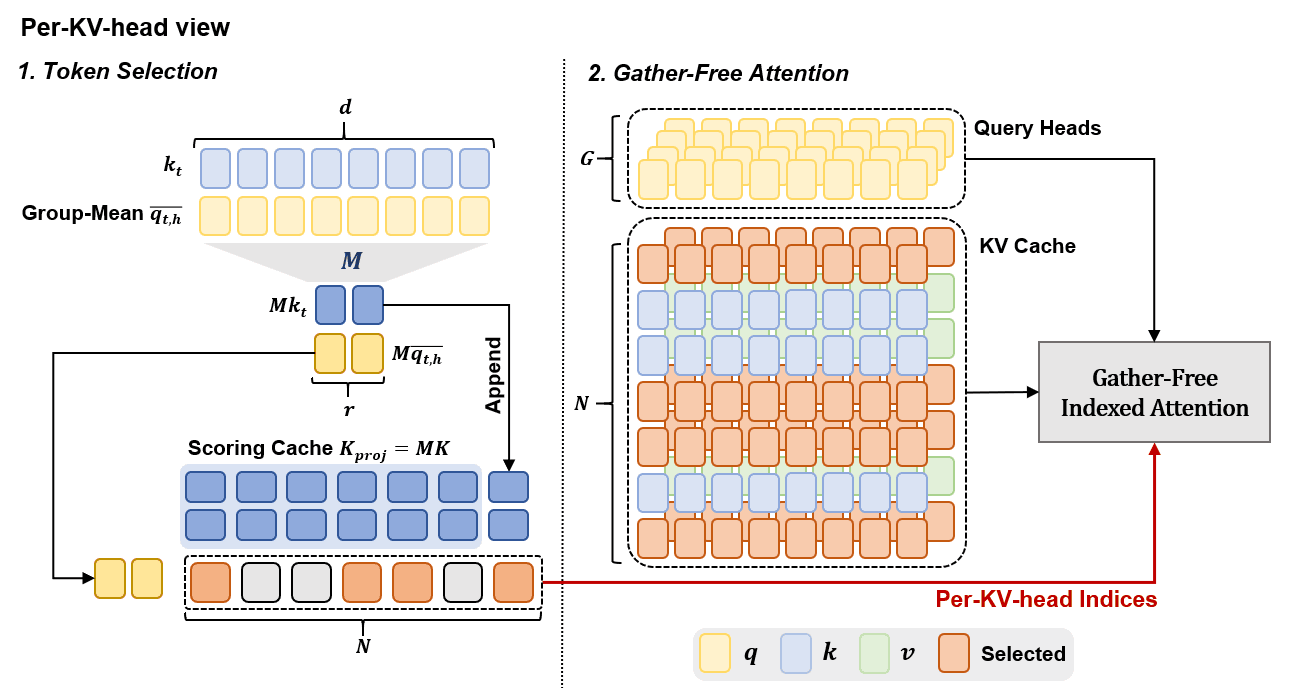
JSSA, uzun bağlamda KV önbellek trafiğini azaltmak için token düzeyinde seçimi optimize eder. Düşük boyutlu alt uzay öğrenimi ve toplama işlemi gerektirmeyen çekirdek tasarımı, gecikme avantajını korurken doğruluğu tam KV dikkatine yakın tutar. NVIDIA B200 üzerinde 128K bağlamda 6.43 kat hızlanma sağlanır.
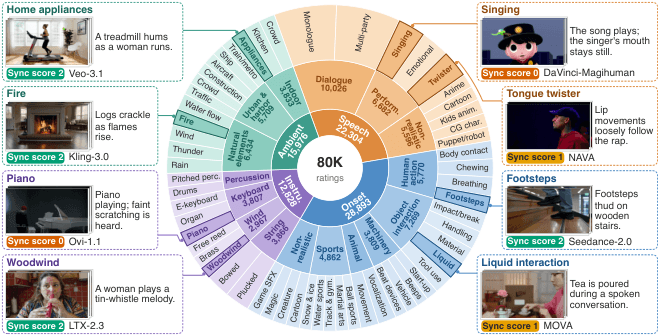
SyncReward, ses-görüntü üretimindeki senkronizasyon sorununu çözmek için insan hizalı bir ödül modeli sunuyor. Çalışma, 80K profesyonel puan içeren SyncReward-Data-80K veri seti ve 1K klipten oluşan SyncReward-Bench'i tanıtıyor. Model, semantik-zamanlayıcı karşıtlı ön eğitim ve insan denetimiyle eğitiliyor. Değerlendirme metriği olarak insan yargısıyla en yüksek uyumu sağlarken, ödül olarak pekiştirmeli öğrenme ile üretim kalitesini artırıyor.
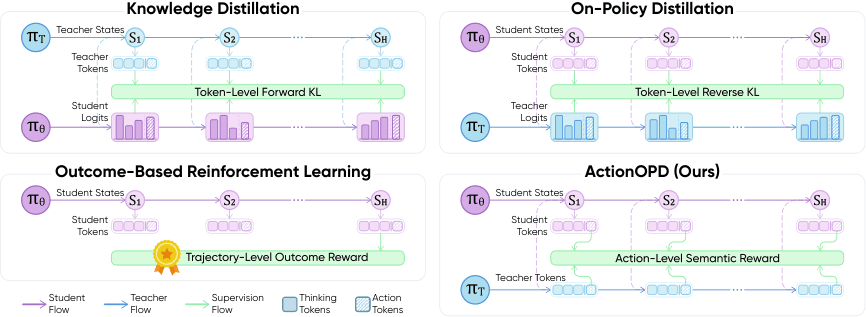
ActionOPD, dil model ajanlarını daha küçük modellere aktarırken token düzeyi yerine semantik karar düzeyinde hizalama yapan yeni bir on-policy distillation yöntemidir. Öğretmen modelin token olasılıklarına veya aynı tokenizer'a ihtiyaç duymadan, öğrenci modelin karşılaştığı durumlarda semantik uyum ödülleriyle eğitim yapar. Qwen3-4B ve Qwen3-8B modellerinde dağıtım dışı benchmark'larda ortalama 3.3-6.9 puanlık iyileşme göstermiştir.
Bu çalışma, off-policy RLVR'de token bazlı önem örneklemesini Proximal KL düzenlemesiyle birleştirir. Teorik kanıtlar, tam gelecek KL kredisinin policy gradient sapmasını ortadan kaldırdığını gösterir. Qwen3 modellerinde GRPO'ya kıyasla daha yüksek doğruluk ve kararlılık elde edilir.
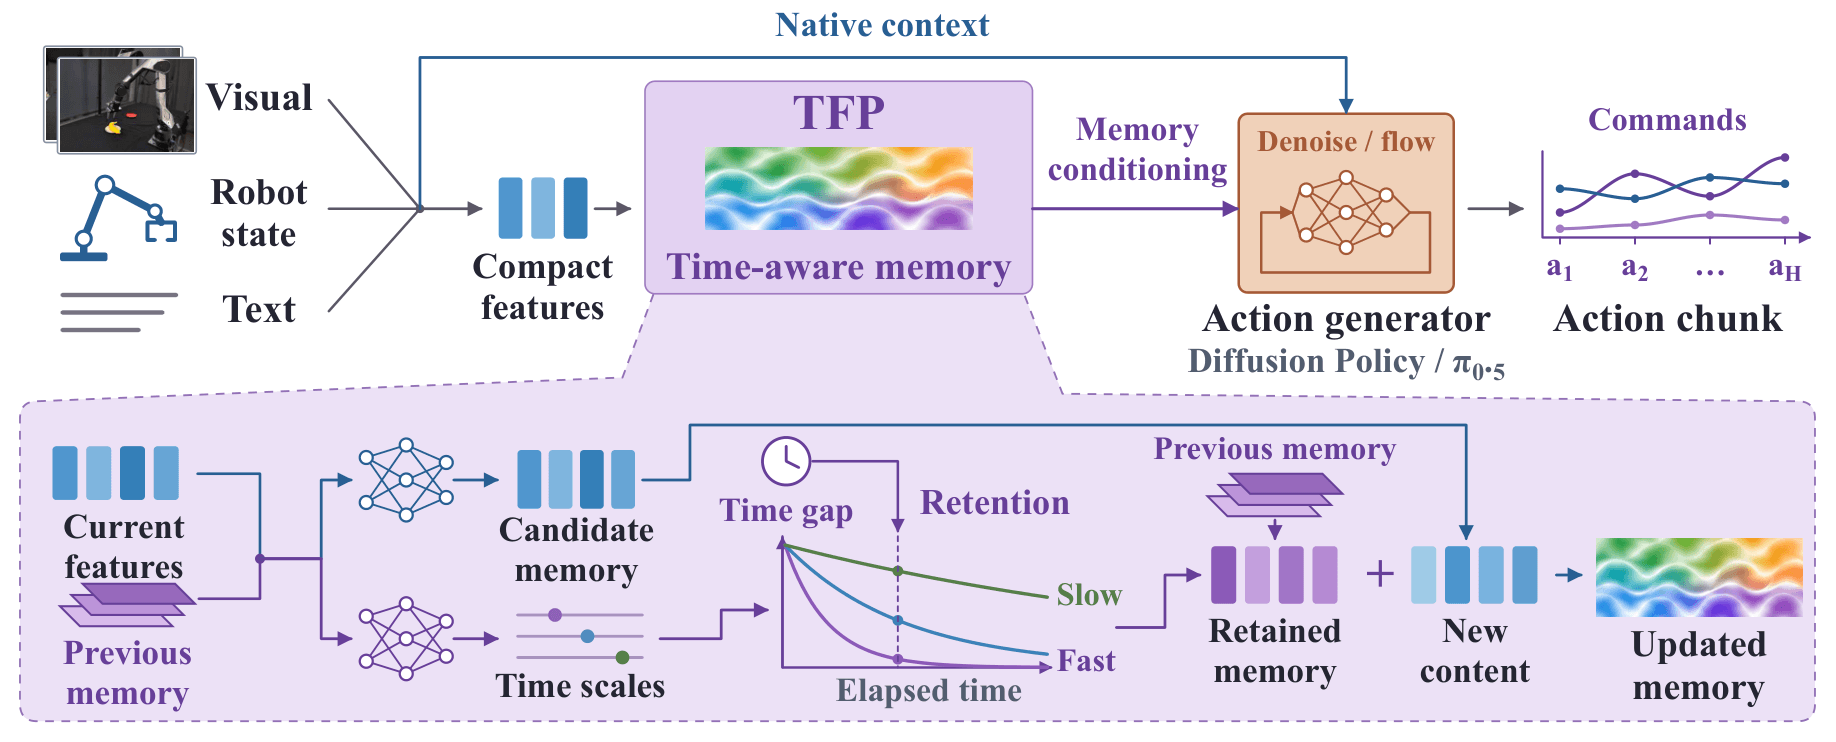
Bu çalışma, robot politika hafızalarında fiziksel zamanın eksik boyut olduğunu öne sürüyor. TFP yöntemi, hafıza dinamiklerini ölçülen zaman aralıklarına göre evriltiyor. Diffusion Policy ve π0.5 ile yapılan testlerde, zamanlama hassasiyetinin hem ölçülen aralıklara hem de saklanan geçmişe bağlı olduğu gösteriliyor. Bu yaklaşım, manipülasyon görevlerinde daha tutarlı davranışlar sağlıyor.
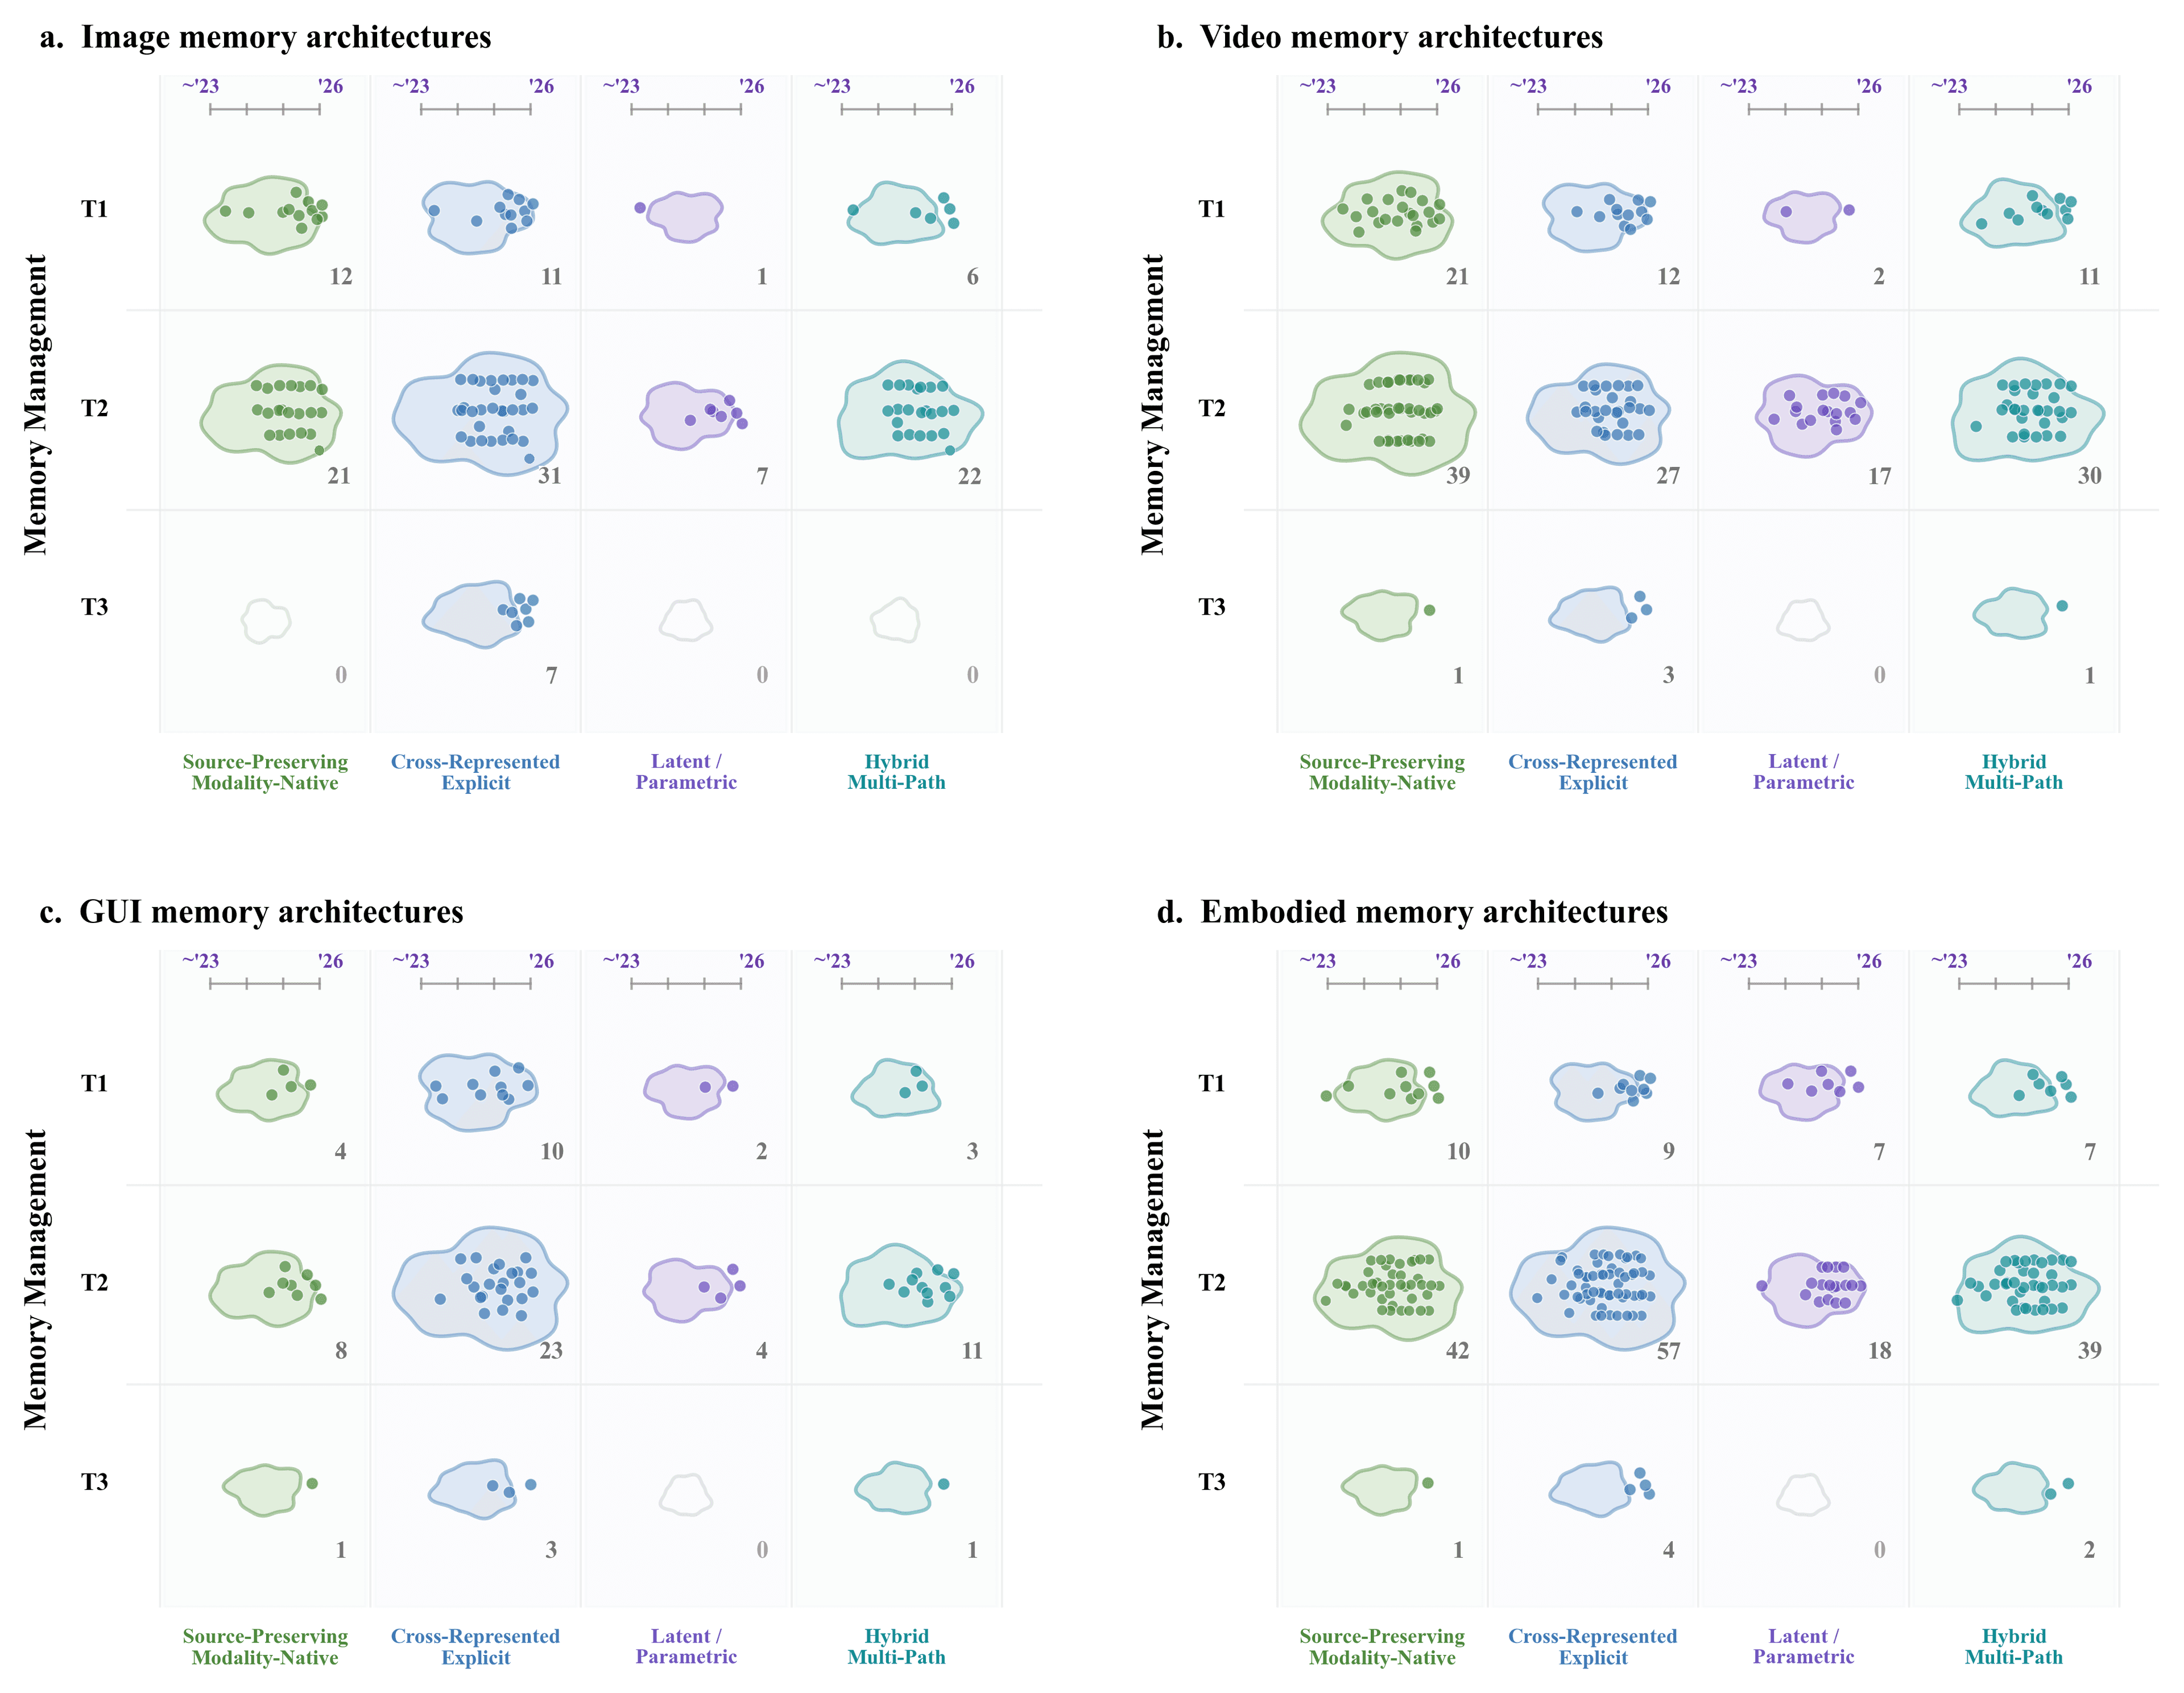
arXiv'de yayımlanan bu çalışma, çok modlu yapay zeka ajanlarının karmaşık verilerden sürekli bilgi edinme sorununu ele alıyor. Oluşturma-temsil ve hafıza yönetimi eksenlerinde iki boyutlu bir analiz çerçevesi sunarak, statik, dinamik ve kendini evrimleştiren hafıza politikalarını sınıflandırıyor.
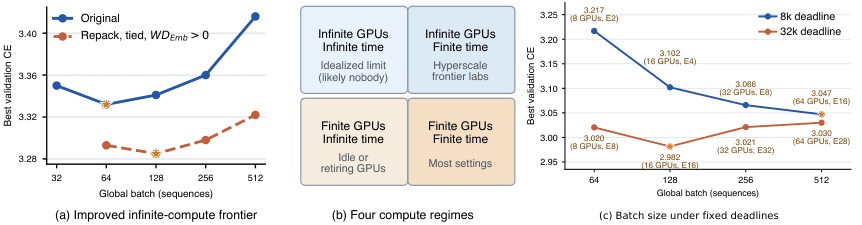
Sınırlı benzersiz veri ve bol hesaplama gücü koşullarında tekrarlı ön eğitimi inceleniyor. Parti boyutu ve epoch sayısının birlikte optimizasyonu, küçük partilerin dolaylı düzenleme etkisiyle daha iyi doğrulama kaybı sağladığını gösteriyor. GPU ve zamanın ayrı kaynaklar olarak ele alınması, geleneksel veri paralelliği pratiklerini sorgulatıyor.
Araştırma, LLM ajanlarının araç çağrılarını doğrulayan yargıç modellerinin, girdilerinde açık bir referans bulunmayan doğru değerleri reddetme eğiliminde olduğunu gösteriyor. Bu 'türetme boşluğu', varsayılan veya çıkarılan değerlerde belirginleşiyor. DeRef yöntemi, yargıç için ayrı bir referans metni oluşturarak bu sorunu azaltıyor ve doğrulama performansını artırıyor.
Görsel üretken modellerde, eğitim görüntüleri arasındaki kod uzayının açıkça denetlenmesi öneriliyor. InterpTok, bu boşlukta kalan karışımları doğal görüntülere dönüştürmek için ayrıştırıcı tabanlı bir yöntem sunuyor. Yaklaşım, interpolasyon kalitesini üç kat artırırken difüzyon modelinin FID skorunu 11.61'den 8.48'e düşürüyor.
arXiv1 dk okuma
13–24 / 42 yayın
Nasıl hazırlıyoruz?
Kaynağı belli. Sınırları açık.
Resmî duyuruları, araştırma makalelerini ve açık kaynak projelerinin sürüm notlarını yapay zekâ ile Türkçe özetliyoruz. Her haberde kaynak bağlantılarına, kullanım alanlarına ve açıklanmayan noktalara yer veriyoruz.
Doğrudan kaynak
Araştırma makalesine, model duyurusuna veya projenin deposuna haberden ulaşabilirsiniz.
Bulgular ve yorumlar
Kaynakta açıklanan sonuçları, olası kullanım alanları ve bilinmeyenlerden ayrı sunuyoruz.
Görsellerin kaynağı
Görsel ve videoların kaynağını belirtiyoruz. Konuyu anlatmak için kullanılan illüstrasyonları da işaretliyoruz.
Araştırma kaynakları
Makaleleri kendiniz keşfedin.
Yeni çalışmalar bulabileceğiniz dizinler ve araştırma laboratuvarları. Bir görsel özet ilginizi çekerse sonuçları özgün makaleden okuyun.