Off-policy RLVR'de token bazlı önem örneklemesi ve Proximal KL düzenlemesi
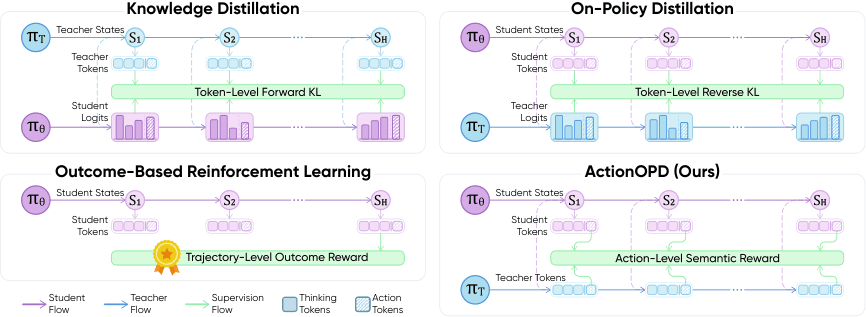
Bu çalışma, off-policy RLVR'de token bazlı önem örneklemesini Proximal KL düzenlemesiyle birleştirir. Teorik kanıtlar, tam gelecek KL kredisinin policy gradient sapmasını ortadan kaldırdığını gösterir. Qwen3 modellerinde GRPO'ya kıyasla daha yüksek doğruluk ve kararlılık elde edilir.

Bu yazıda
Ne değişti?
Token bazlı ağırlıklandırma, tam yanıt olasılık oranlarını çarpmadan policy gradient sapmasını düzeltir ve tek durağan politikayı garanti eder.
Proximal KL, yedi off-policy karşılaştırmada GRPO'yu matematiksel doğrulukta en fazla 2.58% ile geride bırakarak daha kararlı eğitim sağlar.
Neden önemli?
Çalışma, off-policy verilerin neden olduğu policy gradient sapmasını teorik olarak çözer. Proximal KL, PPO kırpma yerine sınırlı gelecek KL kredisi kullanarak eğitim kararlılığını artırır ve eski politikalarla karışık verilerde bile doğru güncelleme sağlar.
Geliştirici için ne anlama geliyor?
Bu yöntem, PPO kırpma yerine sınırlı gelecek KL kredisi kullanarak off-policy eğitimde kararlılığı artırır. Geliştiriciler, Qwen3 modellerinde GRPO'ya kıyasla daha yüksek doğruluk elde edebilir; ancak sonuçlar matematiksel görevlere ve küçük ölçekli testlere özgüdür.
Henüz neyi bilmiyoruz?
- Sonuçlar yalnızca Qwen3-1.7B ve Qwen3-4B modelleri ile matematiksel görevlerde test edilmiştir.
- Yakınsama kanıtları sürekli zamanlı tablo güncellemeleri ve ek varsayımlara dayanır.
Haberin kaynakları
Birincil kaynakEnabling Token-wise Importance Sampling in Off-Policy RLVR with Proximal KL Regularizationarxiv.org Araştırma keşfiHugging Face Daily PapersÖzgün sayfayı açYayın tarihleri
- blue'og yayını
- Kaynak yayını
Bu yazı, bağlantılı kaynaklar okunarak yapay zekâ ile hazırlandı. Kaynaktaki bulguların yanı sıra kullanım alanları ve açıklanmayan noktalar da yer alır. Kapak, konuyu anlatan bir illüstrasyondur. En güncel ayrıntılar için kaynakları inceleyebilirsiniz.