VASPO: Özel Değer Tahminiyle Kendi Kendine Damıtma
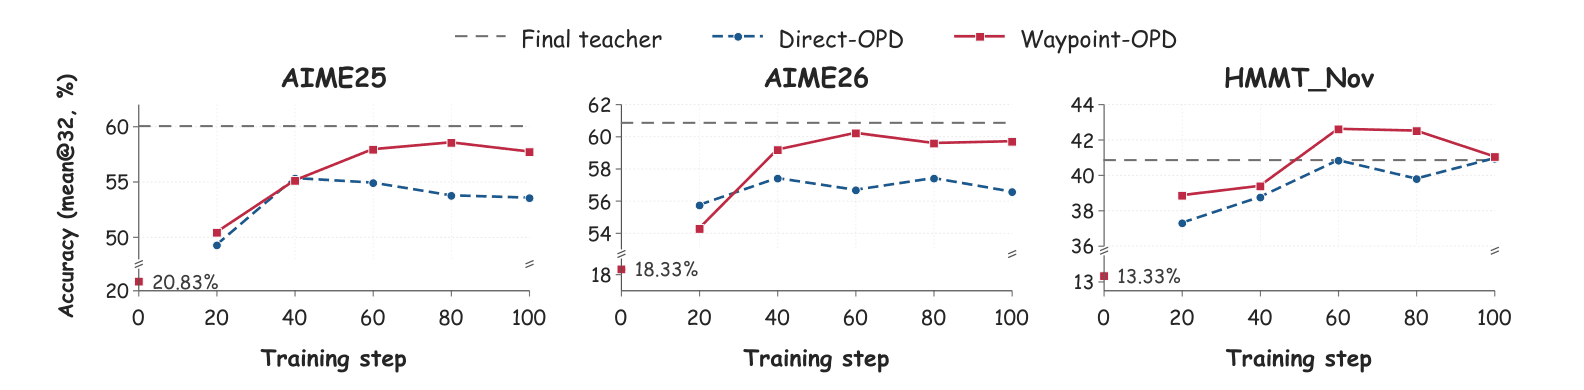
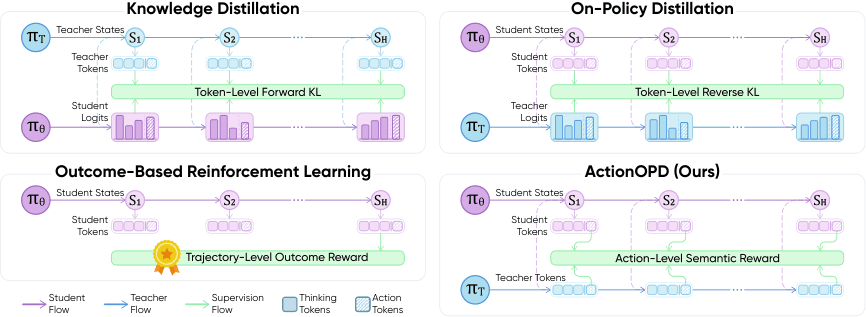
VASPO, akıl yürütme modellerinde kendi kendine damıtma ile PPO'yu birleştirerek özel değer tahmini kullanır. Eleştirmen ve kendi öğretmen, öğrenci tarafından üretilen öneklerde aynı özel bilgiyi değerlendirir. Bu yöntem, matematiksel görevlerde PPO'ya kıyasla anlamlı doğruluk iyileşmeleri göstermiştir.

Bu yazıda
Ne değişti?
Özel bilgi eleştirmenin yanıt sonundaki değer tahminini güçlendirirken, kendi öğretmen rehberliği başlangıçta güçlü olup ortada düşer.
VASPO, Qwen3-4B ve OLMo3-7B modellerinde PPO'ya kıyasla sırasıyla 2.59 ve 1.81 puanlık ortalama doğruluk artışı sağladı.
Neden önemli?
Mevcut yöntemler genellikle yerel token tercihlerini beklenen getiriyle karıştırır. VASPO, eleştirmen ve öğretmen sinyallerinin üretim sırasında farklı konumlarda etkili olduğunu göstererek daha tutarlı bir güncelleme yönü sunar. Bu ayrım, küçük modellerin akıl yürütme kapasitesini daha verimli geliştirmeyi hedefler.
Geliştirici için ne anlama geliyor?
PPO tabanlı eğitimde eleştirmen ve öğretmen sinyallerini konuma göre ayıran bu yaklaşım, küçük ölçekli akıl yürütme modellerinde doğruluğu artırabilir. Ancak sonuçlar yalnızca matematiksel görevlerde ve iki model ailesinde test edildiği için genel geçerliliği henüz kanıtlanmamıştır.
Henüz neyi bilmiyoruz?
- Sonuçlar yalnızca altı matematiksel akıl yürütme benchmark'ında ve iki farklı model boyutunda raporlanmıştır.
- Yöntemin uzun metin üretimi veya genel dil görevlerindeki performansı bu çalışmada değerlendirilmemiştir.
Haberin kaynakları
Birincil kaynakVASPO: Self-Distillation with Privileged Value Estimationarxiv.org Araştırma keşfiHugging Face Daily PapersÖzgün sayfayı açYayın tarihleri
- blue'og yayını
- Kaynak yayını
Bu yazı, bağlantılı kaynaklar okunarak yapay zekâ ile hazırlandı. Kaynaktaki bulguların yanı sıra kullanım alanları ve açıklanmayan noktalar da yer alır. Görsel ve videoların kaynakları üzerlerinde belirtilir; hakları sahiplerine aittir. En güncel ayrıntılar için kaynakları inceleyebilirsiniz.