TokenGate, uzun bağlam girişlerinde dil modellerinin tüm tokenları işlemesiyle oluşan yüksek maliyeti azaltmak için tasarlanmış, uçtan uca öğrenilebilir token budama bileşenidir. Mixture-of-Experts ilhamlı token-gated attention mekanizması sayesinde, prefill aşamasında önemli ölçüde hızlanma ve bellek tasarrufu sağlar.
OpenVLHarness, çok modlu büyük dil modelleri için araç kullanımı ve kalıcı görsel bellek sunan bir çerçevedir. Heterojen araç çıktılarını modelin okuyabileceği gözlemlere dönüştürerek 22 test setinde ortalama skorları 9.7-12.6 puan artırır. GPT-6 Luna ile orta çaba seviyesinde rakip sistemlere göre daha düşük token maliyetiyle üstün performans sağlar.
DisaggKD, bilgi damıtmasında öğretmen ve öğrenci modellerini farklı düğümlere dağıtarak bellek kısıtlamalarını aşan bir yöntem sunar. Tam sözlük logitlerini oluşturmadan tam sözlük kaybına eşdeğer sonuç veren birleşik bir kayıp fonksiyonu kullanır. Qwen3.5-35B-A3B'den 9B'ye damıtma testinde, yerleşik çalıştırmayla aynı dil modeli kaybını elde ederken daha hızlı eğitim sağladı. Büyük model çiftlerinde, yerleşik düzen bellek hatası verirken ayrık düzen eğitim yapabildi.
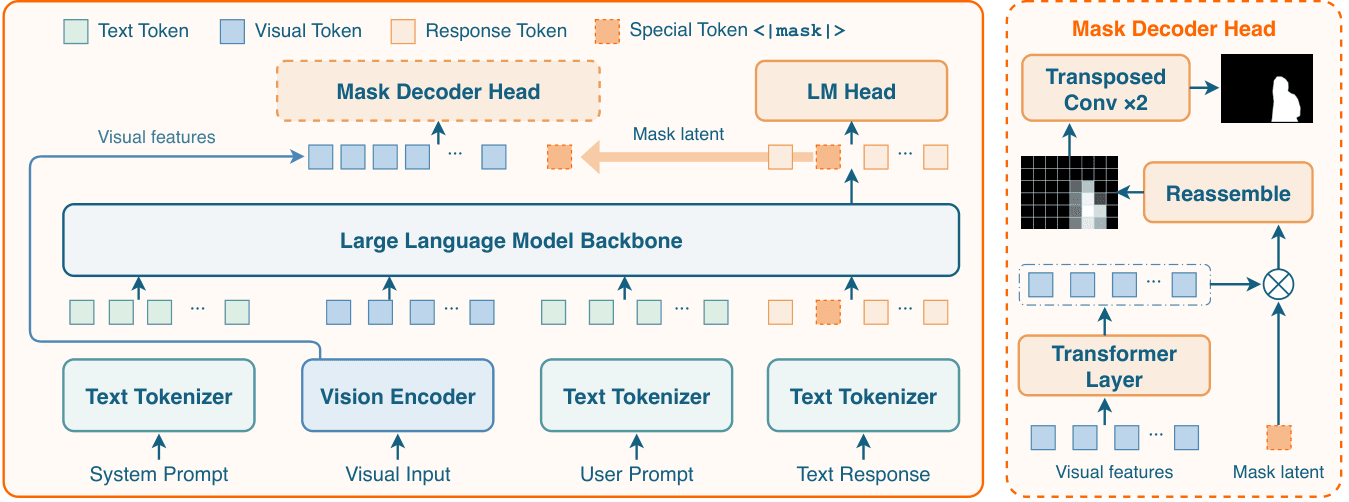
Xiaomi-Lens-0, Qwen3.5 tabanlı 4B parametreli bir çok modlu büyük dil modelidir. Model, görsel temsillerinden maske tahmin ederek ince taneli bölge anlayışını geliştirir. Hafif bir çözücü, görsel kodlayıcı yama özelliklerini ve dil modelinin maske token durumlarını birleştirir. Bu sayede model, akıl yürütme sırasında bölgeye özgü görsel gizli değişkenleri kullanabilir. RefCOCO serisi test setlerinde Qwen3.5'e kıyasla ortalama 5.6 puanlık bir iyileşme sağlanmıştır.
Mosaic, çok oturumlu ajan pekiştirmeli öğrenme için eleştirmansız hiyerarşik optimizasyon öneriyor. Yöntem, oturum katkılarını ayırt ederek avantaj tahminini şekillendiriyor. BrowseComp üzerinde Qwen3.5-4B ile test edilen model, yayınlama yöntemine göre daha az oturumla daha iyi sonuçlar aldı.
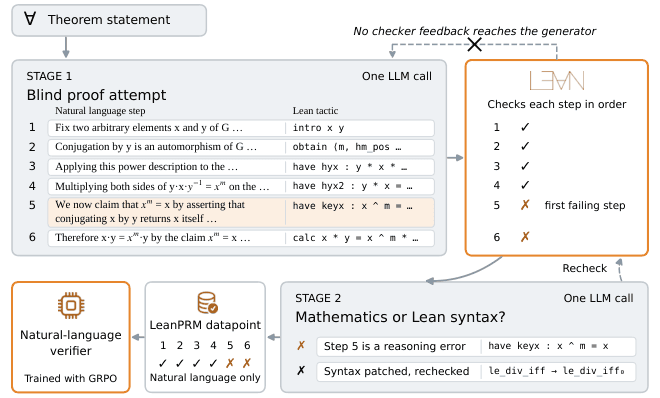
LeanPRM, doğal dilde yazılan matematiksel kanıtların adım adım doğrulanması için Lean kanıt asistanını kullanan bir çerçevedir. İnsan etiketi gerektirmeden 152K etiketli adım üretir. Bu veriyle eğitilen doğrulayıcılar, mevcut yöntemlere kıyasla daha yüksek doğruluk oranları elde eder ve IMO seviyesindeki problemlerde daha iyi kanıt seçimi yapar.
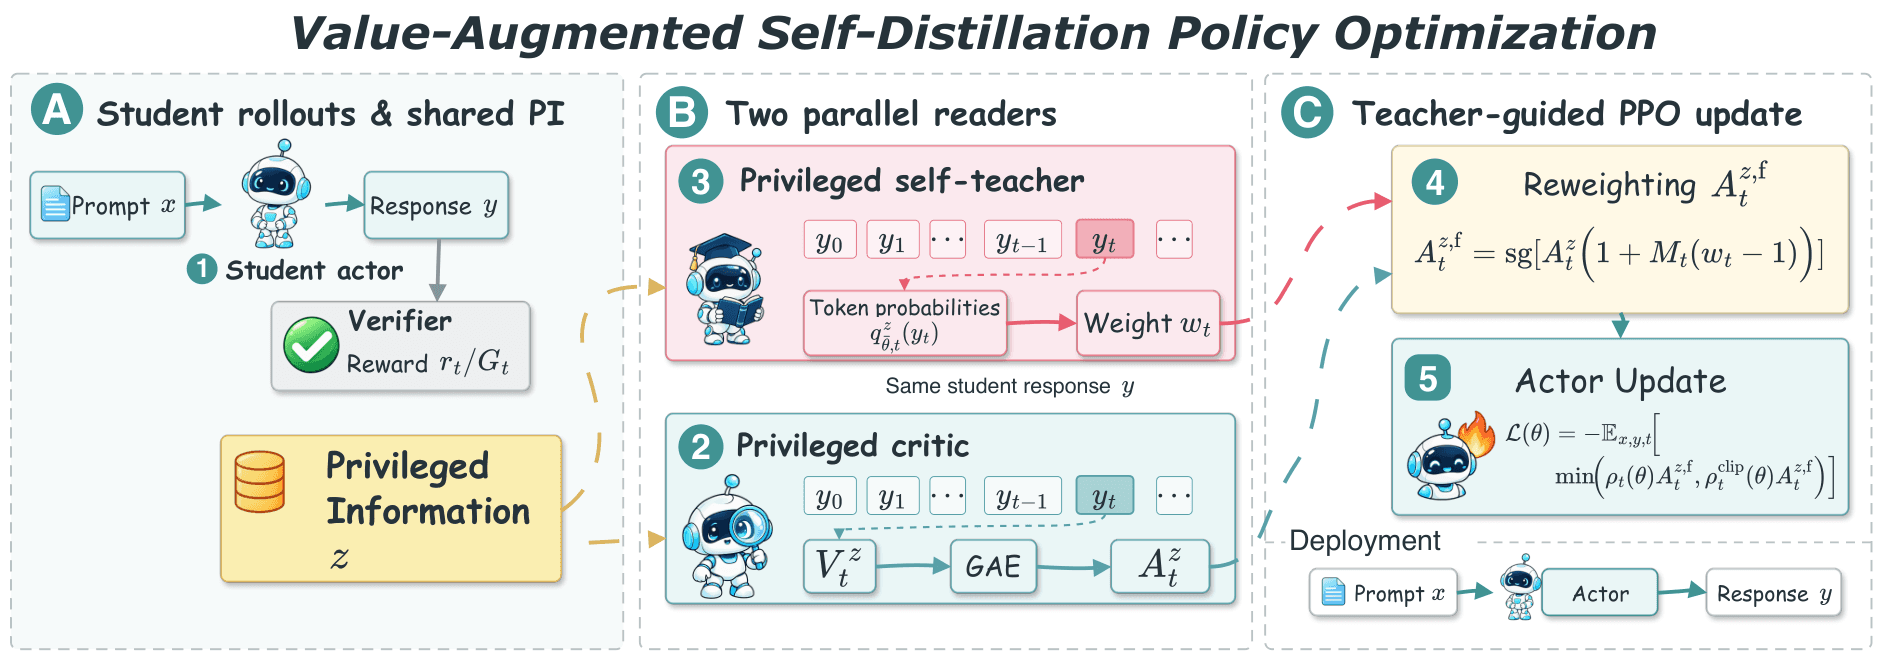
VASPO, akıl yürütme modellerinde kendi kendine damıtma ile PPO'yu birleştirerek özel değer tahmini kullanır. Eleştirmen ve kendi öğretmen, öğrenci tarafından üretilen öneklerde aynı özel bilgiyi değerlendirir. Bu yöntem, matematiksel görevlerde PPO'ya kıyasla anlamlı doğruluk iyileşmeleri göstermiştir.
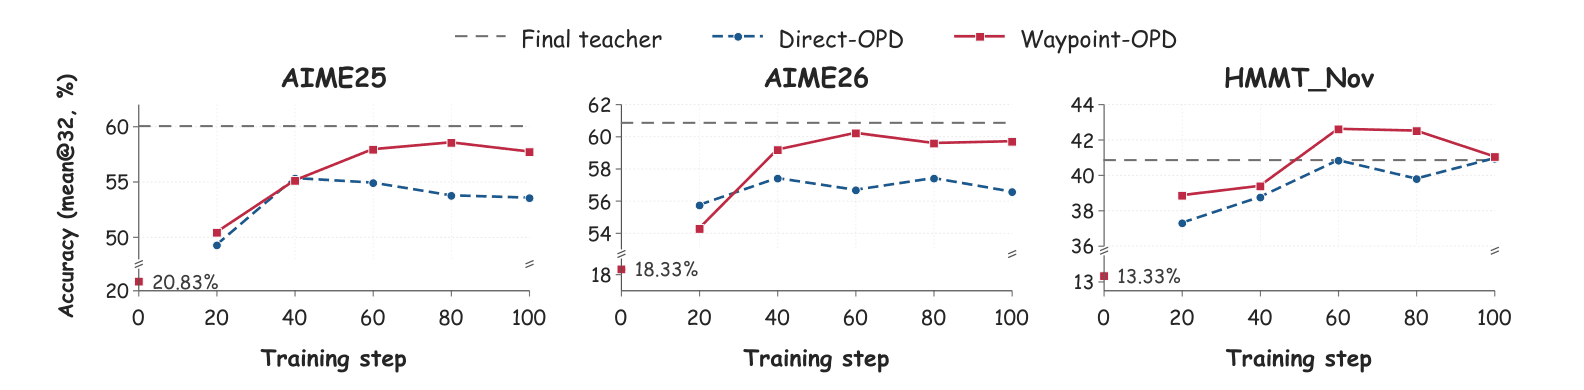
Waypoint-OPD, pekiştirmeli öğrenme sonrası oluşan politika kaymasını aktarırken, erken ve geç kaymalar arasındaki tutarlılığı ölçerek seçici bir filtreleme uygular. Bu yaklaşım, çelişkili sinyalleri bastırarak öğrenci modellerin matematik ve kod akıl yürütme performansını, uç nokta bazlı yöntemlere göre daha istikrarlı bir şekilde artırır.
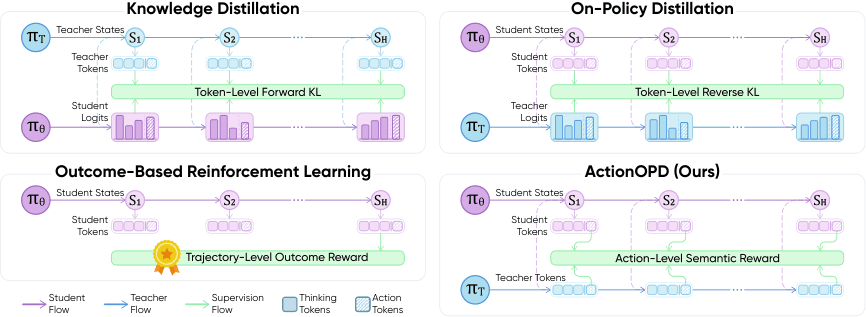
ActionOPD, dil model ajanlarını daha küçük modellere aktarırken token düzeyi yerine semantik karar düzeyinde hizalama yapan yeni bir on-policy distillation yöntemidir. Öğretmen modelin token olasılıklarına veya aynı tokenizer'a ihtiyaç duymadan, öğrenci modelin karşılaştığı durumlarda semantik uyum ödülleriyle eğitim yapar. Qwen3-4B ve Qwen3-8B modellerinde dağıtım dışı benchmark'larda ortalama 3.3-6.9 puanlık iyileşme göstermiştir.
Bu çalışma, off-policy RLVR'de token bazlı önem örneklemesini Proximal KL düzenlemesiyle birleştirir. Teorik kanıtlar, tam gelecek KL kredisinin policy gradient sapmasını ortadan kaldırdığını gösterir. Qwen3 modellerinde GRPO'ya kıyasla daha yüksek doğruluk ve kararlılık elde edilir.
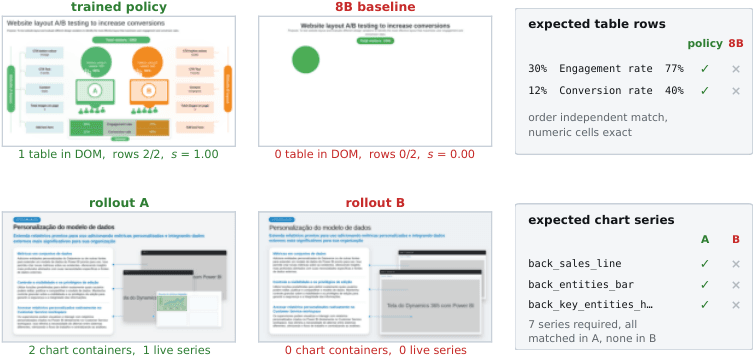
AesCode, görsel tasarım kodu üretirken içerik promptuna dayalı kod üretimi ile aynı prompttan üretilen görseli estetik rehber olarak kullanır. Tasarım grafiği üzerinden ayrıştırılabilir özellikler için deterministik doğrulayıcılar, ayrıştırılamayanlar için VLM yargıcı ile ödül üretir. Bu ayrık ödüllendirme, görsel kaliteyi ve doğrulanabilirliği birlikte artırır.
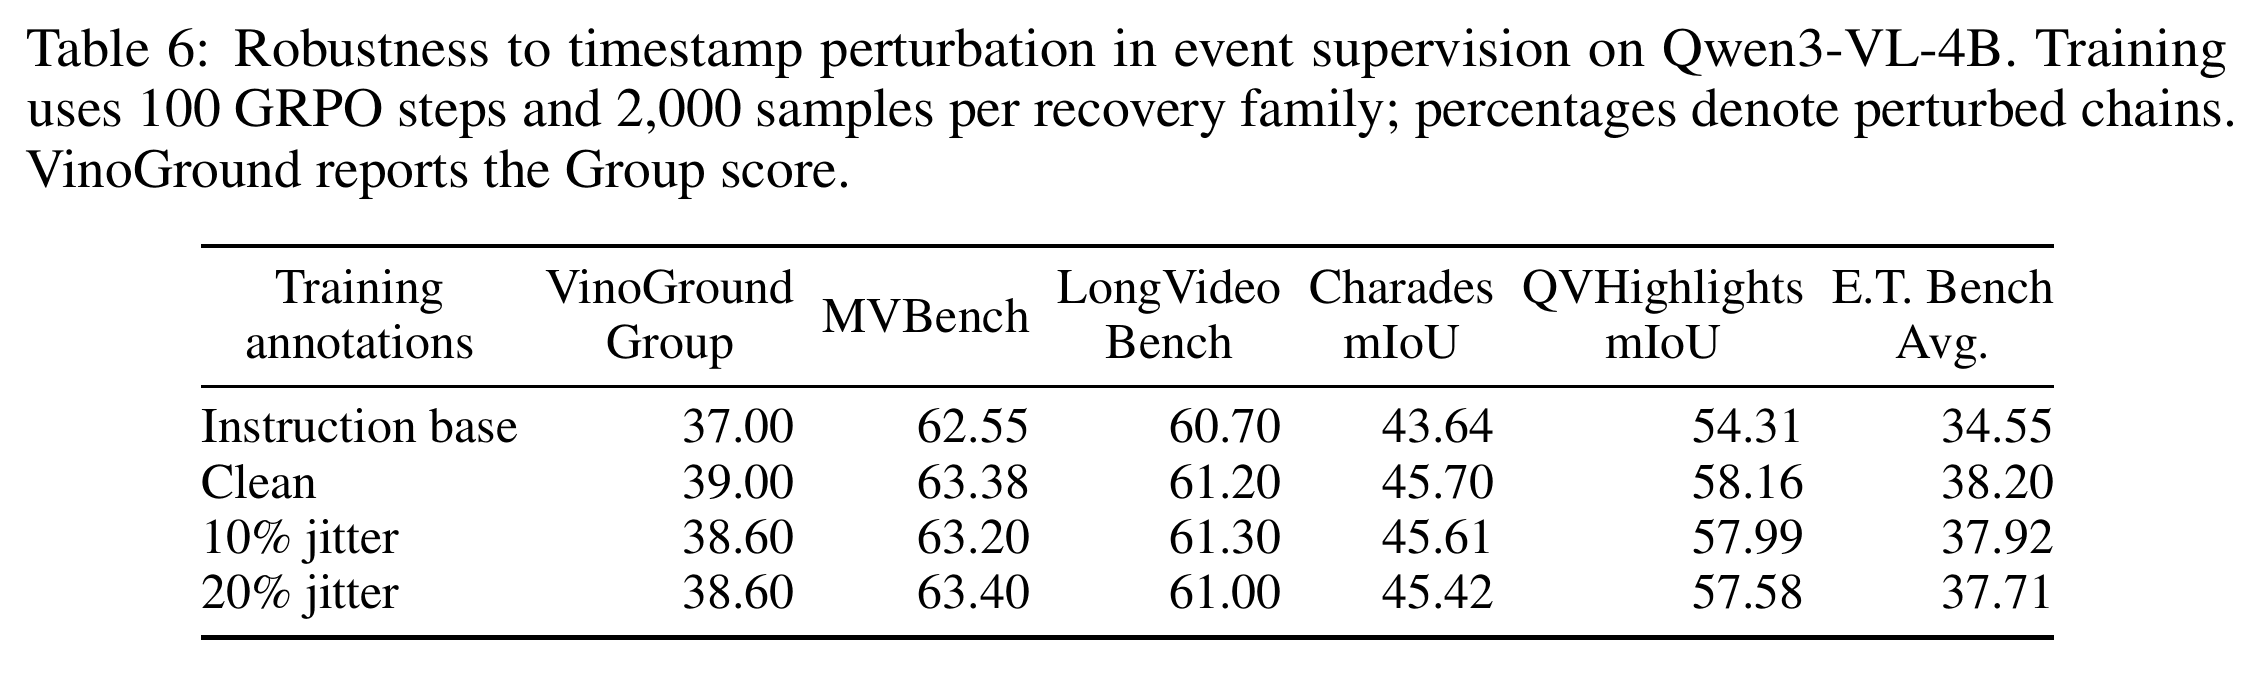
EventLens, video anlama modellerinin zaman yapısını yeniden kurma yeteneğini geliştirmek için görsel odaklı pekiştirmeli öğrenme kullanır. Model, olay sınırlarını ve ilişkilerini dil kısayolları yerine görsel kanıtlarla öğrenir. Bu yöntem, insan etiketi gerektirmeyen deterministik ödüllerle eğitim sağlar.
arXiv1 dk okuma
1–12 / 16 yayın
Nasıl hazırlıyoruz?
Kaynağı belli. Sınırları açık.
Resmî duyuruları, araştırma makalelerini ve açık kaynak projelerinin sürüm notlarını yapay zekâ ile Türkçe özetliyoruz. Her haberde kaynak bağlantılarına, kullanım alanlarına ve açıklanmayan noktalara yer veriyoruz.
Doğrudan kaynak
Araştırma makalesine, model duyurusuna veya projenin deposuna haberden ulaşabilirsiniz.
Bulgular ve yorumlar
Kaynakta açıklanan sonuçları, olası kullanım alanları ve bilinmeyenlerden ayrı sunuyoruz.
Görsellerin kaynağı
Görsel ve videoların kaynağını belirtiyoruz. Konuyu anlatmak için kullanılan illüstrasyonları da işaretliyoruz.
Araştırma kaynakları
Makaleleri kendiniz keşfedin.
Yeni çalışmalar bulabileceğiniz dizinler ve araştırma laboratuvarları. Bir görsel özet ilginizi çekerse sonuçları özgün makaleden okuyun.